Architektura transformera i mechanizm atencji - przewodnik
Przejdź do treści i przykładów
Źródło: Link
Źródło: Link
Mind Architect to 180-dniowy program Jana Gajosa: decyzje, nawyki i granice przeniesione do codziennych reakcji. 180 lekcji w 6 modulach, Manfred AI Coach i powtorki rozlozone w czasie.
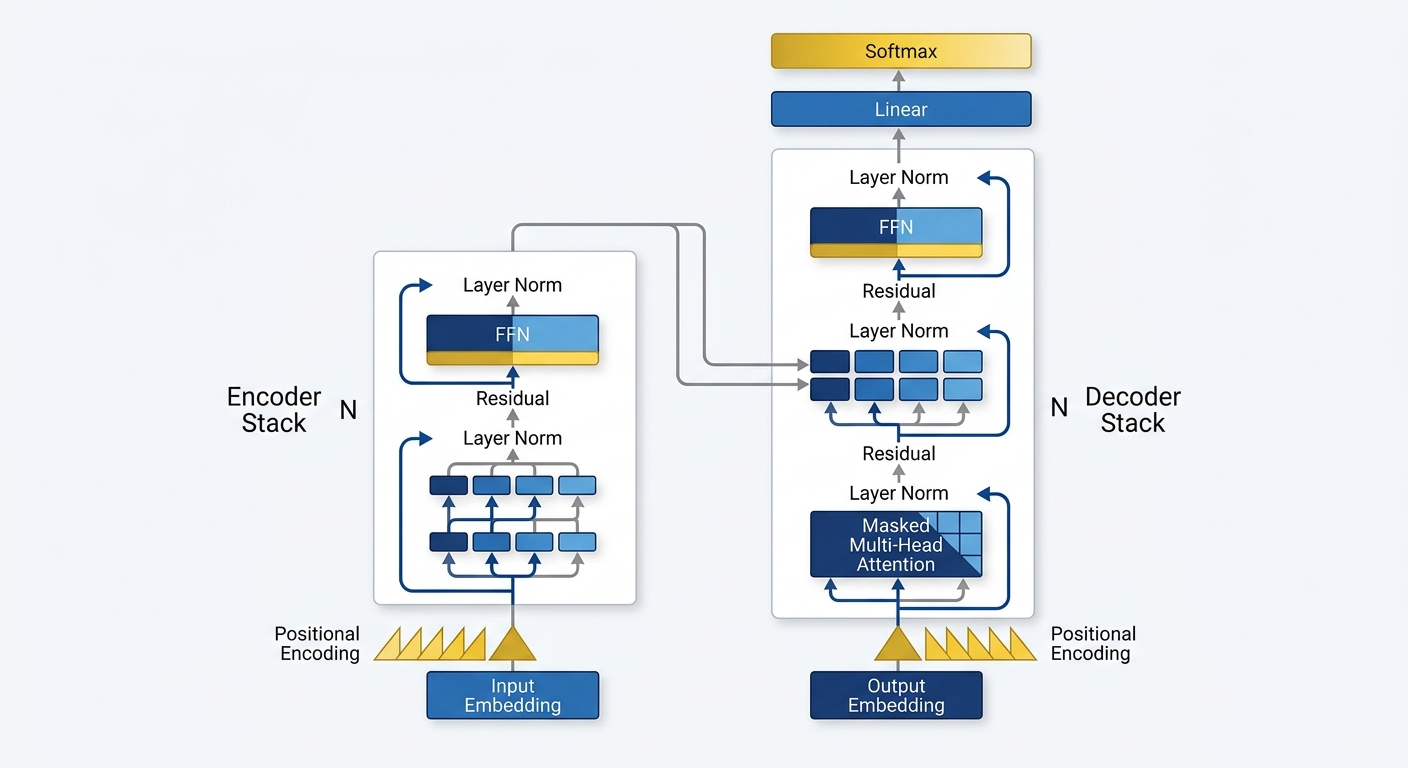
Architektura transformera to sposób budowy sieci neuronowej opisany w 2017 roku w pracy "Attention Is All You Need". Oryginalny transformer ma dwie części: enkoder, który czyta wejście, i dekoder, który generuje wynik - każda złożona z 6 identycznych warstw. W każdej warstwie pracuje mechanizm atencji (ang. attention, po polsku także "uwaga") i prosta sieć, która przetwarza każdy token osobno. Atencja działa tak: dla każdego tokenu model liczy zapytanie (query), klucz (key) i wartość (value), porównuje zapytanie z kluczami wszystkich tokenów w tekście (także z własnym) i z tych porównań składa średnią ważoną ich wartości. Dzięki temu każde słowo "wie", które inne słowa w tekście są dla niego ważne.
Aktualizacja 13.10.2026: zaktualizowaliśmy przykłady modeli do stanu na 13.10.2026, poprawiliśmy opisy RoPE, adaptacyjnej atencji i atencji niskiego rzędu oraz usunęliśmy porównania kosztów modeli bez źródła. Jeśli dopiero zaczynasz, najpierw przeczytaj przewodnik po transformerach dla nietechnicznej osoby.
Przewodnikiem jest przegląd "The Transformer Family Version 2.0" Lilian Weng (blog Lil'Log, styczeń 2023). Bez wzorów, z przykładami - a tam, gdzie od 2023 roku coś się zmieniło, dopisujemy stan z lat 2025-2026.
Transformer opisał w czerwcu 2017 roku zespół badaczy, głównie z Google, pierwotnie do tłumaczenia maszynowego. Szybko okazało się, że do wielu zadań wystarczy jego połowa: sam enkoder (tak zbudowany jest BERT) albo sam dekoder (tak zbudowane są modele GPT) - więcej w poradniku jak transformery AI rozwiązują zadania.
Na transformerze stoją dzisiejsze duże modele językowe: litera T w skrócie GPT to właśnie Transformer, Google opisuje Gemini 3 Pro (bazę obecnego Gemini 3.1 Pro) jako model Mixture-of-Experts oparty na transformerze, a Anthropic w pracy z 2025 roku o wnętrzu jednego z modeli Claude opisuje badany model jako model językowy oparty na transformerze. Szczegółów budowy najnowszych modeli zamkniętych, jak rodzina GPT-6 czy Claude Opus 5.5 i Fable 5.1 (stan na 13.10.2026), producenci nie publikują, więc nie przypisujemy im konkretnych mechanizmów.
Kluczowa różnica wobec starszych sieci rekurencyjnych (RNN, LSTM): tamte czytały tekst słowo po słowie i całą historię upychały w jednym, ciągle nadpisywanym stanie. Transformer przetwarza wszystkie tokeny, które ma przed sobą, równolegle, a powiązania między nimi liczy mechanizm atencji.
Piszesz zdanie: "Kot siedział na macie, bo była miękka." Model musi powiązać "była" z "matą", a nie z "kotem". Mechanizm atencji pozwala mu spojrzeć na pozostałe słowa i obliczyć, które z nich są ważne dla zrozumienia "była".
W praktyce model tworzy trzy reprezentacje każdego tokenu:
Dla słowa "była" model porównuje jego zapytanie z kluczami pozostałych słów. "Mata" dostaje wysoki wynik dopasowania, więc jej wartość mocno wpływa na nową reprezentację słowa "była".
Bez wzoru, ale dokładnie: wynik porównania to iloczyn skalarny zapytania i klucza, podzielony przez pierwiastek z rozmiaru tych wektorów. Funkcja softmax zamienia wyniki na wagi sumujące się do 1, a wynik atencji to suma wartości pomnożonych przez te wagi. W dekoderze, który generuje tekst, przyszłe tokeny są zamaskowane - każdy token widzi tylko te przed sobą.
Zamiast jednego mechanizmu atencji transformer ma kilka równoległych "głów" (heads). Każda liczy atencję osobno, na własnej, mniejszej wersji zapytań, kluczy i wartości, a wyniki są na końcu sklejane. Autorzy oryginalnej pracy zauważyli, że głowy uczą się różnych zadań, a wiele z nich zachowuje się tak, jakby śledziło składnię i znaczenie zdania.
Liczba głów to parametr konfiguracji oznaczany literą h: oryginalny transformer miał 8 głów (16 w największej wersji), BERT-base 12, a największy GPT-3 z 2020 roku - 96. Więcej nie znaczy automatycznie lepiej: w pracy z 2017 roku przy tej samej ilości obliczeń i jedna głowa, i zbyt wiele głów dawały gorsze wyniki niż wariant pośredni.
Mechanizm atencji ma jeden problem: nie wie, w jakiej kolejności stały słowa - Weng zwraca uwagę, że to operacja na zbiorze, a nie na sekwencji. Zdania "Najpierw przeczytaj, potem podpisz" i "Najpierw podpisz, potem przeczytaj" mają te same słowa i przeciwny sens. Dlatego transformery dodają kodowanie pozycji (positional encoding), czyli informację o tym, gdzie w tekście stoi każdy token.
Oryginalny transformer dodawał do wektora każdego tokenu wektor zbudowany z funkcji sinus i cosinus o różnych częstotliwościach - każda pozycja dostaje inny wzór. Pozycje wyuczone (osobny wektor dla każdej pozycji, jak potem w pierwszym GPT) dawały niemal identyczne wyniki, ale autorzy wybrali sinusy, bo mogą pozwolić modelowi radzić sobie z tekstami dłuższymi niż w treningu. Późniejsze badania tego nie potwierdziły: autorzy metody ALiBi (2021) pokazali, że modele z kodowaniem sinusoidalnym w praktyce bardzo słabo radzą sobie z tekstami dłuższymi od treningowych.
RoPE (2021) nie dodaje pozycji do wektora słowa, tylko "obraca" wektory zapytań i kluczy o kąt zależny od pozycji, w każdej warstwie atencji. Dzięki temu wynik porównania dwóch tokenów zależy od ich względnej odległości. RoPE stosuje m.in. rodzina LLaMA od Mety (od pierwszej wersji z 2023 roku), a w konfiguracji otwartych modeli Qwen 3 widać jego parametr. Jak wybierać spośród takich modeli, piszemy w przewodniku jak wybrać odpowiedni model językowy.
Uwaga na częsty skrót myślowy: RoPE sam nie załatwia długiego kontekstu - w pracy o ALiBi modele z RoPE też traciły jakość na tekstach dłuższych niż treningowe. Przykład: dla Llama 4 Scout (kwiecień 2025) Meta deklaruje okno 10 mln tokenów, ale podaje, że wstępny trening i dostrajanie odbywały się z kontekstem 256 tys. tokenów. Dłuższe okno Meta przypisuje dodatkowemu etapowi treningu na długich danych i budowie iRoPE - RoPE w większości warstw, przeplatane warstwami atencji bez kodowania pozycji, plus skalowanie "temperatury" atencji przy generowaniu.
Podstawowy transformer ma dwa ograniczenia. Jak pisze Weng, długość tekstu przy użyciu modelu jest ograniczona długością kontekstu z treningu. Do tego koszt rośnie kwadratowo: tekst 2 razy dłuższy to ok. 4 razy więcej obliczeń i pamięci w warstwach atencji. Weng opisuje kilka grup pomysłów na obejście tego.
Transformer-XL (2019) dzieli długi tekst na odcinki i przy kolejnym odcinku korzysta z zapisanych stanów ukrytych z poprzedniego - trochę jak czytanie raportu rozdział po rozdziale z notatkami z poprzedniego rozdziału pod ręką. Compressive Transformer dokłada drugą, skompresowaną pamięć na najstarsze fragmenty.
Inna droga to pamięć zewnętrzna. kNN-LM i Memorizing Transformer wyszukują w osobnym magazynie (z dużym zbiorem tekstów albo z wcześniejszą częścią przetwarzanego tekstu) najbardziej podobne konteksty i dokładają je do obliczeń - podobnie jak systemy RAG wyszukują fragmenty dokumentów, zanim model odpowie.
Zwykły transformer przepuszcza tekst przez stałą liczbę różnych warstw. Universal Transformer (2019) stosuje ten sam blok wielokrotnie, jak pętlę, a mechanizm ACT (adaptive computation time) dla każdej pozycji osobno decyduje, ile przebiegów wystarczy. Nad trudniejszymi fragmentami model "myśli" dłużej, łatwiejsze kończy szybciej.
Nie każdy token wymaga tyle samo pracy. Weng podaje dwie sytuacje: niektórym tokenom wystarczy najbliższy kontekst, a niektóre łatwo przewidzieć bez przechodzenia przez wszystkie warstwy.
W pracy z 2019 roku (Sukhbaatar i in.) każda głowa atencji uczy się własnego zasięgu, czyli tego, jak daleko wstecz patrzy - zasięg należy do głowy, nie do słowa. Autorzy zauważyli, że w niższych warstwach głowy zwykle nie potrzebują długiego zasięgu, a kilka głów w wyższych warstwach sięga wyjątkowo daleko. Efekt: mniej obliczeń i pamięci, więc ten sam sprzęt obsłuży dłuższy kontekst.
Depth-Adaptive Transformer (2020) i CALM (2022) uczą model, po ilu warstwach może zakończyć liczenie danego tokenu. O wcześniejszym wyjściu decyduje klasyfikator dołączony do warstw albo inna miara pewności przewidywania (w CALM np. różnica między dwoma najbardziej prawdopodobnymi kolejnymi tokenami). Łatwe tokeny "wychodzą" wcześniej, trudne przechodzą przez wszystkie warstwy - to oszczędza czas i obliczenia, w CALM nawet do 3 razy.
Dla Ciebie jako użytkownika modelu w chmurze to sprawa dostawcy: w API płacisz za tokeny wejścia i wyjścia, a nie za liczbę warstw, przez które przeszły. Ile to kosztuje w praktyce, pokazujemy w tekście o cenach API Claude dla programistów.
Pełna atencja (każdy token patrzy na każdy) to koszt rzędu L², gdzie L to długość tekstu w tokenach. Przy 100 000 tokenów to 10 mld par do porównania - w każdej głowie i w każdej warstwie. Rzadka atencja (sparse attention) ogranicza, na które tokeny patrzy dany token. Sparse Transformer (2019) zszedł w ten sposób do kosztu rzędu L razy pierwiastek z L, a Longformer (2020) do kosztu rosnącego liniowo.
Najprostsza strategia: każdy token patrzy tylko na sąsiadów w stałym oknie, np. na 128 poprzednich tokenów (liczba przykładowa). Weng wywodzi ten pomysł z Image Transformer (2018), który generował obrazy piksel po pikselu. Koszt rośnie wtedy liniowo z długością tekstu.
Ograniczenie: w pojedynczej warstwie model nie widzi niczego spoza okna. Informacja z dalszych fragmentów dociera dopiero przez kolejne warstwy - autorzy Longformera liczą, że przy l warstwach i oknie o szerokości w tokenów najwyższa warstwa obejmuje l razy w tokenów.
Sparse Transformer łączy dwa wzorce: jedna głowa patrzy na ostatnie l tokenów, druga na co l-ty token wstecz. Przy l = 10 token na pozycji 100 widzi 99, 98, 97... i dodatkowo 90, 80, 70. Model widzi więc lokalny kontekst i odległe fragmenty, tyle że te drugie w niższej rozdzielczości.
Longformer łączy okno lokalne z atencją globalną dla kilku wybranych tokenów (np. specjalnego tokenu [CLS]) - one widzą cały tekst i cały tekst widzi je. BigBird dokłada połączenia z losowymi tokenami. Działa to jak czytanie książki z zakładkami na kluczowych rozdziałach.
Ten pomysł trafił do dużych modeli. W GPT-3 (2020) OpenAI stosowało na przemian warstwy z pełną atencją i z rzadką atencją lokalną. DeepSeek w karcie modelu V4.1 Flash (wrzesień 2026) opisuje rzadką atencję z wyborem Top-K pozycji i kompresję pamięci kluczy i wartości (KV cache) - według producenta pamięć KV na token jest ok. 4 razy mniejsza niż u poprzednika. Szerzej: DeepSeek V4.1 Flash i koszty długiego kontekstu.
Macierz atencji (kto na kogo patrzy) dla L tokenów ma L na L pól. Linformer (2020) pokazał, że da się ją przybliżyć macierzą niskiego rzędu: klucze i wartości są rzutowane z długości L na stałą, małą długość k. Koszt rośnie wtedy liniowo, a w testach autorów jakość była porównywalna ze zwykłym transformerem.
Rachunek: macierz 1000 na 1000 to milion liczb, a dwie macierze 1000 na 64 to 128 tysięcy - prawie 8 razy mniej. To jednak przybliżenie, a nie matematycznie równoważna kopia. Pokrewny pomysł działa w produkcji: Multi-head Latent Attention z DeepSeek-V2 (2024) kompresuje klucze i wartości do mniejszego wektora, co według DeepSeek zmniejszyło pamięć KV o 93,3% względem ich wcześniejszego modelu 67B.
Weng opisuje też transformery w uczeniu ze wzmocnieniem (reinforcement learning). Zamiast słów model dostaje sekwencję stanów, akcji i nagród agenta, np. ruchów w grze. Decision Transformer (2021) traktuje to jak przewidywanie kolejnej akcji: dostaje docelową sumę nagród, wcześniejsze stany i akcje, a generuje akcje, które mają ją osiągnąć. W testach autorów (m.in. gry Atari) dorównywał najlepszym metodom uczenia na wcześniej zebranych danych albo je wyprzedzał.
Nie myl tego z agentami AI z function calling - tam plan układa duży model językowy, który wywołuje narzędzia.
Nie musisz implementować transformerów od zera - do pracy na własnych danych wystarczą gotowe narzędzia (zobacz, jak analizować dane z AI bez programowania). Ta wiedza daje jednak przewagę:
Kiedy czytasz, że nowy model "obsługuje dłuższy kontekst", wiesz już, jakie mechanizmy mogą za tym stać - i o co dopytać.
Masz 50-stronicowy raport. Sprawdź, czy mieści się w oknie modelu, wklej go na początku, a pytanie na końcu. Poproś, żeby model najpierw wypisał dosłowne cytaty, na których oprze odpowiedź - Anthropic zaleca to przy dokumentach powyżej 20 tys. tokenów, bo ogranicza zmyślanie. Jeśli w odpowiedzi brakuje czegoś ze środka dokumentu, zapytaj wprost o ten rozdział albo podziel raport na części. Sama nazwa mechanizmu nie powie Ci, czy model poradzi sobie z Twoim PDF-em.
Transformery, atencja, kodowanie pozycji - te koncepcje brzmią skomplikowanie, ale da się je zrozumieć bez matematyki. Na darmowym webinarze na żywo pokazuję krok po kroku, jak oszczędzać 10 godzin tygodniowo dzięki AI - bez wiedzy technicznej.
Zapisz się na darmowy webinar →Wolisz uczyć się we własnym tempie? Sprawdź kurs AI Evolution
Przegląd Lilian Weng to encyklopedia architektur transformerów - od podstawowej atencji przez kodowanie pozycji po rzadką i niskorzędową atencję. Kluczowe jest to, że każdy mechanizm rozwiązuje konkretny problem: atencja daje kontekst, kodowanie pozycji (w wielu otwartych modelach RoPE) mówi o kolejności, a długi kontekst to suma wielu zabiegów - rzadkiej atencji, kompresji pamięci i treningu na długich tekstach.
Otwórz na Hugging Face stronę dowolnego otwartego modelu i zajrzyj do pliku config.json. W Qwen3-8B znajdziesz m.in. num_hidden_layers 36 (warstwy), num_attention_heads 32 (głowy atencji), num_key_value_heads 8 (głowy kluczy i wartości, współdzielone przez kilka głów zapytań) i rope_theta (parametr RoPE). Teraz wiesz, co te liczby znaczą. Dla modeli zamkniętych, jak Claude czy GPT, dokumentacja z takich liczb podaje zwykle tylko okno kontekstu i limit długości odpowiedzi.
To budowa sieci neuronowej z pracy "Attention Is All You Need" (2017). Oryginał ma enkoder i dekoder, każdy z 6 warstw. Warstwa składa się z wielogłowej atencji i prostej sieci przetwarzającej każdy token osobno, a wokół nich są połączenia rezydualne i normalizacja. Dekoder ma dodatkowo atencję na wyjście enkodera. Modele generujące tekst (np. GPT, Llama) używają zwykle samego dekodera, a modele typu BERT - samego enkodera.
Nie. Matematyka opisuje, "jak" działają transformery na poziomie implementacji. Tobie wystarczy wiedzieć, "co" robią: atencja pozwala modelowi patrzeć na wiele słów naraz, kodowanie pozycji mówi mu o kolejności, rzadka atencja obniża koszty. Reszta to szczegóły implementacyjne.
GPT-2 z 2019 roku miał okno 1024 tokenów, GPT-3 z 2020 roku - 2048, a obecne modele Claude przyjmują 1 mln tokenów (stan na 13.10.2026). Złożyło się na to kilka rzeczy: kodowanie pozycji, które da się rozciągać (RoPE i jego modyfikacje), tańsza atencja (rzadkie wzorce, współdzielone albo kompresowane klucze i wartości) i trening na długich tekstach. Które z tych technik stosują konkretne modele zamknięte, producenci nie ujawniają.
Zwykle nie wprost. Producenci modeli zamkniętych rzadko opisują wariant atencji, modele otwarte robią to w kartach (np. DeepSeek V4.1 Flash używa rzadkiej atencji). W praktyce porównuj modele na własnych zadaniach: jakość na długich dokumentach, czas odpowiedzi i cenę.
Każda głowa liczy atencję osobno, więc więcej głów to więcej równoległych "spojrzeń" na ten sam tekst - jedne mogą śledzić składnię, inne znaczenie. Nowsze modele często współdzielą klucze i wartości między kilkoma głowami (grouped-query attention), bo przyspiesza to generowanie - np. Qwen3-8B ma 32 głowy zapytań i 8 głów kluczy i wartości.
Nie. Transformery działają wszędzie tam, gdzie dane da się ułożyć w sekwencję: tekst, kod, dźwięk, fragmenty obrazu, sekwencje akcji w grach. Mechanizm atencji to ogólna metoda znajdowania zależności w sekwencjach. Modele językowe są tylko najbardziej widocznym zastosowaniem.
Na podstawie: The Transformer Family Version 2.0 - Lilian Weng, Lil'Log (2023), Vaswani i in. - Attention Is All You Need (2017), Su i in. - RoFormer (2021), Press i in. - ALiBi (2021), Meta - The Llama 4 herd (2025), Beltagy i in. - Longformer (2020), Wang i in. - Linformer (2020), Elbayad i in. - Depth-Adaptive Transformer (2020), Schuster i in. - CALM (2022),Brown i in. - GPT-3 (2020), DeepSeek-V2 (2024), DeepSeek - karta modelu V4.1 Flash, Liu i in. - Lost in the Middle (2023), Anthropic - Long context prompting

Poznaj trzy architektury transformerów (encoder, decoder, encoder-decoder) i dowiedz się, dlaczego BERT, GPT-2 i BART rozwiązują różne zadania inaczej.
Astra, Sol czy Luna? Poradnik krok po kroku: jak dobrać model GPT-6, poziom rozumowania i tempo, napisać instrukcje, ogarnąć długie zadania i sprawdzić koszt przed wdrożeniem.
DeepSeek pokazuje V4.1-Flash z encoder-decoder MoE, milionem tokenów kontekstu i kompresją KV do ~890 bajtów na token. Architektura ma obniżyć koszt agentów AI.
Praktyczny poradnik: w których etapach pisania książki AI realnie pomaga, a gdzie sabotuje Twój głos autorski. Konkretne kroki i techniki.
Qualcomm pokazał chipy, które uruchamiają model AI z 30 miliardami parametrów prosto na telefonie. Sprawdzamy, co to oznacza i jak to zweryfikować u siebie.
Ładowanie zapisanego modelu AI potrafi niepotrzebnie zdublować użycie pamięci. Pokazujemy, dlaczego tak się dzieje i jak tego uniknąć.