Claude Opus 5.5 na szczycie rankingu, ale drogo za to płacisz
Przejdź do treści i przykładów

Źródło: Link
Źródło: Link
Mówi się, że model numer jeden w rankingu nadaje się do wszystkiego. Nie do końca. Claude Opus 5.5 od Anthropic rzeczywiście wskoczył na szczyt niezależnego benchmarku, ale zaraz za tym nagłówkiem kryje się druga część historii - i dla Twojego portfela ma ona większe znaczenie niż sama pozycja w tabeli.
Anthropic wypuścił Claude Opus 5.5 i już w tym samym tygodniu model zajął pierwsze miejsce w Intelligence Index - rankingu prowadzonym przez Artificial Analysis. To nie jeden test, tylko zestawienie wyników z dziesięciu różnych benchmarków, między innymi z zakresu programowania i odpowiadania na pytania wiedzowe. Opus 5.5 wyprzedził w nim GPT-6 Astra od OpenAI oraz Claude Fable 5.1 - czyli własny, jeszcze mocniejszy model Anthropic z wyższej półki cenowej.
Tu pojawia się pułapka myślowa: "najlepszy w rankingu" nie znaczy "najlepszy do Twojego konkretnego zadania". Intelligence Index to średnia z wielu testów, więc model może wygrywać ogólnie i jednocześnie przegrywać w wąskiej kategorii, która akurat Ciebie interesuje.
Dobry przykład to programowanie: wyniki Opus 5.5 w tym obszarze bywają, zależnie od konkretnego testu, albo wyraźnie lepsze od konkurencji, albo tylko nieznacznie lepsze. Innymi słowy - jeśli piszesz kod na co dzień, różnica może być odczuwalna albo kosmetyczna, zależnie od narzędzia i typu zadań, do których go używasz. Podobny wniosek płynie z testów Hex z GPT-6 Astra, jeśli pracujesz z generowaniem wykresów albo analiz danych - modele różnią się siłą w zależności od zadania, nie tylko od marki.
Teraz ta część, która realnie wpływa na decyzję, czy w ogóle przesiadać się na nowy model. Wysoka pozycja w rankingu ma swoją cenę - i to dosłownie. Opus 5.5 w API kosztuje 4 dolary za milion tokenów wejściowych i 20 dolarów za milion tokenów wyjściowych (stan na 23.09.2026). Fable 5.1, model z najwyższej warstwy Anthropic, jest jeszcze droższy: 10 dolarów za wejście i 50 dolarów za wyjście na milion tokenów. Dla porównania GPT-6 Astra od OpenAI mieści się w podobnym przedziale co Fable.
To oznacza, że jeśli szukasz maksymalnej wydajności i masz budżet, który to udźwignie, Opus 5.5 rzeczywiście jest sensownym wyborem. Jeśli liczysz koszty (a większość firm liczy), tańsze warianty z tej samej rodziny - Claude Sonnet 5 czy Haiku 4.5 - kosztują ułamek tej stawki. Podobny mechanizm cenowy widzieliśmy przy obniżce cen GPT-6 Sol i Luna: konkurencja w segmencie tańszych modeli robi się coraz ostrzejsza, podczas gdy flagowce trzymają wysokie stawki.
Jeśli prowadzisz firmę i zastanawiasz się, który model wybrać do konkretnego procesu, ranking Artificial Analysis jest dobrym punktem startowym, ale nie ostatecznym argumentem. Kilka rzeczy wartych sprawdzenia przed decyzją:
Anthropic konsekwentnie rozwija swoją linię modeli - firma pokazała to już wcześniej choćby przy wprowadzeniu Claude Docs i Slides, gdzie mierzy się bezpośrednio z Google. Teraz robi to samo w segmencie surowej mocy obliczeniowej modeli językowych, konkurując zarówno z OpenAI, jak i z własnym, droższym produktem.
Więc co z tego wynika? Ranking mówi Ci, kto teoretycznie jest najsilniejszy, ale nie mówi, czy stać Cię na tę siłę i czy w ogóle jej potrzebujesz do tego, co robisz na co dzień. Zanim przesiądziesz się na najdroższy model, bo "jest numer jeden", sprawdź, czy tańszy wariant nie załatwia Twojej sprawy równie dobrze za ułamek ceny.
Stan na 23.09.2026: Claude Opus 5.5 kosztuje 4 dolary za milion tokenów wejściowych i 20 dolarów za milion tokenów wyjściowych. To mniej niż Claude Fable 5.1 (10/50 dolarów za milion) czy GPT-6 Astra (10/50 dolarów za milion), choć wciąż wyraźnie więcej niż tańsze modele z rodziny Anthropic.
W zsumowanym rankingu Intelligence Index od Artificial Analysis - tak, Opus 5.5 zajmuje pierwsze miejsce. W pojedynczych kategoriach, na przykład programowaniu, różnice bywają wyraźne albo minimalne w zależności od konkretnego testu, więc wybór modelu warto dopasować do typu zadania, a nie wyłącznie do ogólnej pozycji w tabeli.
Na podstawie: Heise Online
10 gotowych promptów do codziennej pracy + 5 narzędzi + plan na pierwszy tydzień. PDF, 4 strony konkretu.
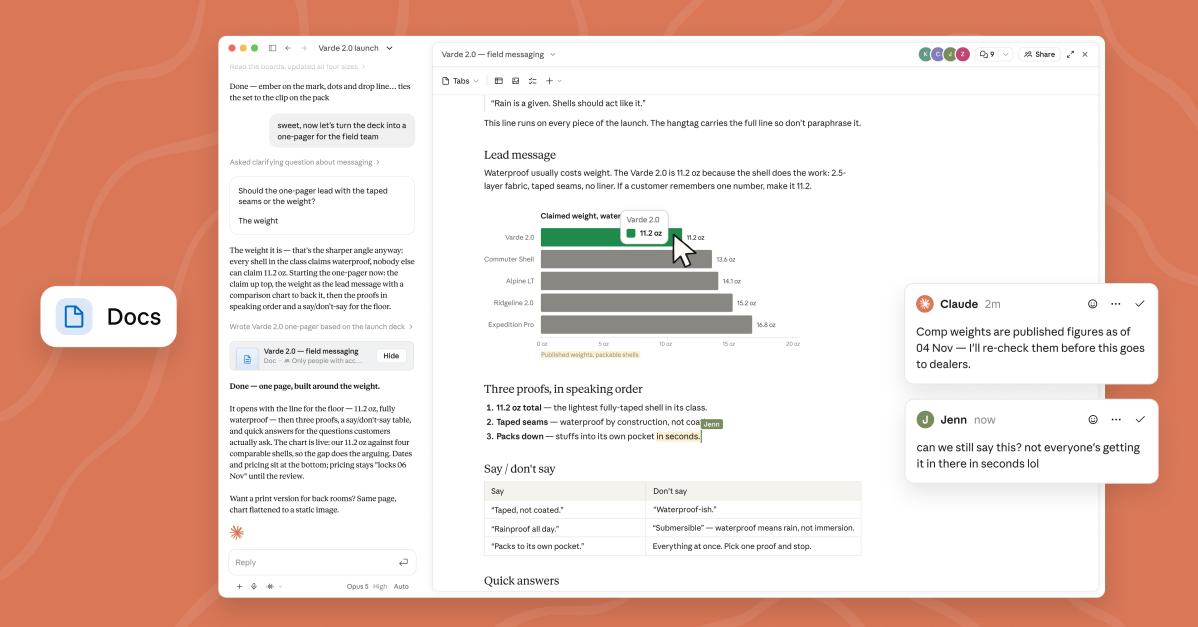
Anthropic wprowadza Claude Docs i Slides oraz upraszcza interfejs czatu. Sprawdzamy, co dokładnie zmienia się w codziennej pracy z Claude.
Claude Pro w Polsce kosztuje 18 EUR miesięcznie bez VAT (ok. 96 zł z VAT) albo 180 EUR za rok. Limity co 5 godzin, Opus 5.5, Claude Code. Stan na 23.09.2026.

Anthropic łączy pamięć Claude między chatem i Cowork. Koniec z ciągłym tłumaczeniem AI, nad czym pracujesz i jak lubisz działać.
Badanie YouGov pokazuje, że użytkownicy AI najwyżej oceniają Claude - 56,2 punktu vs 46,5 dla Gemini i 46,0 dla ChatGPT. Co sprawia, że model Anthropic wygrywa?
Badacze bezpieczeństwa użyli Claude, by uzyskać dostęp do konta pracownika OpenAI. Firma dowiedziała się o dziurze i wypłaciła nagrodę 6500 dolarów.
Stan na 23.09.2026: w Polsce Pro kosztuje 18 EUR (ok. 96 zł z VAT), Max 90 lub 180 EUR, Team od 18 EUR za osobę, Enterprise 20 USD za miejsce + zużycie.