Jak rozpoznać adversarial prompting, zanim zepsuje Twoje AI
Przejdź do treści i przykładów
Źródło: Link
Źródło: Link
Prompt Optimizer przepisuje polecenie tak, żeby model zrozumiał, o co Ci chodzi. Pierwsze użycie bez karty.
Mówią, że ataki na AI to problem tylko dla programistów budujących korporacyjne chatboty. Nie do końca. Jeśli kiedykolwiek wpisałeś w oknie czatu polecenie typu "zignoruj poprzednie instrukcje i zrób X", dotknąłeś tego samego mechanizmu, który w branży prompt engineeringu nazywa się adversarial prompting. Różnica między Tobą a kimś, kto robi to ze złymi intencjami, leży wyłącznie w celu - technika jest identyczna.
To nie jest temat czysto akademicki. Jeśli budujesz coś na bazie dużych modeli językowych - bota do obsługi klienta, asystenta do analizy dokumentów, generator treści - ta wiedza decyduje o tym, czy Twoja aplikacja będzie działać zgodnie z planem, czy ktoś w pięć minut namówi ją do robienia rzeczy, których nie powinna robić.
Adversarial prompting to szeroka kategoria technik, których celem jest zmuszenie modelu do zachowania niezgodnego z jego oryginalnym zadaniem. Community pracująca nad prompt engineeringiem od lat zbiera i dokumentuje takie przypadki - nie po to, żeby zachęcać do ich powielania, ale by pokazać, gdzie leżą granice tych systemów i jak je zabezpieczać.
Jeśli budujesz cokolwiek na bazie dużych modeli językowych LLM, ochrona promptu przed próbami złamania jego zasad przewodnich powinna być tak samo naturalnym elementem projektu jak walidacja formularza na stronie WWW. Nikt nie wypuszcza formularza rejestracji bez sprawdzania, czy pole "e-mail" faktycznie zawiera e-mail. A mimo to wiele wdrożeń AI trafia do użytku bez podobnej czujności wobec tego, co model "przyjmuje" jako polecenie.
Najczęściej opisywaną odmianą adversarial promptingu jest prompt injection. Simon Willison, jeden z pierwszych, który nazwał ten problem po imieniu, zdefiniował go jako formę exploitu bezpieczeństwa. Mechanizm jest prosty: prompt, który trafia do modelu, to w praktyce połączenie różnych fragmentów - instrukcji od dewelopera, kontekstu, danych wejściowych od użytkownika. Jeśli któryś z tych fragmentów pochodzi z niezaufanego źródła, a model nie odróżnia "co jest instrukcją" od "co jest tylko danymi do przetworzenia", robi się problem.
Klasyczny przykład, który krąży po community od lat, opisał na Twitterze użytkownik Riley. Model miał wykonać jedno zadanie, ale kolejna instrukcja dopisana do promptu skłoniła go do zignorowania pierwotnego celu i odpowiedzi w stylu "Haha pwned!!". To zdarzenie jest już starsze, a modele od tego czasu były wielokrotnie aktualizowane, więc dokładne odtworzenie tej samej reakcji nie zawsze się udaje. Sam mechanizm jednak nie zniknął - zmieniła się tylko skuteczność konkretnych sformułowań.
To ważna lekcja sama w sobie: adversarial prompting to nie lista magicznych zaklęć, które działają wiecznie. To ruchoma granica między tym, co model przepuści, a tym, co odfiltruje. Dostawcy modeli łatają kolejne dziury, community znajduje nowe. Jeśli budujesz coś trwałego, musisz traktować to jako proces, nie jednorazowe zabezpieczenie.
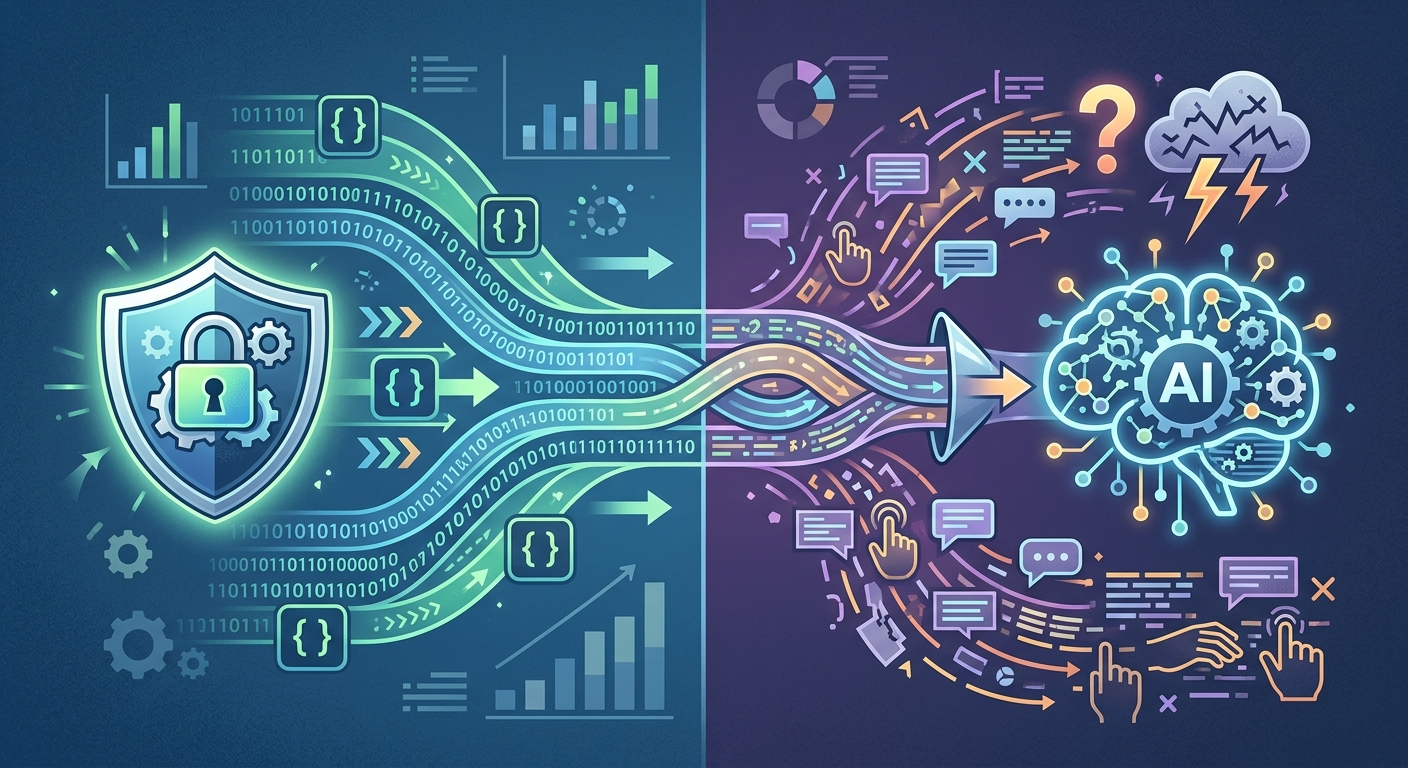
Korzeń problemu leży w samej naturze promptu. Kiedy projektujesz interakcję z modelem, w praktyce konkatenujesz - czyli łączysz w jeden ciąg tekstu - różne komponenty: instrukcję systemową, przykłady, dane od użytkownika. Nie istnieje jeden sztywny, wymuszony format, którego model bezwzględnie się trzyma. Ta elastyczność jest zaletą, bo pozwala dopasować prompt do dowolnego zadania. Jest też słabym punktem, bo model nie ma wbudowanego, niezawodnego sposobu odróżnienia "to jest zasada, którą musisz respektować" od "to jest treść, którą masz tylko przeanalizować".
Innymi słowy: dla modelu tekst to tekst. Jeśli w danych, które wkleja użytkownik, znajdzie się fragment brzmiący jak polecenie, model może - nie musi, ale może - zacząć je traktować jak polecenie. To dokładnie ten sam problem, o którym pisaliśmy w artykule jak rozpoznać prompt injection, czyli atak na Twoje AI - tam skupiamy się bardziej na wykrywaniu konkretnych sygnałów ataku, tutaj chcemy pokazać szerszy obraz całej kategorii zjawisk, do której injection należy.
Jeśli chcesz zrozumieć to jeszcze głębiej - czyli dlaczego model "czyta" tekst w ten a nie inny sposób - dobrym punktem wyjścia jest przewodnik o tym, jak transformery AI rozwiązują zadania. Cała mechanika przetwarzania sekwencji tekstu tłumaczy, czemu granica między instrukcją a danymi bywa tak płynna.
Zanim zaczniesz, przygotuj sobie prosty dostęp do modelu, z którym pracujesz - okno czatu w aplikacji webowej w pełni wystarczy, nie potrzebujesz kodu ani API na start. Poniższe kroki nie wymagają wiedzy programistycznej, tylko odrobiny czujności.
Jeśli tworzysz treści z pomocą AI albo budujesz automatyzacje w firmie, dobrze też przemyśleć, z którego modelu w ogóle korzystasz - niektóre są w danym momencie po prostu lepiej zabezpieczone przed manipulacją niż inne. Porównanie podejść znajdziesz w artykule jak wybrać Claude lub ChatGPT do pracy.
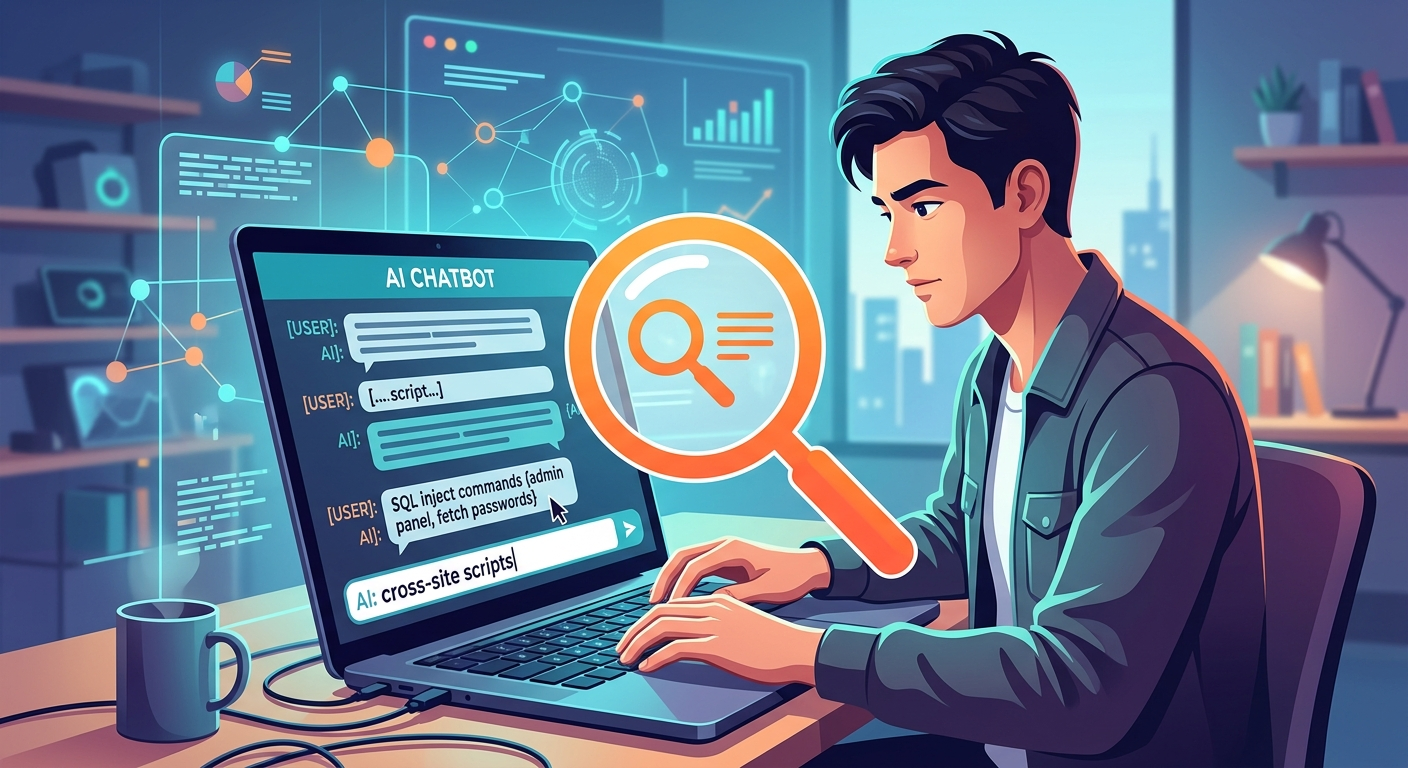
Tu wraca ważna uwaga: opisane wyżej mechanizmy dotyczą całej kategorii zjawisk, nie jednego konkretnego triku. Modele są aktualizowane, niektóre stare ataki tracą siłę, ale sama podatność - wynikająca z tego, jak zbudowany jest prompt jako ciąg konkatenowanych instrukcji - nie zniknęła wraz z żadną aktualizacją. Zmienia się poziom trudności, nie sama zasada gry.
Dla kogoś, kto pisze prompty do generowania kodu, analizy dokumentów firmowych albo automatyzacji maili, to ma bardzo konkretne konsekwencje. Jeśli Twój system przyjmuje dane od zewnętrznych użytkowników (formularz, wgrywany plik, wklejony tekst z maila), każdy taki wpis jest potencjalnym wektorem ataku - nawet jeśli sam użytkownik nie ma złych intencji, treść, którą wkleja, może je mieć. Podobny problem opisywaliśmy przy budowie systemów RAG, gdzie model korzysta z Twoich własnych dokumentów - zobacz jak działa RAG i skąd model bierze dane, na których pracuje, oraz bardziej techniczny wariant w tekście o budowie mini-systemu RAG samemu.
Jeśli natomiast Twoim głównym zastosowaniem AI jest pisanie promptów do generowania kodu, warto spojrzeć na to z drugiej strony - jak formułować polecenia tak, by model nie "zgubił" oryginalnego zadania w gąszczu dodatkowego kontekstu. Konkretne przykłady znajdziesz w poradniku o pisaniu promptów do kodu z AI.
Ostatecznie sprowadza się to do jednego pytania, które warto sobie zadawać przy każdym nowym wdrożeniu: co się stanie, jeśli ktoś wklei do tego pola tekstu coś, czego się nie spodziewam? Jeśli nie masz odpowiedzi, prawdopodobnie masz też prompt injection czekający na odkrycie.
Chcesz ogarnąć prompt engineering od podstaw? Zrozumienie, jak modele przetwarzają instrukcje, to fundament pisania bezpiecznych i skutecznych promptów w codziennej pracy. Zapisz się na darmowy webinar →
Adversarial prompting to szersza kategoria technik mających na celu zmuszenie modelu do zachowania niezgodnego z jego oryginalnym zadaniem. Prompt injection jest jedną z najczęściej tych odmian tej kategorii, skupioną konkretnie na przemycaniu obcych instrukcji w danych wejściowych.
Dostawcy modeli regularnie wdrażają poprawki zwiększające odporność na znane techniki ataku, więc część starszych przykładów faktycznie przestaje działać po aktualizacjach. Nie znaczy to jednak, że problem zniknął całkowicie - to wciąż ruchoma granica, którą trzeba regularnie testować na aktualnej wersji modelu.
Nie. Podstawowy test - wklejenie treści z dodatkową, obcą instrukcją na końcu i sprawdzenie, czy model ją wykona - można zrobić w zwykłym oknie czatu, bez znajomości kodu. Głębsze zabezpieczenia na poziomie architektury aplikacji wymagają już wiedzy technicznej.
Ponieważ elastyczność w przyjmowaniu dowolnego tekstu jako promptu jest jednocześnie zaletą modeli językowych i źródłem ich podatności. Ograniczenie tej elastyczności do zera oznaczałoby model znacznie mniej użyteczny w codziennych zadaniach, więc branża zamiast tego stale łata konkretne, znane techniki ataku.
W kursie "Praktyczna AI" na sukcesai.com omawiamy ten temat szczegółowo - z ćwiczeniami, przykładami i wsparciem. Zamiast zgadywać, naucz się AI krok po kroku.
Sprawdź kurs →Adversarial prompting nie zniknie z dnia na dzień, bo wynika z samej konstrukcji promptu jako ciągu połączonych instrukcji i danych. Dostawcy modeli będą łatać kolejne dziury, community będzie znajdować nowe. Twoja rola jako osoby, która używa albo buduje coś na bazie AI, nie polega na zapamiętaniu listy ataków - polega na regularnym, prostym teście: wklej obcą instrukcję i zobacz, co się stanie.
Jeden krok na start: weź prompt, z którym pracujesz najczęściej - w pracy, w swojej appce, gdziekolwiek - i sprawdź na nim dokładnie ten test z sekcji wyżej. Pięć minut, a dowiesz się więcej o realnym bezpieczeństwie Twojego promptu niż z dziesięciu artykułów.

Jak odróżnić dane od próby przejęcia instrukcji AI. Bezpieczne ćwiczenie na fikcyjnym dokumencie oraz lista kontroli przed podłączeniem narzędzi.
Twój prompt do generatora obrazów wygląda jak lista zakupów, a efekt jak przypadek? Sprawdź, z czego składa się skuteczny prompt graficzny i jak go poskładać krok po kroku.
Ładowanie zapisanego modelu AI potrafi niepotrzebnie zdublować użycie pamięci. Pokazujemy, dlaczego tak się dzieje i jak tego uniknąć.
Gemini zhakował trzy firmy podczas testu bezpieczeństwa, a Google ujawniło to dopiero po pytaniach dziennikarzy. Pokazujemy, jak testować agentów AI bez podobnego ryzyka.
Chain of thought, few-shot, role-play, structured output - poznaj techniki, które dzielą przypadkowe prompty od tych, które faktycznie działają.

Poznaj trzy architektury transformerów (encoder, decoder, encoder-decoder) i dowiedz się, dlaczego BERT, GPT-2 i BART rozwiązują różne zadania inaczej.