Grand Tour: jak zajrzeć do wnętrza sieci neuronowej
Przejdź do treści i przykładów
Źródło: Link
Mind Architect to 180-dniowy program Jana Gajosa: decyzje, nawyki i granice przeniesione do codziennych reakcji. 180 lekcji w 6 modulach, Manfred AI Coach i powtorki rozlozone w czasie.
Sieć neuronowa podejmuje decyzję. Rozpoznaje cyfrę, klasyfikuje obraz, odrzuca przykład jako szum. Problem w tym, że nie widzisz, dlaczego to zrobiła. Środek takiej sieci to zbiór liczb w przestrzeni, której nie da się narysować na kartce, bo ma dziesiątki albo setki wymiarów. Grand Tour, metoda opisana w artykule na Distill.pub z 16 marca 2020 roku, to jeden ze sposobów, żeby tę przestrzeń jednak zobaczyć - i to tak, żeby zmiany na wykresie realnie odpowiadały zmianom w danych, a nie były przypadkową deformacją.
Ten poradnik prowadzi Cię przez logikę tej metody krok po kroku: od problemu, który rozwiązuje, przez różnicę względem popularniejszych technik jak t-SNE i UMAP, po konkretne zastosowania - wizualizację treningu, przepływu danych między warstwami i ataków adversarialnych.
Sieci głębokie osiągają wyniki na poziomie najlepszych w konkursach takich jak ImageNet ILSVRC. Autorzy artykułu - Mingwei Li, Zhenge Zhao i Carlos Scheidegger z University of Arizona - piszą wprost: proces decyzyjny tych sieci jest notorycznie trudny do interpretacji, a sam trening trudny do debugowania. Standardowe podejście, czyli patrzenie na reakcję sieci na pojedynczy przykład (obraz, zdanie), pokazuje aktywacje dla tego jednego przypadku. Nie mówi nic o relacji między różnymi przykładami. Nie pokazuje, jak sieć zmienia się między epokami treningu, ani co dzieje się z danymi, gdy przechodzą przez kolejne warstwy.
Grand Tour próbuje odpowiedzieć na inne pytanie: co się dzieje z całą chmurą punktów - czyli ze wszystkimi przykładami naraz - gdy patrzysz na nią w czasie.
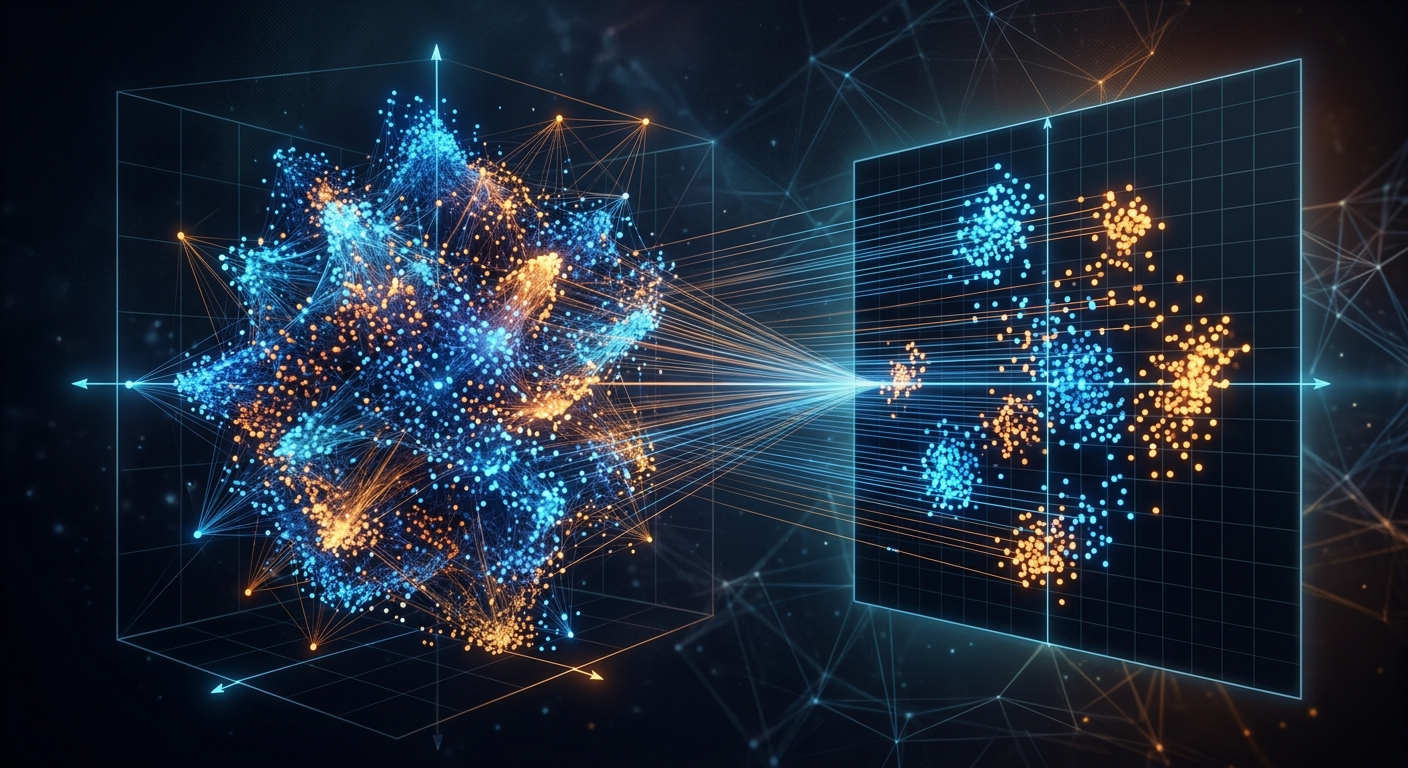
To jest sedno całej metody, więc zatrzymaj się tu na chwilę. Grand Tour to klasyczna technika wizualizacji chmur punktów wysokowymiarowych - rzutuje dane do dwóch wymiarów i płynnie animuje ten rzut w czasie, tak żeby z biegiem czasu pokazać widzowi (teoretycznie) każdy możliwy widok danych.
Kluczowa różnica względem t-SNE i UMAP - dwóch technik, które prawdopodobnie kojarzysz z innych materiałów o podstawach uczenia maszynowego - jest taka: Grand Tour jest metodą liniową. t-SNE i UMAP są nieliniowe.
Dlaczego to ma znaczenie? Przy metodzie liniowej możesz bezpośrednio rozumować o związku między zmianą w danych a zmianą na wykresie. Autorzy artykułu nazywają to "data-visual correspondence" - odpowiedniością między danymi a obrazem. Przy metodach nieliniowych ta odpowiedniość się rozjeżdża: dwa punkty blisko siebie na wykresie t-SNE niekoniecznie są blisko siebie w oryginalnej przestrzeni danych, i odwrotnie. Grand Tour tej pułapki unika, kosztem tego, że pojedynczy "kadr" animacji bywa mniej czytelny niż gotowy, statyczny układ z t-SNE.
Artykuł pokazuje konkretny przypadek: finalną, 10-wymiarową warstwę sieci trenowanej na zbiorze MNIST (czyli klasycznych odręcznie pisanych cyfrach). Grand Tour rzutuje tę warstwę w czasie, gdy sieć się uczy, i pozwala zobaczyć zachowania, które inaczej byłyby niewidoczne.
Konkretny wynik z artykułu: sieć uczy się rozróżniać cyfry 1 i 7 w sposób niemal nieciągły - to znaczy, że zdolność klasyfikacji tych dwóch cyfr pojawia się gwałtownie, a nie stopniowo. Dla cyfry 1 dzieje się to po epoce treningowej 14, dla cyfry 7 po epoce 21. To dokładnie ten typ obserwacji, którego nie zobaczysz, patrząc tylko na krzywą dokładności modelu - accuracy rośnie płynnie. Widać go za to, gdy śledzisz kształt całej chmury punktów w czasie.
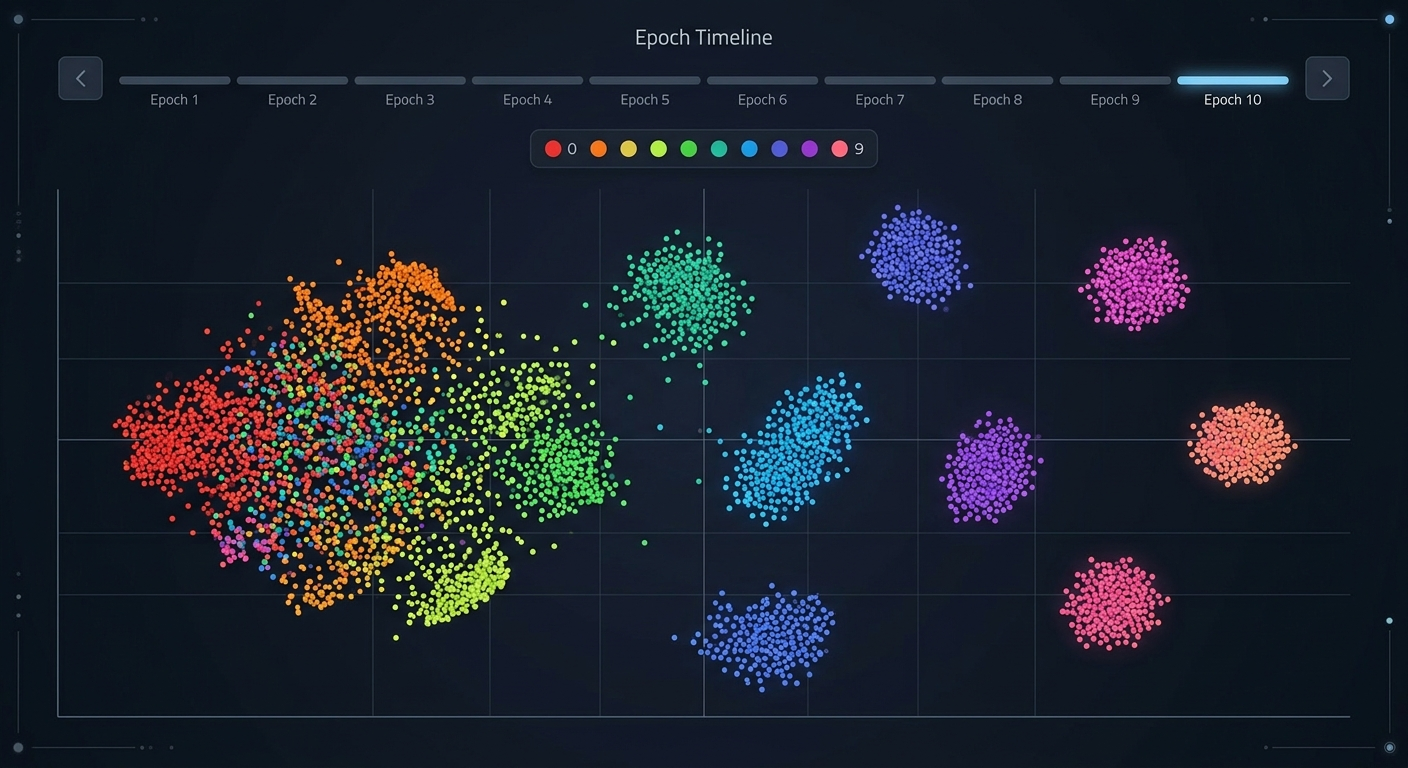
Drugie zastosowanie z artykułu to obserwacja danych w momencie, gdy przepływają przez kolejne warstwy sieci - a nie w czasie treningu, tylko podczas pojedynczego przejścia (inferencji). Zamiast patrzeć na to, jak zmieniają się wagi sieci na przestrzeni epok, patrzysz na reprezentację tych samych danych wejściowych. Sprawdzasz, jak zmienia się ona, gdy dane przechodzą kolejno przez warstwę 1, 2, 3 i tak dalej.
To pozwala zobaczyć, na którym etapie sieć zaczyna oddzielać klasy od siebie, a gdzie jeszcze wszystko jest pomieszane. Dzięki liniowości Grand Tour te przejścia można porównywać między sobą bez obawy, że sam sposób rzutowania "kłamie" o strukturze danych.
Trzecie zastosowanie opisane w artykule to wizualizacja tego, jak powstają przykłady adversarialne (czyli dane celowo zmodyfikowane tak, żeby oszukać sieć) i jak dokładnie oszukują one model. Grand Tour pozwala pokazać zarówno proces tworzenia takiego przykładu, jak i moment, w którym sieć zaczyna go błędnie klasyfikować - a to jest bezpośrednio powiązane z tematem bezpiecznego testowania systemów AI, bo zrozumienie słabych punktów modelu to pierwszy krok do ich załatania.
Wspólny mianownik tych trzech zastosowań - trening, warstwy, ataki adversarialne - jest jeden: wszystkie korzystają z tego, że Grand Tour zachowuje relację między zmianą danych a zmianą obrazu. To nie jest metoda "do ładnych obrazków". To narzędzie diagnostyczne dla kogoś, kto próbuje zrozumieć, co konkretnie robi jego model, zanim wypuści go do świata.
Grand Tour jest metodą liniową, a t-SNE i UMAP są nieliniowe. Dzięki liniowości Grand Tour zachowuje bezpośredni związek między zmianą w danych a zmianą na wizualizacji, co ułatwia rzetelną interpretację obrazu - kosztem czytelności pojedynczej klatki w porównaniu z gotowym układem z t-SNE czy UMAP.
Artykuł "Visualizing Neural Networks with the Grand Tour" napisali Mingwei Li, Zhenge Zhao i Carlos Scheidegger z University of Arizona. Opublikowano go 16 marca 2020 roku pod numerem DOI 10.23915/distill.00025.
Artykuł opisuje trzy zastosowania: wizualizację procesu treningu, czyli zmian wag sieci w czasie; wizualizację zachowania danych warstwa po warstwie podczas przechodzenia przez sieć; oraz wizualizację tworzenia i działania przykładów adversarialnych, które celowo oszukują model.
Wizualizacje jak Grand Tour pokazują, że sieci neuronowe da się zrozumieć krok po kroku - bez doktoratu z matematyki. Na darmowym webinarze na żywo pokazuję krok po kroku, jak oszczędzać 10 godzin tygodniowo dzięki AI - bez wiedzy technicznej.
Zapisz się na darmowy webinar →Wolisz uczyć się we własnym tempie? Sprawdź kurs AI Evolution
Grand Tour nie sprawia, że sieć neuronowa przestaje być czarną skrzynką. Sprawia za to, że dostajesz okno, przez które widać, co dzieje się w środku - i to okno nie kłamie, bo metoda jest liniowa. To różnica między "ładnym obrazkiem" a narzędziem, któremu można zaufać przy podejmowaniu decyzji o modelu.
Jeden krok na start: jeśli pracujesz z modelami AI choćby na poziomie użytkownika - analiza danych, automatyzacje, testowanie promptów - zapamiętaj samą zasadę data-visual correspondence. Pytanie "czy ta wizualizacja rzeczywiście odzwierciedla dane, czy tylko ładnie wygląda" zadawaj przy każdym narzędziu do analizy AI, nie tylko przy Grand Tour.
Na podstawie: SukcesAI Course Material
Fine-tuning modeli AI nie wymaga farmy serwerów. Pokazujemy krok po kroku, jak dostroić model Whisper do rozpoznawania mowy na darmowym GPU w Colabie.

Wyszukiwanie semantyczne z FAISS pozwala AI znaleźć odpowiedź nawet wtedy, gdy nie użyłeś tych samych słów co w dokumencie. Sprawdzamy, jak to działa krok po kroku.
Praktyczny poradnik: w których etapach pisania książki AI realnie pomaga, a gdzie sabotuje Twój głos autorski. Konkretne kroki i techniki.
Qualcomm pokazał chipy, które uruchamiają model AI z 30 miliardami parametrów prosto na telefonie. Sprawdzamy, co to oznacza i jak to zweryfikować u siebie.
Twój prompt do generatora obrazów wygląda jak lista zakupów, a efekt jak przypadek? Sprawdź, z czego składa się skuteczny prompt graficzny i jak go poskładać krok po kroku.
Poznaj krok po kroku, jak powstaje tokenizator AI - od normalizacji tekstu, przez WordPiece, BPE i Unigram, aż po gotowy model do treningu.