Jak dostroić model Whisper do rozpoznawania mowy: przewodnik po fine-tuningu ASR
Przejdź do treści i przykładów
Źródło: Link
Źródło: Link
Mind Architect to 180-dniowy program Jana Gajosa: decyzje, nawyki i granice przeniesione do codziennych reakcji. 180 lekcji w 6 modulach, Manfred AI Coach i powtorki rozlozone w czasie.
Mówią, że fine-tuning modeli AI to zabawa dla zespołów z budżetem korporacji i serwerownią w piwnicy. Prawda jest inna: model Whisper da się dostroić do rozpoznawania konkretnego języka czy akcentu na darmowym GPU w Google Colab, mając do dyspozycji zbiór danych wielkości kilku godzin nagrań. Nie potrzebujesz dyplomu z uczenia maszynowego - potrzebujesz notebooka, konta na Hugging Face i cierpliwości na tyle, żeby przejść przez proces raz, spokojnie, krok po kroku.
Whisper to model ASR (Automatic Speech Recognition), który już umie rozpoznawać mowę w wielu językach - powstał na ogromnej ilości danych treningowych. Problem zaczyna się tam, gdzie Twój język, akcent albo specyficzne słownictwo są w tych danych rzadkością. Wtedy nie trenujesz modelu od zera (to zajęłoby tygodnie i wymagało danych, których i tak nie masz), tylko bierzesz gotowy model i "douczasz" go na mniejszym, konkretnym zbiorze danych ML związanym z Twoim zadaniem.
To jest sedno fine-tuningu modeli: nie zaczynasz z pustym mózgiem, tylko z modelem, który już rozumie ogólną strukturę mowy i języka, a Ty pokazujesz mu tylko to, co jest specyficzne dla Twojego przypadku. W poradniku, na którym się opieramy, chodzi o dostrojenie Whispera do języka divehi (używanego na Malediwach) - języka, dla którego dostępnych danych jest naprawdę mało. Dokładnie ten sam schemat działa jednak dla dowolnego języka dostępnego w zbiorze Common Voice, a szerzej - dla każdego zbioru danych ASR dostępnego na Hugging Face Hub.
Wybór wersji "small" modelu Whisper i relatywnie lekkiego zbioru danych to nie przypadek - to świadoma decyzja, żeby cały proces zmieścił się w limitach darmowego GPU T4 (16GB), które Google Colab daje bezpłatnie. Jeśli masz mniejszą kartę graficzną, są sposoby na ograniczenie zużycia pamięci podczas treningu. Jeśli masz większy GPU - możesz zmienić parametry treningowe i przyspieszyć cały proces. Ten sam przepis działa niezależnie od tego, jaki sprzęt masz pod ręką, co czyni go dobrym punktem wejścia, jeśli chcesz zrozumieć, jak w praktyce wygląda dostrajanie modeli opartych na architekturze transformerów, bez konieczności inwestowania w drogi sprzęt.
Nie rzucaj się od razu na kod. Zanim otworzysz notebooka, sprawdź, czy masz te trzy rzeczy:
Przestrzeń na dysku, jakiej potrzebujesz, jest niewielka - to jeden z powodów, dla których ten przepis na fine-tuning jest dostępny praktycznie dla każdego, nawet bez dostępu do drogiej infrastruktury.
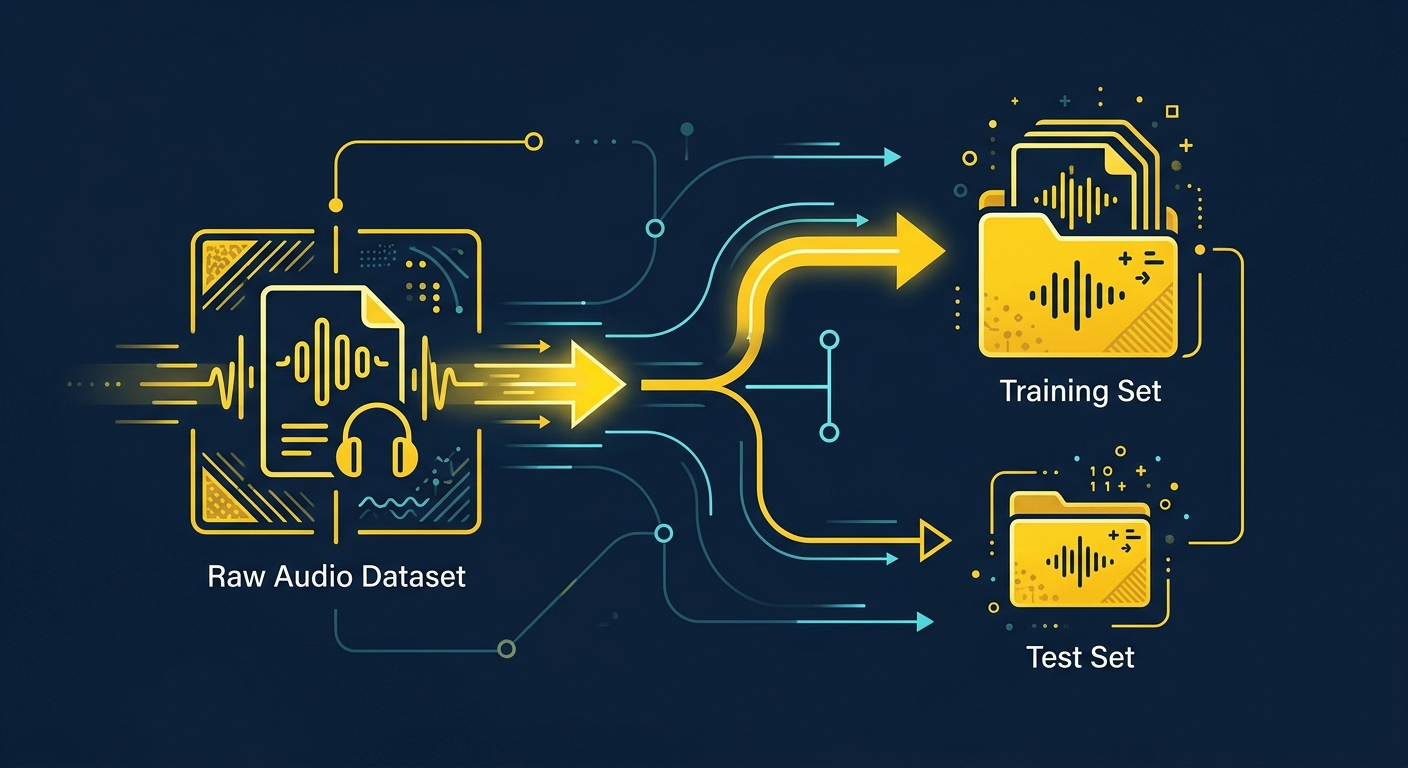
Na tym etapie masz gotowe fundamenty: środowisko połączone z Hugging Face Hub oraz dane podzielone na trening i test. Kolejne etapy typowego procesu fine-tuningu - przygotowanie audio pod wymagany format modelu, konfiguracja parametrów treningu i sam trening - to naturalna kontynuacja tej samej logiki: bierzesz gotowy model, dajesz mu wąski, dobrze opisany zbiór danych i pozwalasz, żeby dostrojenie zrobiło swoje. Jeśli interesuje Cię, jak wygląda ten sam mechanizm w innym środowisku chmurowym, może zainteresować Cię też poradnik o tym, jak wytrenować model AI w chmurze przy użyciu Azure ML SDK.
Dziesięć godzin nagrań to dla wielu popularnych języków ilość, z której można się pośmiać - dla angielskiego czy niemieckiego to ułamek promila tego, na czym trenuje się modele od zera. Dla divehi to jednak sensowna baza do fine-tuningu, właśNie chodzi o to, że Whisper nie zaczyna z niczego. Model już rozumie, jak dźwięk mowy przekłada się na fonemy, jak wygląda struktura zdania, jak radzić sobie z szumem w nagraniu - te umiejętności przenoszą się między językami, nawet tymi, których model nigdy wcześniej nie widział w takiej ilości.
To jest praktyczna lekcja, która wykracza daleko poza sam ASR: ten sam mechanizm transferu wiedzy stoi za tym, że modele językowe radzą sobie z językami mniej popularnymi w internecie, w tym z polskim. Jeśli zastanawiałeś się, dlaczego niektóre modele czatowe potrafią sensownie rozmawiać po polsku mimo tego, że większość ich danych treningowych jest po angielsku, mechanizm jest analogiczny do tego, co dzieje się tutaj z Whisperem - sprawdziliśmy to zresztą osobno w teście, czy z Claude można swobodnie rozmawiać po polsku.
Dla polskich firm i twórców to konkretna wiadomość: nie musisz mieć dostępu do gigantycznych, drogich zbiorów danych, żeby dostroić model rozpoznawania mowy pod polski język branżowy, regionalny akcent czy specyficzną terminologię (np. medyczną albo prawniczą). Common Voice ma zbiory danych dla wielu języków, w tym polskiego, a cały ten sam schemat - środowisko, dane, podział na trening i test - przenosi się bez zmian.
Trenowanie od zera oznacza, że model zaczyna bez żadnej wiedzy i uczy się wszystkiego z Twoich danych - to wymaga ogromnych zbiorów i mocy obliczeniowej. Fine-tuning bierze model już wytrenowany na dużym zbiorze ogólnym i tylko dostraja go do wąskiego zadania na dużo mniejszej liczbie przykładów.
Nie - do dostrojenia wersji "small" Whispera wystarczy GPU z 16GB pamięci, a taki dostajesz bezpłatnie w Google Colab (karta T4). Jeśli masz mniejszy GPU, można ograniczyć zużycie pamięci, dostosowując parametry treningu.
Nie, divehi jest tu tylko przykładem. Ten sam schemat działa dla każdego języka dostępnego w zbiorze Common Voice, a bardziej ogólnie - dla dowolnego zbioru danych ASR dostępnego na Hugging Face Hub.
W opisanym przykładzie do dostrojenia użyto około siedmiu godzin nagrań treningowych i trzech godzin danych testowych. To niewiele w porównaniu z trenowaniem od zera, ale wystarczające, bo model wykorzystuje wiedzę zdobytą wcześniej podczas pre-treningu na wielu innych językach.
Dostrajanie modeli AI, praca z danymi i chmurą brzmi znacznie prościej, kiedy zobaczysz to na żywo, krok po kroku, bez żargonu. Na darmowym webinarze pokazuję krok po kroku, jak oszczędzać 10 godzin tygodniowo dzięki AI - bez wiedzy technicznej.
Zapisz się na darmowy webinar →Wolisz uczyć się we własnym tempie? Sprawdź kurs AI Evolution
Fine-tuning modeli AI nie jest magią zarezerwowaną dla dużych zespołów badawczych. To seria konkretnych, powtarzalnych kroków: bierzesz gotowy model, łączysz się z Hugging Face Hub, wczytujesz odpowiedni zbiór danych, dzielisz go na trening i test - i pozwalasz modelowi wykorzystać to, czego już się nauczył. Cała trudność leży nie w dostępie do sprzętu, a w tym, żeby usiąść i przejść przez proces raz, uważnie.
Jeden krok na start: otwórz stronę zbioru Common Voice 13 na Hugging Face Hub, sprawdź, czy jest tam Twój język (albo interesujący Cię dialekt/akcent), i zobacz, ile godzin nagrań faktycznie masz do dyspozycji. To zajmie Ci pięć minut, a od razu wiesz, czy Twój projekt fine-tuningu ma sens.
Na podstawie: SukcesAI Course Material
Automatyczne streszczanie tekstów to jedno z najtrudniejszych zadań AI. Pokazuję, jak działa summarization, kiedy ma sens i jak trenować model dwujęzyczny krok po kroku.
Fine-tuning To przypomina czarna magia dla programistów. Ale czasem to jedyny sposób, żeby AI rozumiało Twoją branżę. Sprawdzamy, kiedy warto wydać pieniądze - a kiedy wystarczy prompt.
Falcon, Mistral, Claude, Llama - dziesiątki modeli AI, setki wariantów. Który wybrać do swojego projektu? Praktyczny przewodnik po kolekcji dużych modeli językowych.
Poradnik po metodzie Grand Tour z Distill.pub - jak działa ta wizualizacja i co pokazuje o treningu sieci neuronowych, warstwach i atakach adversarialnych.

Wyszukiwanie semantyczne z FAISS pozwala AI znaleźć odpowiedź nawet wtedy, gdy nie użyłeś tych samych słów co w dokumencie. Sprawdzamy, jak to działa krok po kroku.
Twój prompt do generatora obrazów wygląda jak lista zakupów, a efekt jak przypadek? Sprawdź, z czego składa się skuteczny prompt graficzny i jak go poskładać krok po kroku.