
Jak rozpoznać i naprawić halucynacje w dużych modelach językowych
Przejdź do treści i przykładów
Zapytałeś model AI o szczegóły konferencji naukowej z 2023 roku. Model podał Ci dokładną datę, nazwiska prelegentów i tematy wystąpień. Wszystko brzmiało wiarygodnie. Problem? Konferencja się nie odbyła. Model właśnie "zahalucynował" - wymyślił fakty, które brzmią jak prawda, ale nią nie są.
Aktualizacja 13.10.2026: zaktualizowaliśmy nazwy modeli do stanu na 13.10.2026, poprawiliśmy opisy kilku metod tak, żeby zgadzały się z przeglądem Lilian Weng, i dopisaliśmy wnioski z pracy badaczy OpenAI z 2025 roku o tym, skąd biorą się halucynacje.
To nie marginalny problem. Lilian Weng poświęciła mu obszerny przegląd badań (lipiec 2024), a badacze OpenAI w pracy z września 2025 roku piszą wprost, że halucynacje utrzymują się nawet w najlepszych systemach. Najnowsze modele - w październiku 2026 to m.in. GPT-6 Astra i GPT-6.1 Sol, Claude Opus 5.5 i Gemini 3.1 Pro - są coraz lepsze, ale mechanizm, który prowadzi do zmyśleń, się nie zmienił. Różnica między dobrym a złym użytkowaniem AI? Umiejętność rozpoznania, kiedy model zmyśla.
Weng rozróżnia dwa typy halucynacji w dużych modelach językowych. Pierwszy to halucynacje kontekstowe (in-context hallucination) - model generuje odpowiedź sprzeczną z tym, co dostał w prompcie. Dałeś mu raport finansowy z konkretną liczbą? Model cytuje inną. To irytujące, ale łatwe do wychwycenia - masz źródło w zasięgu ręki.
Drugi typ to halucynacje zewnętrzne (extrinsic hallucination) - i tu zaczyna się prawdziwy problem. Model generuje treści, które brzmią jak fakty, ale nie są ugruntowane w rzeczywistości ani w danych treningowych. Wymyśla nazwiska naukowców, cytuje nieistniejące badania, podaje błędne daty historyczne. Robi to z taką pewnością siebie, że łatwo uwierzyć.
Dlaczego to się dzieje? Model został wytrenowany na ogromnym zbiorze danych z internetu - a internet pełen jest błędów, nieaktualnych informacji i sprzeczności. Model nauczył się maksymalizować prawdopodobieństwo kolejnego słowa, nie weryfikować faktów. Jeśli wzorzec w danych sugeruje, że po "Konferencja odbyła się w" powinien pojawić się rok i miasto, model wygeneruje coś, co brzmi sensownie. Nieważne, czy to prawda.
Problem zaczyna się już na etapie pre-trainingu. Dane treningowe dużych modeli językowych to w dużej części tekst zebrany z publicznego internetu. Część z nich to artykuły naukowe i encyklopedie, ale sporo to fora, blogi i komentarze - treści nieweryfikowane, często błędne albo nieaktualne. Model uczy się wszystkiego naraz, bez rozróżnienia na prawdę i fikcję. Dotyczy to każdej rodziny modeli - GPT, Claude czy Gemini.
Dane się dezaktualizują. Model wytrenowany na danych z 2024 roku nie wie, co wydarzyło się w 2026. Jeśli zapytasz go o najnowsze wersje narzędzi AI, może podać informacje sprzed dwóch lat - i zrobi to z pełnym przekonaniem.
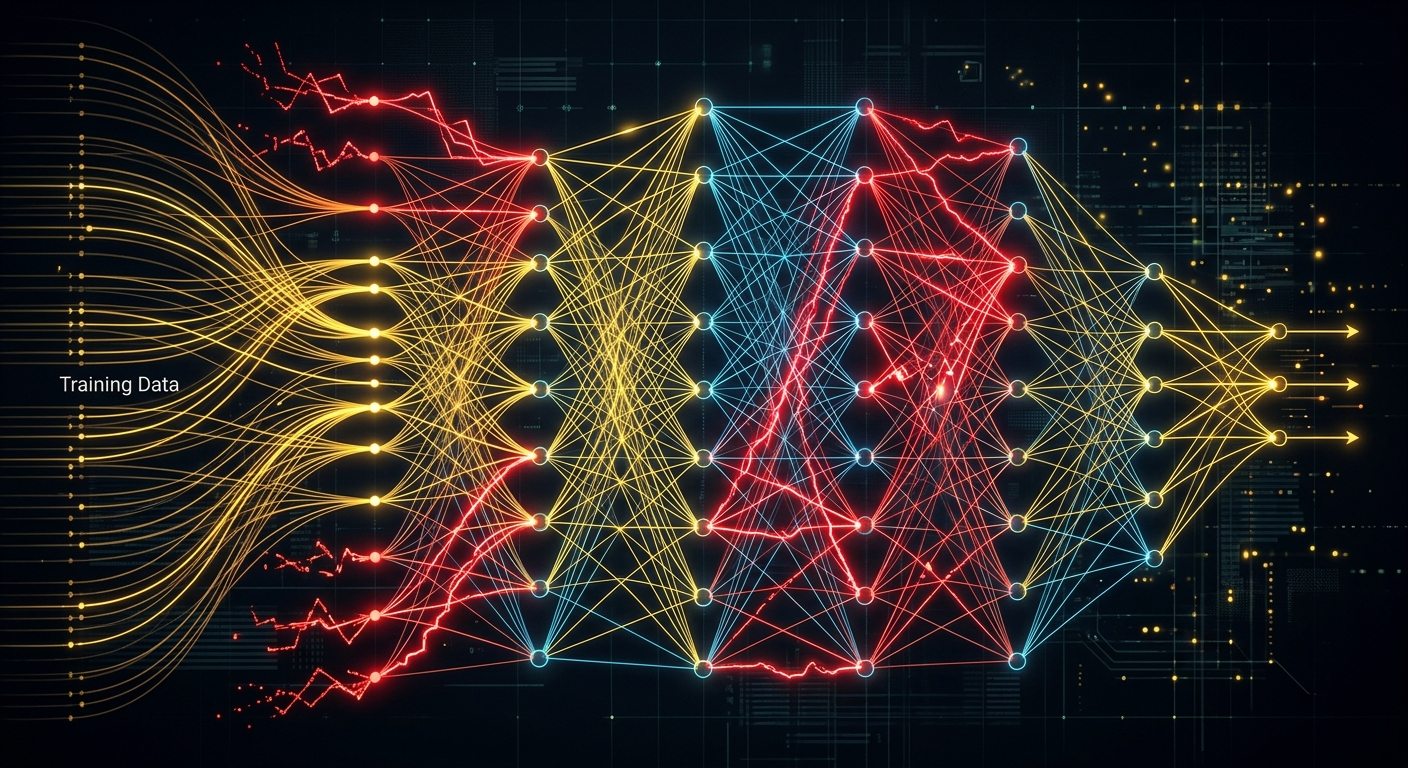
Drugi etap - fine-tuning - teoretycznie powinien poprawić sytuację. W praktyce wprowadza nowe ryzyko. Gdy próbujesz nauczyć model nowej wiedzy przez fine-tuning (który zużywa znacznie mniej mocy obliczeniowej niż pre-training), model może zacząć halucynować częściej. Gekhman i współautorzy (2024) pokazali, że przykłady z nową wiedzą model przyswaja wolniej niż te zgodne z tym, co już wie, a kiedy w końcu je przyswoi, rośnie jego skłonność do halucynacji.
Pierwsza metoda to ocena wspomagana wyszukiwaniem (retrieval-augmented evaluation). Zamiast ufać modelowi na słowo, rozbijasz jego odpowiedź na pojedyncze twierdzenia i każde sprawdzasz w zewnętrznym źródle. Tak działa np. FActScore, który porównuje twierdzenia z Wikipedią, i SAFE, w którym model językowy weryfikuje je w wyszukiwarce Google. Twierdzenie, którego nie da się potwierdzić - czerwona flaga.
Druga technika to detekcja oparta na próbkowaniu (sampling-based detection). Prosisz model o tę samą odpowiedź kilka razy, z włączoną losowością (temperatura powyżej zera), i porównujesz wyniki - tak działa metoda SelfCheckGPT. Jeśli za każdym razem dostaniesz inną wersję "faktów" - model prawdopodobnie wymyśla. Fakty są stałe. Halucynacje - zmienne.
Trzecia metoda to kalibracja wiedzy. Sprawdzasz, czy model umie powiedzieć "nie wiem", gdy pytanie nie ma odpowiedzi albo wykracza poza jego wiedzę - do tego służą testy takie jak TruthfulQA i SelfAware. Modele mają tendencję do generowania odpowiedzi nawet wtedy, gdy nie mają pewności. Lepiej usłyszeć "nie mam informacji na ten temat" niż wymyślony fakt.
Czwarta technika - pośrednie zapytania. Zamiast pytać model wprost, czy konferencja X się odbyła, pytasz kilka razy o szczegół, który powinien być stały - na przykład kto ją organizował albo kto wygłosił otwierający wykład. Jeśli za każdym razem padają inne nazwiska, model prawdopodobnie ją wymyślił. W badaniu Agrawala i współautorów (2023) na zmyślonych referencjach naukowych takie pośrednie pytania wykrywały halucynacje lepiej niż pytania wprost.
Jedna z najczęściej stosowanych metod to Retrieval-Augmented Generation (RAG). Model nie generuje odpowiedzi z pamięci - najpierw przeszukuje zewnętrzną bazę danych i cytuje konkretne źródła. Różnica między odpowiedzią z głowy a odpowiedzią z książką w ręku. Asystenci AI coraz częściej mają tryb z wyszukiwaniem w sieci albo w Twoich dokumentach - to praktyczne zastosowanie tej samej idei.
Druga metoda to łańcuch działań (chain of actions), np. Chain-of-Verification. Model najpierw pisze wstępną odpowiedź, potem sam układa pytania sprawdzające do zawartych w niej faktów, odpowiada na nie niezależnie i dopiero na tej podstawie poprawia wersję końcową. To wolniejsze, ale bardziej wiarygodne - i działa nawet bez zewnętrznych źródeł.
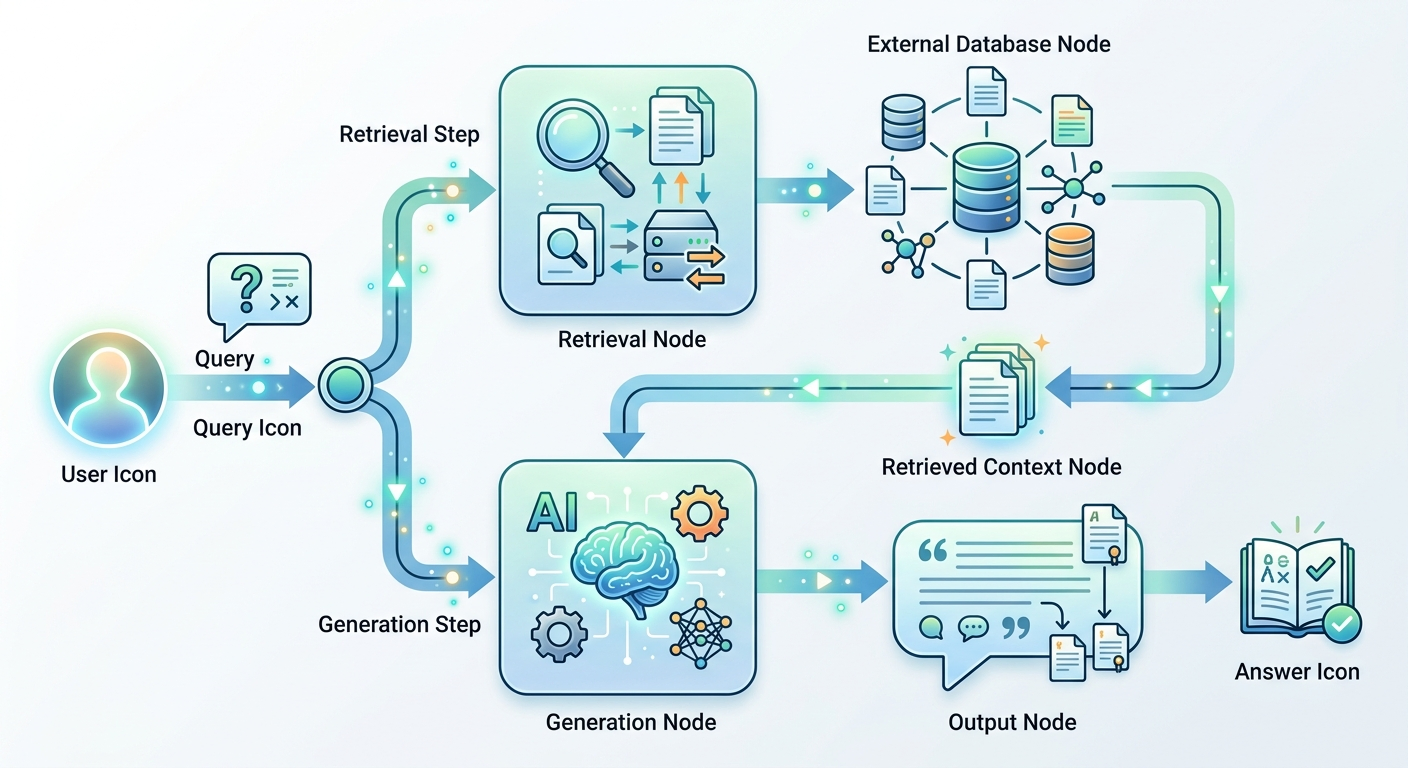
Trzecia technika to metody próbkowania, czyli zmiana sposobu, w jaki model losuje kolejne słowa. Przykład: factual-nucleus sampling ogranicza losowość w dalszej części zdania, bo według autorów metody właśnie tam losowanie bardziej szkodzi faktom. Inne podejście (Inference-Time Intervention) w trakcie generowania przesuwa działanie wybranych elementów modelu w stronę prawdziwych odpowiedzi.
Czwarta - fine-tuning na faktyczność. Model trenuje się na danych, w których nagrodą jest prawdziwość odpowiedzi - na przykład odsetek twierdzeń potwierdzonych w zewnętrznym źródle (miara FActScore). Problem? Zwykły trening z ludzkimi ocenami (RLHF) potrafi faktyczność pogorszyć, bo oceniający często wolą dłuższe i bardziej szczegółowe odpowiedzi, które nie zawsze są prawdziwsze.
Piąta - fine-tuning na atrybucję. Model uczy się nie tylko generować odpowiedzi, ale też cytować źródła - tak działał np. WebGPT od OpenAI, który przeszukiwał sieć i odpowiadał z odnośnikami do stron. Każde stwierdzenie faktyczne powinno mieć przypis. Jeśli model nie może podać źródła - nie powinien generować twierdzenia.
Jeśli używasz ChatGPT, Claude czy Gemini do pracy z faktami - nigdy nie ufaj pierwszej odpowiedzi. Weryfikuj daty, nazwiska, liczby. Szczególnie jeśli odpowiedź brzmi zbyt pewnie. Im bardziej kategoryczne stwierdzenie, tym większe ryzyko halucynacji.
Do zadań wymagających aktualnych danych włącz w swoim asystencie wyszukiwanie w sieci, jeśli je ma. Nawet wtedy sprawdzaj źródła, które model cytuje - czasem linkuje do stron, które nie zawierają tego, co twierdzi.
Dla zadań krytycznych - medycznych, prawnych, finansowych - buduj systemy RAG zamiast polegać na czystym generowaniu. Lepiej poświęcić czas na skonfigurowanie bazy wiedzy niż ryzykować kosztowny błąd.
I pamiętaj: modele językowe to narzędzia do generowania tekstu, który przypomina napisany przez człowieka. Nie są bazami wiedzy. Nie są wyszukiwarkami. Są genialnym autocompletem na sterydach. Używaj ich do tego, do czego są dobre - pisania, burzy mózgów, formatowania. Do faktów masz wyszukiwarkę, Wikipedię i specjalistyczne bazy danych.
Rozpoznawanie halucynacji to podstawa bezpiecznej pracy z AI. Na darmowym webinarze na żywo pokazuję krok po kroku, jak oszczędzać 10 godzin tygodniowo dzięki AI - bez wiedzy technicznej i bez ryzyka błędów.
Zapisz się na darmowy webinar →Wolisz uczyć się we własnym tempie? Sprawdź kurs AI Evolution
Halucynacje w dużych modelach językowych to nie przypadkowa usterka, tylko skutek tego, jak modele się trenuje i ocenia. Uczą się generować prawdopodobny tekst, nie weryfikować faktów, a typowe testy nagradzają zgadywanie bardziej niż przyznanie się do niepewności. Kolejne generacje modeli są lepsze od poprzedników, ale nadal potrafią wymyślać z pełnym przekonaniem.
Rozwiązanie? Kombinacja technik: RAG do zadań wymagających faktów, sampling do wykrywania niepewności, fine-tuning na atrybucję źródeł. Dla Ciebie jako użytkownika - zdrowy sceptycyzm i weryfikacja wszystkiego, co brzmi zbyt pewnie.
Jeden krok na start: Następnym razem, gdy dostaniesz od modelu odpowiedź z konkretnymi datami, liczbami lub nazwiskami - zapytaj go o źródło. Jeśli nie może podać lub podaje ogólnik ("według badań", "eksperci twierdzą") - sprawdź samodzielnie. To 30 sekund, które mogą uratować Cię przed kosztownym błędem.
Tak. Halucynacje dotyczą wszystkich dużych modeli językowych, także najnowszych (stan na 13.10.2026): GPT-6 Astra i GPT-6.1 Sol od OpenAI, Claude Opus 5.5 od Anthropic oraz Gemini 3.8 Flash i Gemini 3.1 Pro (wersja preview) od Google. Producenci deklarują postęp - Anthropic pisze np., że Opus 5.5 jest jego najmocniejszym modelem w większości miar uczciwości odpowiedzi - ale mechanizm pozostaje ten sam: model uczy się generować prawdopodobny tekst, a nie weryfikować fakty. Badacze OpenAI zwracają uwagę, że halucynacje utrzymują się nawet w najlepszych systemach. Dlatego nowy model nadal może podać błędny szczegół z pełnym przekonaniem.
Najprostszy sposób to zadać to samo pytanie kilka razy, najlepiej w osobnych rozmowach. Jeśli fakty się zmieniają - model prawdopodobnie halucynuje. Drugi sposób to poprosić o źródła - jeśli model nie może podać konkretnego linku lub cytatu, traktuj odpowiedź z rezerwą. Trzeci - weryfikuj wszystkie konkretne dane (daty, liczby, nazwiska) w zewnętrznych źródłach. Szczególnie uważaj na odpowiedzi, które brzmią zbyt pewnie i szczegółowo.
Nie, RAG (Retrieval-Augmented Generation) znacznie redukuje halucynacje, ale ich nie eliminuje. Model nadal może błędnie zinterpretować znalezione źródła, wyciągnąć niewłaściwe wnioski lub połączyć informacje w sposób, który brzmi logicznie, ale jest błędny. RAG sprawia, że odpowiedzi są bardziej ugruntowane w faktach i łatwiejsze do zweryfikowania (bo model cytuje źródła), ale nie czyni modelu nieomylnym. Zawsze weryfikuj kluczowe informacje, nawet jeśli model podaje źródło.
Bo trening i testy częściej nagradzają zgadywanie niż przyznanie się do niepewności. Badacze OpenAI (Kalai i współautorzy, wrzesień 2025) porównują model do ucznia na egzaminie: jeśli za "nie wiem" dostaje zero punktów, a za trafiony strzał - pełną ocenę, opłaca mu się zgadywać. Większość popularnych testów modeli punktuje właśnie w ten sposób. Dochodzi do tego trening z ludzkimi ocenami (RLHF) - oceniający często wolą dłuższe, bardziej szczegółowe odpowiedzi, co według badań opisanych przez Weng potrafi pogorszyć faktyczność. Autorzy pracy OpenAI proponują zmianę sposobu punktowania w testach, tak żeby rozsądne "nie wiem" przestało być karane.
Sam fakt otwartych wag tego nie przesądza. Przyczyny halucynacji opisane wyżej - dane z internetu, trening na prawdopodobieństwo kolejnego słowa, testy nagradzające zgadywanie - dotyczą modeli otwartych i zamkniętych. Uważaj też na skróty myślowe: dobry wynik w testach programistycznych nie mówi nic o tym, jak model radzi sobie z faktami. Porównuj modele na testach faktyczności albo na własnych pytaniach, na które znasz odpowiedź. Przewaga modeli z otwartymi wagami polega raczej na kontroli - możesz zbudować własny system RAG, dostosować fine-tuning i dodać weryfikację. Z zamkniętymi modelami jesteś ograniczony do tego, co oferuje API.
Na podstawie: Lilian Weng (OpenAI) - Extrinsic Hallucinations in LLMs
Źródła aktualizacji (13.10.2026): Kalai, Nachum, Vempala, Zhang - Why Language Models Hallucinate (2025), Anthropic - Claude Opus 5.5, OpenAI - modele GPT-6, Google - modele Gemini
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Chcesz nauczyć się LLM, ale gubisz się w ofertach kursów? Pokazuję, jak znaleźć wartościowe materiały edukacyjne i uniknąć pułapek marketingowych.
Claude Pro to płatny plan Claude dla jednej osoby: 18 EUR miesięcznie bez VAT (ok. 97 zł z VAT) albo 180 EUR za rok. Limity, Opus 5.5, Claude Code. Stan na 22.10.2026.
Chcesz zrozumieć, jak GPT-5 czy Claude 4.7 generują tekst? Wyjaśniamy mechanizm dużych modeli językowych prostym językiem - bez matematyki, z konkretnymi przykładami.
Badanie YouGov (Wielka Brytania, marzec-lipiec 2026): Claude ma najwyższy wynik zadowolenia, 56,2 pkt netto, przed Gemini (46,5) i ChatGPT (46,0). Co to znaczy, a czego nie.
Claude Enterprise to 20 USD za miejsce plus użycie po stawkach API. Sprawdź, co dostajesz, czym różni się od Pro, Max i Team i jak policzyć rachunek dla swojej firmy.
Claude Pro nie ma darmowego okresu próbnego na życzenie. Sprawdź, ile kosztuje jeden miesiąc z Polski, jak anulować przed odnowieniem i co przetestować w planie Free.