Modele AI
·
5 min czytania
·
22 września 2026
Light Origins otwiera kod robota, który uczy się z wideo ludzi
Przejdź do treści i przykładów

Źródło: Link
Źródło: Link
Mówią, że nauczenie robota poruszania się wymaga drogich kombinezonów do motion capture i miesięcy pracy w laboratorium. Firma Light Origins pokazuje inne podejście: wystarczy zwykłe nagranie wideo z człowiekiem. 21 września opublikowała Light-O1-Preview, model liczący około 6 miliardów parametrów, który uczy się ruchu z filmów, a potem próbuje przenieść tę wiedzę na roboty. Kod trafił na Hugging Face i GitHub na licencji Apache 2.0 - dowolna firma może go pobrać, przerobić i wykorzystać komercyjnie.
To nie jest kolejny gadżet do nawigacji. Light Origins ma już w portfolio LightNav-0, wcześniejszy system nawigacyjny dla robotów. Light-O1-Preview to coś innego - model, który ma sterować całym ciałem robota: rękami, nogami, pozą. Firma nazywa go "publicznym wycinkiem" większego projektu Light-O1, czyli fundamentowego modelu embodied AI trenowanego właśnie na ludzkich akcjach z wideo.
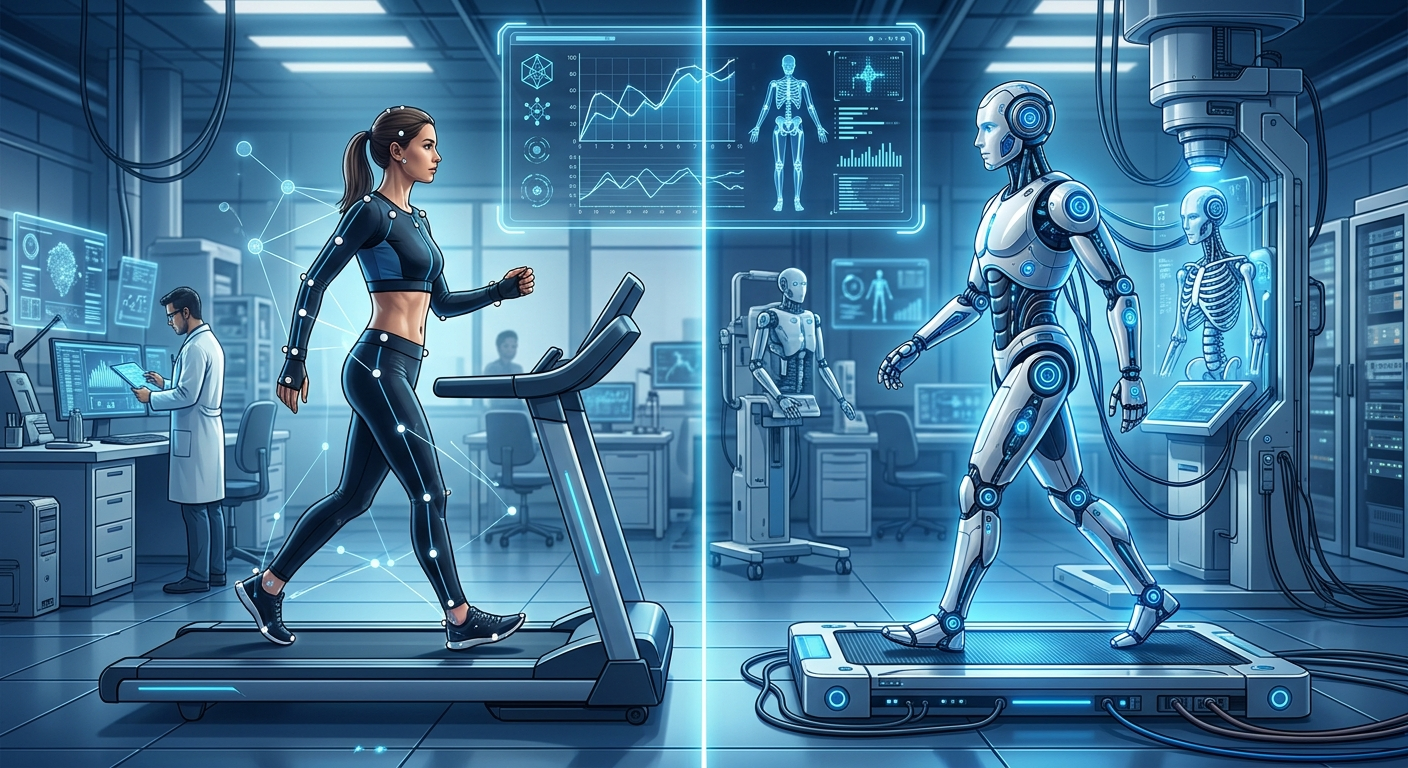
Cały proces zaczyna się od segmentacji ludzi w materiale wideo. Model wyodrębnia sylwetkę, rekonstruuje ruch w trzech wymiarach, a następnie zamienia trajektorię ciała, pozę i stan dłoni na dyskretne tokeny akcji. Te tokeny miesza się z tekstem i obrazem, po czym całość trafia do treningu w klasycznym, autoregresywnym transformerze - tej samej rodzinie architektur, która stoi za większością dzisiejszych dużych modeli językowych.
Innymi słowy: model traktuje ruch człowieka trochę jak zdanie do przewidzenia. Zamiast kolejnego słowa przewiduje kolejną pozycję ciała. To podejście, które w świecie modeli językowych sprawdziło się już wielokrotnie, teraz zostało przeniesione na grunt robotyki.
Wersja dostępna na Hugging Face to checkpoint 6B osadzony w drzewie modelu Qwen3.5-4B-Base. Działa to tak: podajesz instrukcję tekstową, model generuje krótki ślad rozumowania, a na wyjściu dostajesz sekwencję ruchów całego ciała przy 20 klatkach na sekundę. Każda klatka to 138 wartości - ruch podstawy ciała, wysokość miednicy, obrót, 22 stawy i stan otwarcia dłoni.
Jest jednak haczyk, o którym trzeba pamiętać, zanim pomyślisz, że wystarczy pobrać model i podłączyć go do robota. Light-O1-Preview generuje trajektorie ruchu, ale samo wdrożenie na fizycznym sprzęcie wymaga oddzielnego modelu zachowania albo kontrolera niskiego poziomu. Przykładowa ścieżka dla Unitree G1, którą dokumentuje firma, dziś działa w symulacji z dodatkowym checkpointem polityki sterowania. To nie jest gotowy system operacyjny dla robota - to warstwa priorytetów ruchu, którą trzeba dopiero uzbroić w resztę infrastruktury.
Firma podaje wynik 79,3% wskaźnika sukcesu (macro success rate) w symulacjach RoboCasa GR-1 dla scenariusza kuchennego, obejmującego 24 zadania. To liczba raportowana przez samą firmę, nie z niezależnego publicznego rankingu. W materiałach promocyjnych pojawiają się demonstracje na LightBot i Unitree G1 obejmujące klękanie, balansowanie, wycieranie i podnoszenie przedmiotów - wszystkie wykorzystujące ten sam ludzki prior ruchu.
Dla zespołów zajmujących się robotyką Light-O1-Preview to konkretna, darmowa do pobrania warstwa priorów ruchu, a nie kompletny system sterowania robotem. Otwarta licencja pozwala każdemu laboratorium czy firmie samodzielnie sprawdzić, czy twierdzenia o pretrainingu na wideo ludzkim się bronią. Jakość przenoszenia ruchu między różnymi typami robotów (tzw. cross-embodiment loco-manipulation) wciąż zależy od danych adaptacyjnych i kontrolerów, które w dużej mierze pozostają zastrzeżone.
To zresztą trend, który widzimy coraz częściej w AI - podobnie jak w przypadku otwartych modeli językowych typu DeepSeek, firmy chętniej dzielą się rdzeniem technologii, zatrzymując dla siebie ostatnią, najbardziej kosztowną warstwę wdrożeniową. Otwarte wagi budują zaufanie i przyciągają społeczność deweloperską, ale prawdziwe wdrożenie na sprzęcie wciąż wymaga know-how, którego nikt nie oddaje za darmo.
Jeśli działasz w automatyce przemysłowej albo prowadzisz startup robotyczny, to sygnał, żeby obserwować ten segment rynku - koszt wejścia w budowę własnych modeli sterowania ruchem spada, bo nie musisz już zbierać danych motion capture od zera. Wystarczy dobrze oznaczone wideo, a resztą zajmuje się architektura transformerowa, którą znasz już z innych zastosowań dużych modeli.
Ciekawi Cię, jak firmy wdrażają AI w praktyce? Modele takie jak Light-O1-Preview pokazują, że granica między AI tekstowym a fizycznym światem coraz szybciej się zaciera. Jeśli zastanawiasz się, jak podobne mechanizmy automatyzacji przełożyć na własną firmę, zobacz konkretne przypadki wdrożeń. Zobacz wdrożenia AI dla firm →
Tak, model jest dostępny na Hugging Face i GitHub na licencji Apache 2.0, czyli można go pobrać, modyfikować i wykorzystywać komercyjnie bez opłat licencyjnych.
Nie. Model generuje trajektorie ruchu, ale ich wdrożenie na fizycznym sprzęcie wymaga dodatkowego modelu zachowania lub kontrolera niskiego poziomu. Przykład Unitree G1 dokumentowany przez firmę działa obecnie w symulacji.
LightNav-0 to wcześniejszy system Light Origins do nawigacji robota. Light-O1-Preview odpowiada za sterowanie całym ciałem - postawą, kończynami i dłońmi - a nie za poruszanie się po przestrzeni.
Firma odzyskuje ruch człowieka z nagrań wideo, rekonstruując go w trójwymiarze i zamieniając na tokeny akcji. Model dodatkowo adaptuje się na danych z teleoperacji Unitree G1 oraz własnym korpusie LightBot.
Nie do końca - wynik 79,3% skuteczności w symulacjach RoboCasa GR-1 pochodzi z testów przeprowadzonych przez samą firmę, a nie z publicznego, niezależnego rankingu.
Na podstawie: Pandaily
10 gotowych promptów do codziennej pracy + 5 narzędzi + plan na pierwszy tydzień. PDF, 4 strony konkretu.

DeepSeek-V4-Flash-Vision-Exp trafił na Hugging Face na licencji MIT. Model V4 po raz pierwszy widzi obrazy, nie tylko czyta tekst.

Nvidia udostępniła model AI dla autonomicznych pojazdów. 34 miliardy parametrów, otwarta licencja i pierwsze miejsce w benchmarku LingoQA. Sprawdzamy, co to zmienia dla rynku robotaxi.
Tencent open-sources'uje WeKnora, platformę RAG-to-agent z ponad 25 tys. gwiazdek na GitHubie, wraz z oficjalną wtyczką do DeepSeek Harness dla firmowych baz wiedzy.
DeepSeek pokazuje V4.1-Flash z encoder-decoder MoE, milionem tokenów kontekstu i kompresją KV do ~890 bajtów na token. Architektura ma obniżyć koszt agentów AI.
Baseten uruchamia Base Labs - grupę badawczą, która razem z Hugging Face i Goodfire ma opracować i publikować metody bezpiecznego trenowania modeli open-weight.

John Deere uruchamia asystenta „JD” opartego na danych z pola i maszyn. Firma znana z wojny o prawo do naprawy teraz obiecuje kontrolę nad danymi farmerom.