Zespół, który wrzuca do agenta AI milion tokenów dokumentacji - całą bazę wiedzy firmy, historię maili, logi z systemu - dostaje na koniec miesiąca rachunek za API, który każe zapytać dział finansowy o dodatkowy budżet. Problem nie leży w samym modelu, tylko w tym, co dzieje się "pod maską": im dłuższy kontekst, tym więcej pamięci model musi trzymać w tzw. cache KV (Key-Value), żeby w ogóle pamiętać, o czym była mowa dwa akapity wcześniej. To jest właśnie ten cichy koszt, który zjada budżety firm testujących długie sesje z AI.
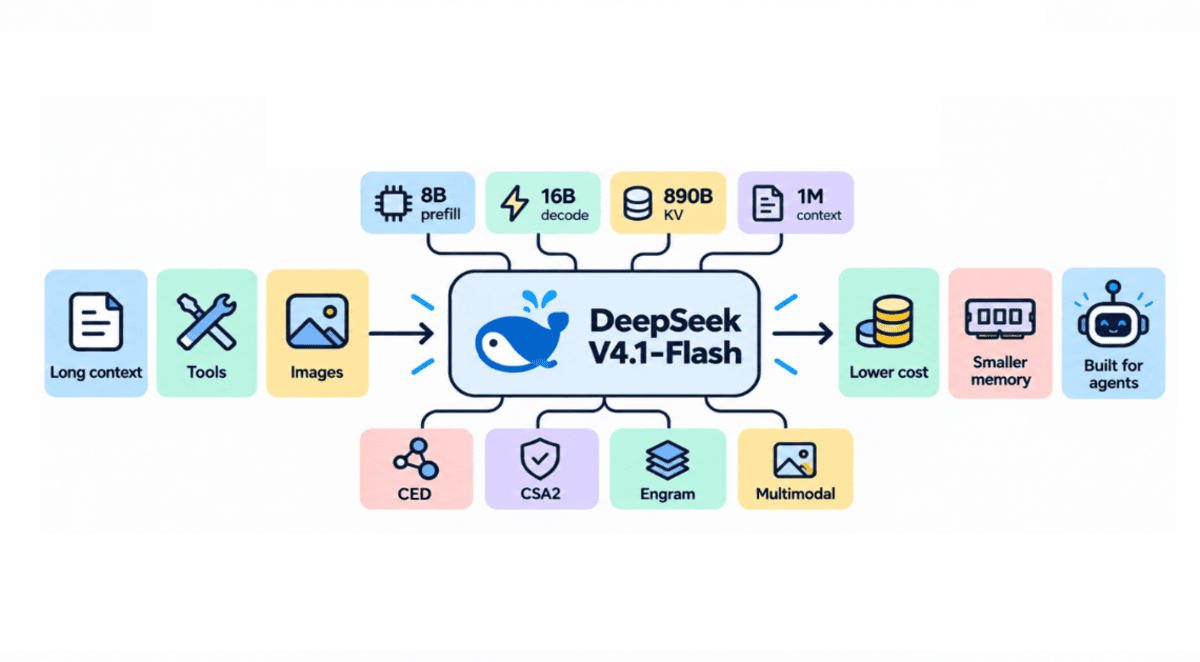
DeepSeek postanowił zaatakować dokładnie ten problem. Firma pokazała DeepSeek-V4.1-Flash - model z rodziny Mixture-of-Experts liczący 552 miliardy parametrów, multimodalny, z oknem kontekstu sięgającym miliona tokenów. Dostępny jest przez API pod nazwą deepseek-flash. Prawdziwa historia nie kryje się jednak w liczbie parametrów - liczy się architektura, która ma sprawić, że obsługa takich gigantycznych sesji będzie tańsza niż dotychczas.
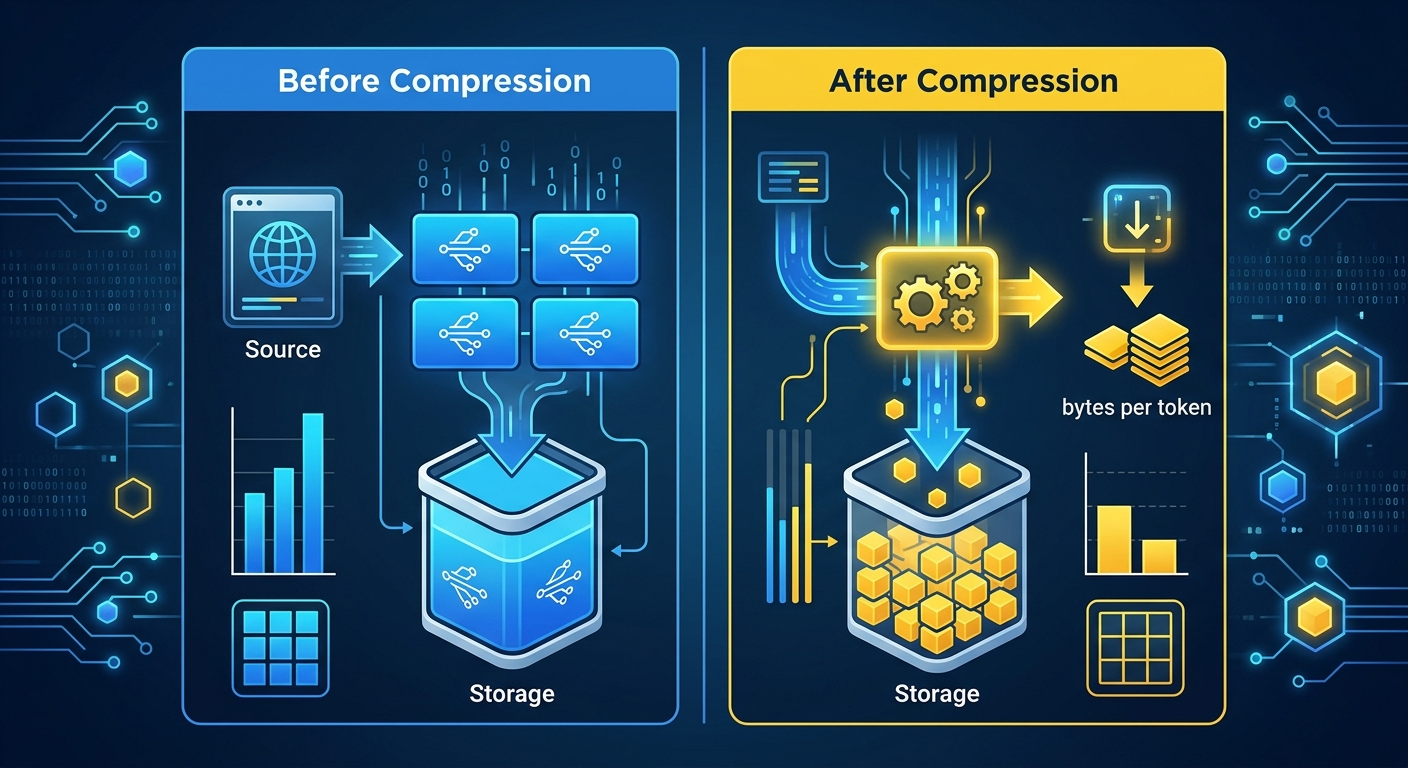
Kompresja pamięci kontekstu to klucz do tańszych sesji z długim kontekstem AI.
Rachunek za pamięć modelu, czyli dlaczego długi kontekst boli portfel
Klasyczne modele językowe, gdy przetwarzają długi tekst, muszą trzymać w pamięci reprezentację każdego wcześniejszego tokenu - to właśnie ten ty cache KV. Przy oknie kontekstu rzędu miliona tokenów ta pamięć rośnie do rozmiarów, które wymagają drogiego sprzętu i podnoszą koszt każdego zapytania. Dla firm budujących agentów AI działających w długich sesjach - obsługa klienta, analiza dokumentów, automatyzacja procesów - to realna bariera kosztowa, nie teoretyczny problem inżynierski.
DeepSeek pisze wprost, że framing tego wydania to architektura i tania obsługa długiego kontekstu, a nie polityka czy wyścig zbrojeń w liczbie parametrów. To dość rzadkie podejście na rynku, gdzie zwykle liczy się głównie to, kto ma większy model.
Encoder-decoder zamiast symetrycznego MoE
Zamiast typowej, symetrycznej architektury Mixture-of-Experts, V4.1-Flash korzysta z układu nazwanego Causal Encoder-Decoder. To 40-warstwowy Transformer podzielony na 20 warstw przyczynowego enkodera i 20 warstw dekodera. Różnica praktyczna: przy przetwarzaniu wejścia (prefill) model aktywuje około 8 miliardów parametrów na token, a dopiero przy generowaniu odpowiedzi (decode) - około 16 miliardów.
Dla zadań, w których agent AI głównie czyta - analizuje długie dokumenty, przegląda logi, przetwarza kontekst - to oznacza mniejszy koszt obliczeniowy niż w symetrycznych modelach MoE podobnej wielkości. Krótko mówiąc: model płaci mniej za samo "patrzenie" na dane, a więcej dopiero, gdy faktycznie musi coś odpowiedzieć.
Kompresja KV: liczby, które robią różnicę
Tu dochodzimy do sedna. DeepSeek wprowadził mechanizm o nazwie Compressed Sparse Attention 2 (CSA2), który przypisuje warstwom modelu jeden z trzech trybów: Full, Reindex albo Reuse. W połączeniu z cache KV w formacie FP4 pozwala to zredukować globalny footprint pamięci do około 890 bajtów na token - to około jedna czwarta tego, co zajmował poprzedni DeepSeek-V4-Flash.
Do tego dochodzi mechanizm SWA Bounded Replay, który ogranicza trwałe zapotrzebowanie na pamięć SSD dla cache KV do około jednej ósmej. W praktyce oznacza to, że długie sesje - te milionotokenowe - nie muszą już wymagać kosztownej infrastruktury dyskowej w takiej skali jak dotychczas.
Redukcja pamięci KV do ~890 bajtów na token to jedna czwarta poprzedniej generacji.
Trening na 45 bilionach tokenów i pierwsze wyniki
Model przeszedł trening na około 45 bilionach tokenów multimodalnych. Sparse attention testowano najpierw przy sekwencjach 64K, a dopiero później w procesie pretreningu rozszerzono kontekst do pełnego miliona tokenów. Po treningu podstawowym doszły standardowe etapy: nadzorowane dostrajanie (SFT), uczenie ze wzmocnieniem (RL) oraz on-policy distillation, wsparte automatyczną syntezą zadań agentowych na dużą skalę.
Przy maksymalnym poziomie "reasoning effort" DeepSeek podaje trzy wyniki testów agentowych: Terminal-Bench 2.1 na poziomie 90,6, DeepSWE v1.1 na poziomie 74,2 oraz AutomationBench na poziomie 54,8. Model ma też natywną obsługę obrazu dzięki własnemu enkoderowi wizji DeepSeek-ViT, budowanemu od zera, a nie doklejonemu do istniejącego modelu tekstowego.
Otwarte wagi na Hugging Face i koniec ery V4 Pro
DeepSeek publikuje wagi modelu oraz gotowe przepisy do inferencji na Hugging Face, na licencji MIT - czyli w praktyce bez ograniczeń w komercyjnym wykorzystaniu. Firma zapowiada też wsparcie dla open-source'owych adapterów inferencji przy większych wdrożeniach, co ma znaczenie dla firm, które chcą hostować model u siebie, a nie tylko przez API.
Starsze aliasy V4 Flash tymczasowo przekierowują ruch do V4.1-Flash.
DeepSeek planuje wygasić routing V4 Pro na rzecz nowego SKU Flash.
Model dostępny jest w API pod nazwą deepseek-flash.
Dla polskich firm i zespołów developerskich testujących modele agentowe ta zmiana ma konkretne znaczenie: otwarta licencja MIT i tańsza obsługa długiego kontekstu obniżają barierę wejścia do budowania własnych rozwiązań na bazie DeepSeek, bez konieczności płacenia za drogie zamknięte API. To nie jest przełom porównywalny z premierami dużych modeli od Google czy OpenAI, ale konkretny krok w stronę tego, żeby agent AI czytający miliony tokenów przestał być luksusem zarezerwowanym dla największych budżetów.
Modele takie jak DeepSeek zmieniają się co miesiąc. Jeśli chcesz zrozumieć, które z nich naprawdę warto wykorzystać w codziennej pracy - i jak to zrobić bez znajomości kodu - zapisz się na darmowy webinar, na którym pokazujemy to krok po kroku. Zapisz się na darmowy webinar →
Najczęstsze pytania
Czym DeepSeek-V4.1-Flash różni się od poprzedniej generacji?
Kluczowa różnica to architektura Causal Encoder-Decoder zamiast symetrycznego Mixture-of-Experts oraz nowa kompresja pamięci KV (CSA2 z FP4), która zmniejsza zużycie pamięci do około 890 bajtów na token - czyli około jedną czwartą tego, co zajmował poprzedni DeepSeek-V4-Flash. Do tego dochodzi okno kontekstu rozszerzone do miliona tokenów.
Czy DeepSeek-V4.1-Flash jest darmowy i open source?
Wagi modelu i przepisy do inferencji są publikowane na Hugging Face na licencji MIT, co pozwala na komercyjne wykorzystanie bez dodatkowych opłat licencyjnych. Dostęp przez API pod nazwą deepseek-flash to osobna, płatna opcja dla tych, którzy nie chcą hostować modelu samodzielnie.
Co oznacza kompresja KV dla zwykłego użytkownika biznesowego?
W praktyce mniejsze zużycie pamięci przekłada się na niższy koszt obsługi długich sesji z AI - na przykład analizy obszernych dokumentów czy pracy agenta na dużej historii rozmów. To realna oszczędność dla firm, które regularnie korzystają z modeli AI przy dużych ilościach danych wejściowych.
Czy V4.1-Flash zastępuje starsze wersje DeepSeek?
Tak, starsze aliasy V4 Flash tymczasowo przekierowują ruch do V4.1-Flash, a DeepSeek planuje docelowo wygasić routing modelu V4 Pro na rzecz nowego SKU Flash. Oznacza to, że osoby korzystające dotychczas ze starszych nazw modeli w API automatycznie trafią na nową wersję.
Pasjonat sztucznej inteligencji, który od 18 lat działa z sukcesem biznesowo i szkoleniowo. Wprowadzam AI do swoich firm oraz codziennego życia. Fascynują mnie nowe technologie, gry wideo i składanie klocków Lego - tam też widzę logikę i kreatywność, które AI potrafi wzmacniać. Wierzę, że dobrze użyta sztuczna inteligencja to nie ogłupiające ułatwienie, lecz prawdziwy przełom w sposobie, w jaki myślimy, tworzymy i pracujemy.
DeepSeek udostępnił nowy model Vision, który analizuje obrazy, dokumenty i zrzuty ekranu. Cel jest prosty: mniej klikania, więcej działania po stronie AI.
Anonimowy model Ox Alpha w kilka dni przerwał 56-dniową serię DeepSeek na OpenCode i pobił rekord użycia na OpenRouter. Teraz trwa polowanie na jego twórcę.