Transformery AI - co to jest i jak działają (bez matematyki)
Przejdź do treści i przykładów
Źródło: Link
Źródło: Link
Mind Architect to 180-dniowy program Jana Gajosa: decyzje, nawyki i granice przeniesione do codziennych reakcji. 180 lekcji w 6 modulach, Manfred AI Coach i powtorki rozlozone w czasie.
Transformer to architektura sieci neuronowej, na której stoją dzisiejsze duże modele językowe (LLM). Opisał ją zespół badaczy, głównie z Google, w czerwcu 2017 roku w pracy "Attention Is All You Need" - pierwotnie do tłumaczenia tekstów. Litera T w skrócie GPT oznacza właśnie Transformer, a Google i Anthropic opisują swoje modele Gemini i Claude jako modele oparte na transformerze. W największym skrócie transformer dzieli tekst na tokeny, dla każdego z nich sprawdza, które inne fragmenty są dla niego ważne (to mechanizm uwagi, ang. attention), a potem przewiduje kolejny fragment odpowiedzi - token po tokenie.
Aktualizacja 13.10.2026: połączyliśmy w tym tekście nasze wcześniejsze poradniki o transformerach i zaktualizowaliśmy przykłady modeli do stanu na 13.10.2026.
Nie musisz tego wszystkiego wiedzieć, żeby korzystać z ChatGPT. Ale jeśli chcesz używać AI świadomie - pisać lepsze polecenia, rozpoznawać, kiedy model zgaduje, i dobierać narzędzie do zadania - warto zrozumieć ten jeden mechanizm. Ten przewodnik nie jest kursem programowania: pokażę Ci, jak transformery działają, bez wzorów matematycznych i bez kodu. Jeśli pracujesz w marketingu, edukacji albo zarządzaniu projektami i chcesz rozumieć narzędzia, których używasz - ten artykuł jest dla Ciebie.
Nie potrzebujesz żadnej wiedzy technicznej. Wystarczy, że kiedykolwiek użyłeś ChatGPT, Claude lub Gemini. Jeśli wiesz, czym jest prompt (polecenie dla AI) i odpowiedź - masz wszystko, czego trzeba.
Transformery to nie magia, tylko konkretna metoda przetwarzania tekstu, która pozwala modelowi uwzględniać kontekst. Ta sama architektura pracuje też z obrazem i dźwiękiem - o tym dalej.
Weź słowo "zamek". W zdaniu "Zamek w drzwiach się zaciął" chodzi o mechanizm, w zdaniu "Zwiedziliśmy zamek w Malborku" - o budowlę. Człowiek rozpoznaje to od razu, po sąsiednich słowach. Model musi zrobić to samo.
Wcześniejsze sieci do przetwarzania języka (rekurencyjne, w skrócie RNN, i ich odmiana LSTM) czytały tekst krok po kroku, słowo po słowie. Przez to trenowały się wolno i gorzej łączyły słowa, które w tekście stoją daleko od siebie. Autorzy transformera całkowicie zrezygnowali z rekurencji: tekst, który model ma już przed sobą, przetwarza naraz.
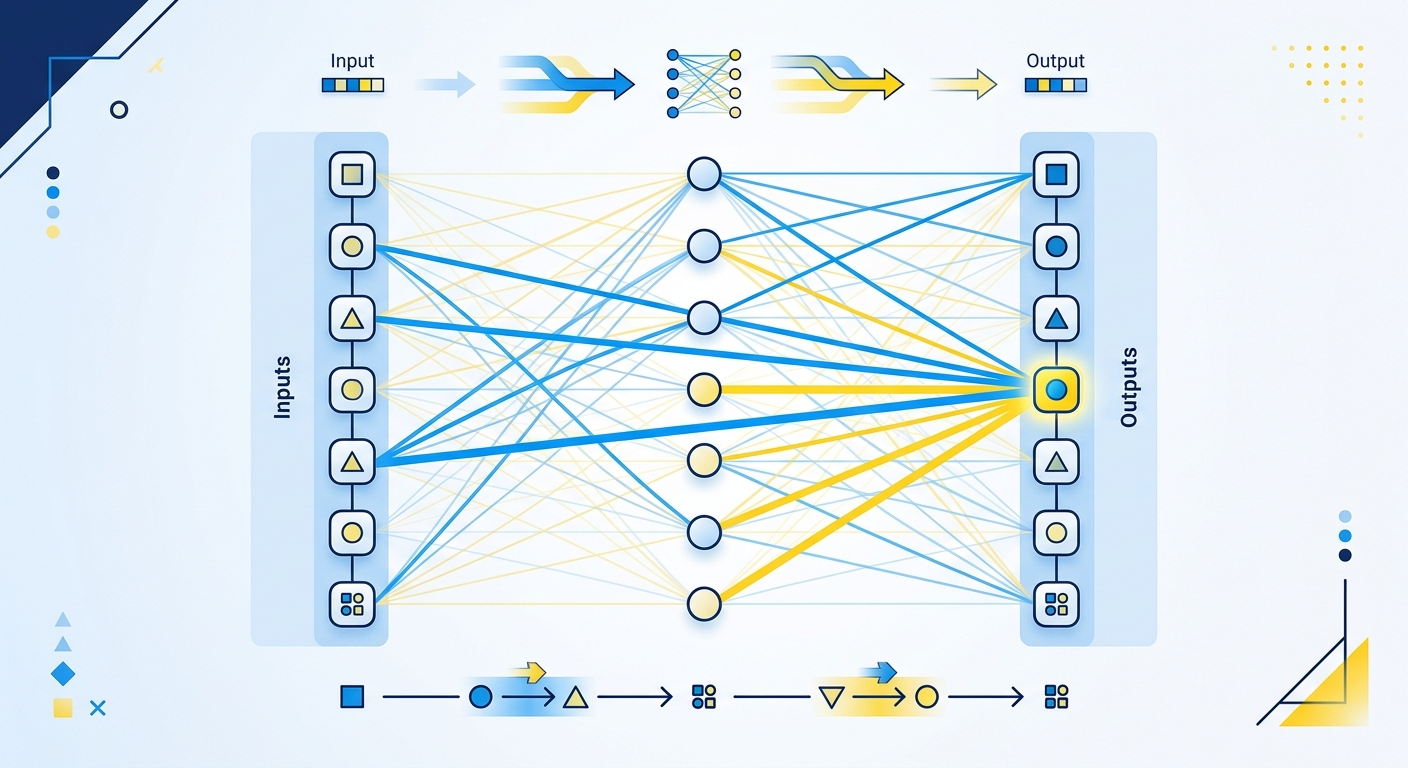
Zamiast niej transformer ma mechanizm uwagi (attention). Model widzi cały fragment tekstu naraz i dla każdego słowa sprawdza, które inne słowa są dla niego istotne. W zdaniu o drzwiach "zamek" "patrzy" na "drzwiach" i "zaciął" - i model traktuje go jak mechanizm, a nie budowlę.
Drugi przykład: "Ala oddała Kasi książkę, bo już ją przeczytała". Do kogo albo do czego odnosi się "ją" - do Kasi czy do książki? Uwaga pozwala modelowi powiązać "ją" z "książką", choć te słowa nie stoją obok siebie. Model ma przy tym kilka takich mechanizmów działających równolegle (to tzw. głowy uwagi - w podstawowej wersji oryginalnego transformera było ich 8, w największej 16), więc może jednocześnie śledzić różne rodzaje powiązań między słowami.
Wpisujesz prompt: "Napisz mail do klienta, który zgłosił reklamację". Model nie analizuje tego wyraz po wyrazie. Widzi całość naraz: "mail", "klient", "reklamacja" - i te słowa razem kierują odpowiedź w stronę uprzejmego maila z działu obsługi klienta. Każde słowo "rozmawia" z pozostałymi, a odpowiedź powstaje z tych powiązań.
Model nie operuje na całych słowach, tylko na tokenach: słowach, ich kawałkach albo pojedynczych znakach. Jedno słowo może więc dać jeden token albo kilka. Ile tokenów wyjdzie z danego tekstu, zależy od modelu i od języka - Anthropic zaznacza to wprost w dokumentacji Claude.
Dla modelu "kot" to nie futrzasty zwierzak, tylko ciąg liczb, czyli wektor (fachowo: embedding). Te liczby kodują znaczenie: słowa o podobnym sensie mają podobne wektory. "Pies" i "kot" leżą blisko siebie, "samochód" dalej, "demokracja" jeszcze dalej.
Do wektora każdego tokenu model dodaje informację o jego pozycji w tekście. Bez niej zdania "Pociąg jedzie z Krakowa do Warszawy" i "Pociąg jedzie z Warszawy do Krakowa" wyglądałyby dla mechanizmu uwagi prawie tak samo - te same słowa, inna kolejność, przeciwny kierunek jazdy.
Na wektorach działa wyszukiwanie "po sensie". Gdy system szuka tekstów o "zdrowym odżywianiu", porównuje wektor zapytania z wektorami dokumentów i znajduje też teksty o "zbilansowanej diecie", choć nie pada w nich żadne słowo z zapytania. Tak działają wyszukiwanie semantyczne i systemy RAG, które podsuwają modelowi Twoje dokumenty.
To też wyjaśnia, dlaczego precyzyjne promptowanie ma sens. Im konkretniej opiszesz zadanie, tym mniej model musi zgadywać, o który z możliwych sensów Ci chodzi.
Cały proces to kilka etapów. Gdy zrozumiesz ich logikę, łatwiej przewidzisz, co model zrobi z Twoim poleceniem.
Wklejasz 5-stronicowy raport. Model widzi cały tekst naraz: nagłówki, dane, wnioski. Mechanizm uwagi łączy "wzrost sprzedaży o 15%" z "Q2" i "regionem EMEA", bo w tekście opisują ten sam fakt. Gdy model pisze podsumowanie, te powiązane fragmenty mają dla niego dużą wagę.
Starsza sieć rekurencyjna musiałaby nieść treść raportu słowo po słowie w jednym, ciągle nadpisywanym "stanie" - im dłuższy tekst, tym trudniej połączyć koniec z początkiem. Transformer ma cały tekst naraz, w granicach tzw. okna kontekstu. We wszystkich obecnych modelach Claude (Fable 5.1, Opus 5.5, Sonnet 5.5 i Haiku 5.5) to 1 mln tokenów (stan na 13.10.2026). Jak to wygląda w codziennej pracy, porównujemy w tekście Claude czy ChatGPT - co lepsze i do czego.
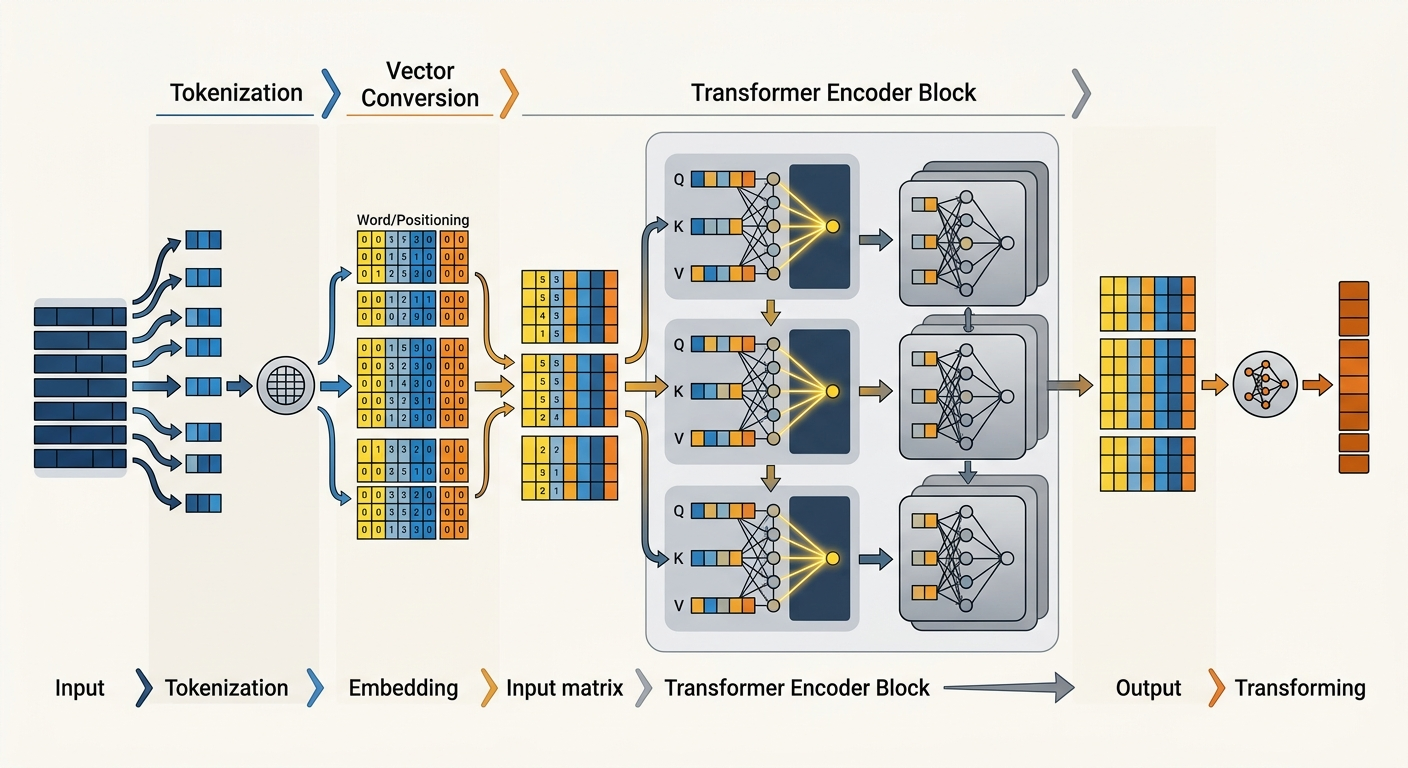
Model językowy w ChatGPT czy Claude robi w gruncie rzeczy jedną rzecz: przewiduje, co powinno pojawić się dalej. Anthropic opisuje to w dokumentacji wprost - model bazowy Claude jest najpierw trenowany na ogromnym zbiorze tekstów tak, żeby przewidywał następne słowo na podstawie wcześniejszego kontekstu.
Model dostaje początek zdania "Kot siedzi na" i liczy prawdopodobieństwo wielu możliwych dalszych słów: wysoko wypada "parapecie" czy "kanapie", niżej "dachu", prawie zero - "pomidorze". Potem wybiera jedno słowo, dopisuje je do tekstu i liczy od nowa, już z nowym słowem w kontekście. I tak token po tokenie, aż odpowiedź będzie gotowa. To nazywa się generowaniem autoregresywnym.
Wybór nie zawsze pada na najbardziej prawdopodobne słowo. Parametr zwany temperaturą steruje losowością: wyższa daje bardziej różnorodne odpowiedzi, niższa - bardziej przewidywalne. Dlatego to samo pytanie zadane dwa razy może dać dwie różne odpowiedzi.

Sam trening na przewidywanie słów to nie wszystko. Taki model bazowy nie jest dobry w odpowiadaniu na pytania i wykonywaniu poleceń, dlatego producenci douczają go dalej, m.in. na ocenach ludzi (RLHF - uczenie ze wzmocnieniem na podstawie ludzkiej informacji zwrotnej). W 2022 roku OpenAI opisało, jak douczyło w ten sposób GPT-3 - tak powstał InstructGPT. Dzięki takiemu douczaniu czat odpowiada na pytania, zamiast tylko doklejać dalszy ciąg tekstu.
Z tego mechanizmu wynika ważna rzecz: płynna odpowiedź nie oznacza prawdziwej. Model składa tekst, który statystycznie pasuje do kontekstu. Jeśli czegoś nie wie, potrafi z równą pewnością "dopowiedzieć" coś, co tylko brzmi wiarygodnie - więcej o tym w części o ograniczeniach.
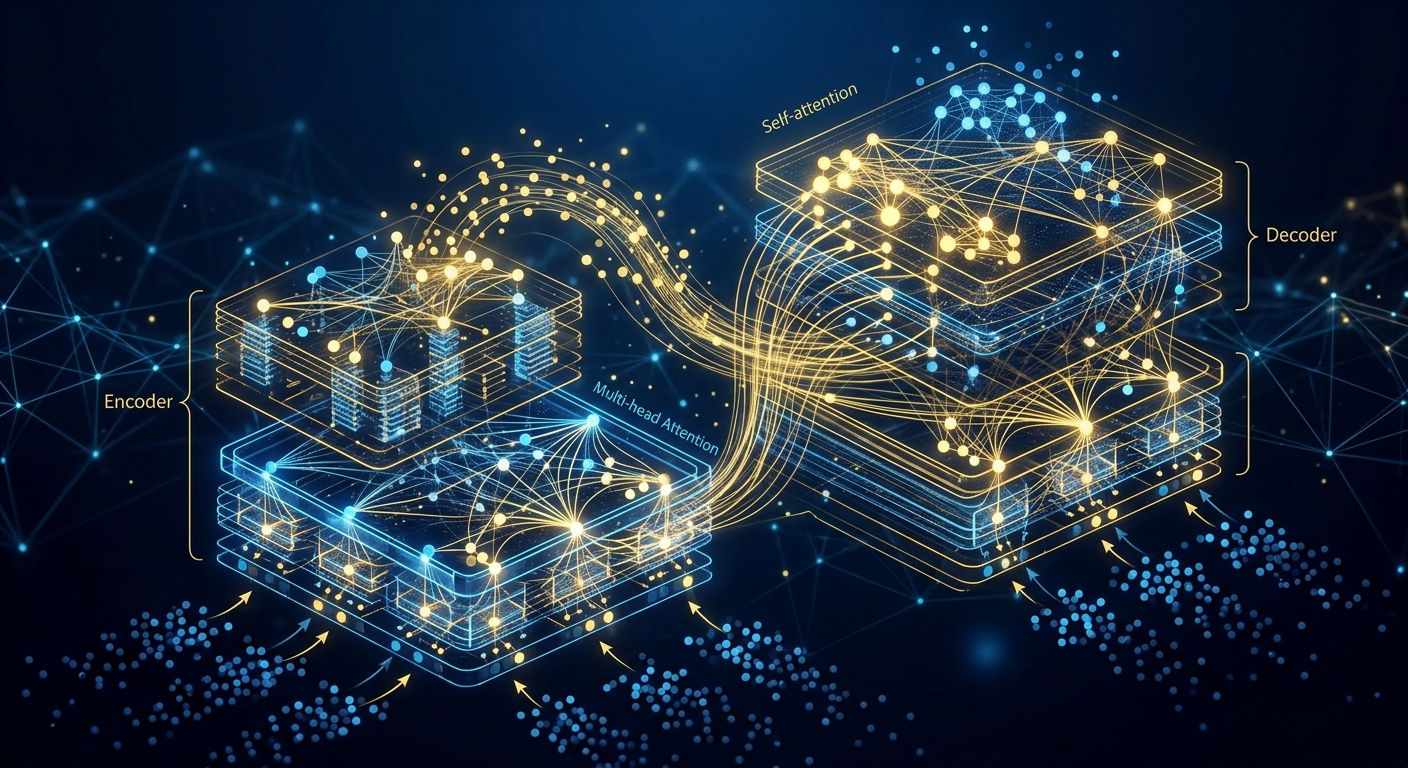
Oryginalny transformer z 2017 roku miał dwie części. Encoder czyta wejście i buduje jego reprezentację, a decoder na tej podstawie generuje wynik słowo po słowie. Z tego schematu wyrosły trzy rodziny modeli (podział za kursem Hugging Face):
Która odmiana pasuje do którego zadania i jak ten sam podział przenosi się na modele obrazu i dźwięku, rozpisaliśmy w poradniku jak transformery AI rozwiązują zadania.
Czat to tylko jedna twarz tej architektury. Kurs Hugging Face wymienia zadania z kilku dziedzin naraz:
Dla Ciebie liczy się efekt: wrzucasz trzy opinie klientów i dostajesz informację, które są pozytywne, a które pachną frustracją. Technikę ukrywa narzędzie: w bibliotece Transformers od Hugging Face takie zadanie uruchamia jedna funkcja (pipeline), która przygotowuje tekst dla modelu, przepuszcza go przez model i zamienia wynik w czytelną etykietę. Jeśli pracujesz na długich plikach, zobacz też, jak analizować dokumenty PDF z pomocą Claude.
Najkrótsza historia transformerów:
Co się zmieniło? Przede wszystkim skala i trening. GPT-2 mieścił w oknie kontekstu 1024 tokeny, a Claude Opus 5.5 czy GPT-6.1 Sol przyjmują około miliona tokenów naraz. Modele przechodzą też długie douczanie na ludzkich ocenach. Część z nich ma budowę typu Mixture-of-Experts (MoE): model składa się z wielu "ekspertów", a przy każdym tokenie pracuje tylko część z nich. Tak opisują swoją architekturę m.in. Google (Gemini 3 Pro, na którym bazuje Gemini 3.1 Pro) i DeepSeek (V4.1 Flash).
Co zostało? Zasada działania. W kartach tych modeli Google i DeepSeek nadal opisują je jako transformery, a fundament jest ten sam co w 2017 roku: tokeny, mechanizm uwagi i generowanie wyniku token po tokenie. Szczegóły - kodowanie pozycji RoPE, rzadką uwagę, sposoby na długi kontekst - znajdziesz w przewodniku jak zrozumieć rodzinę transformerów AI.
Mechanizm uwagi porównuje każdy token z każdym innym, więc liczba obliczeń w warstwach uwagi rośnie z kwadratem długości tekstu: dwa razy dłuższy tekst to mniej więcej cztery razy więcej pracy. Dlatego okno kontekstu ma granicę, a długie zapytania trwają dłużej i - przy płatności za tokeny - kosztują więcej.
Transformer przewiduje prawdopodobny tekst, nie sprawdza faktów. Autorzy pracy "Why Language Models Hallucinate" (2025, badacze OpenAI i Georgia Tech) tłumaczą, że sposób trenowania i testowania modeli nagradza zgadywanie, a nie przyznawanie się do niepewności. Efekt to odpowiedzi, które brzmią przekonująco, a są nieprawdziwe (tzw. halucynacje). Weryfikuj fakty, daty i liczby - szczególnie tam, gdzie błąd kosztuje.
Model wie tyle, ile było w danych, na których go trenowano. Dla Claude Opus 5.5 Anthropic podaje granicę wiarygodnej wiedzy na czerwiec 2026 - o późniejszych wydarzeniach model nie wie, chyba że dostanie wyszukiwarkę albo Twój dokument. Dane z internetu zawierają też uprzedzenia i błędy, które model może powtarzać - OpenAI ostrzegało o tym już przy GPT-2.
Badanie "Lost in the Middle" (2023, m.in. Uniwersytet Stanforda) pokazało, że badane modele najlepiej korzystały z informacji z początku i końca długiego kontekstu, a gorzej z tej ukrytej w środku. Duże okno nie gwarantuje, że model równie uważnie "przeczyta" każdą stronę.
Jeśli chcesz zobaczyć transformer na rysunkach, zacznij od "The Illustrated Transformer" Jaya Alammara. Według strony autora materiał wykorzystują kursy m.in. na Stanfordzie, Harvardzie, MIT, w Princeton i na CMU, a czytelnik ma do wyboru tłumaczenia na 10 języków. Żeby coś z niego zostało, czytaj go w trzech podejściach:
Bardziej uporządkowany, darmowy wstęp daje kurs LLM od Hugging Face (rozdział "How do Transformers work?"). Na naszej stronie pogłębisz temat w tekstach:
Otwórz ChatGPT albo Claude i wpisz dwa zdania: "Zamek w drzwiach się zaciął" i "Zwiedziliśmy zamek w Malborku". Poproś model, żeby wyjaśnił, co znaczy "zamek" w każdym z nich. Zobacz, jak rozróżnia oba znaczenia po sąsiednich słowach - to ten sam kontekst, o którym czytasz wyżej.
Ten poradnik to dopiero początek. W naszym kursie "Praktyczna AI" nauczysz się korzystać z ChatGPT, Claude i innych narzędzi AI w sposób systematyczny - od zera do zaawansowanego poziomu.
Sprawdź kurs →To architektura sieci neuronowych opisana w 2017 roku w pracy "Attention Is All You Need". Jej sercem jest mechanizm uwagi, który pozwala modelowi oceniać, które fragmenty tekstu są dla siebie ważne. Na transformerach opierają się duże modele językowe, m.in. GPT, Claude i Gemini, a także modele do rozpoznawania mowy i obrazów.
GPT to skrót od Generative Pre-trained Transformer, czyli generatywny, wstępnie wytrenowany transformer. "Generatywny" - bo tworzy tekst. "Wstępnie wytrenowany" - bo najpierw uczy się na ogromnym zbiorze tekstów, a dopiero potem jest douczany do konkretnych zadań. "Transformer" - bo taką ma architekturę. ChatGPT to czat OpenAI zbudowany na modelach GPT. Od 7 października 2026 OpenAI wdraża w zwykłej rozmowie w ChatGPT modele GPT-6: w planach Plus, Pro, Business i Enterprise GPT-6 Sol, w planach Free i Go - GPT-6 Luna.
Nie ma tego skrótu w nazwie, ale opis pasuje. Anthropic podaje w dokumentacji, że model bazowy Claude to autoregresyjny model językowy, wstępnie trenowany na przewidywanie następnego słowa, a w pracy z 2025 roku o wnętrzu jednego z modeli Claude opisuje badane modele jako modele językowe oparte na transformerze. Claude i GPT różnią się danymi, treningiem i szczegółami budowy, ale stoją na tej samej zasadzie.
GPT generuje tekst, przewidując kolejne tokeny i patrząc tylko wstecz. BERT czyta całe zdanie w obie strony naraz i służy przede wszystkim do rozumienia tekstu: klasyfikacji, wyszukiwania informacji, odpowiadania na pytania do podanego fragmentu. Oba są transformerami, tylko zbudowanymi z innych części (decoder i encoder).
Zasada jest ta sama. DeepSeek udostępnia wagi modelu V4.1 Flash na licencji MIT i w jego karcie opisuje go jako transformer typu Mixture-of-Experts z oknem do 1 mln tokenów. Otwarte wagi publikują też m.in. Meta (rodzina Llama 4) i Alibaba (rodzina Qwen 3). Różnica jest praktyczna: taki model można uruchomić na własnym, odpowiednio mocnym sprzęcie albo douczyć na swoich danych - zobacz, jak uruchomić lokalny model AI bez wysyłania danych do chmury.
Na podstawie: Vaswani i in. - Attention Is All You Need (2017), Hugging Face LLM Course - How do Transformers work?, Hugging Face LLM Course - Transformers, what can they do?, Jay Alammar - The Illustrated Transformer, Anthropic - Glossary, Google DeepMind - Gemini 3 Pro Model Card, Radford i in. - Language Models are Unsupervised Multitask Learners (GPT-2, 2019), Ouyang i in. - Training language models to follow instructions with human feedback (2022), Kalai i in. - Why Language Models Hallucinate (2025), Liu i in. - Lost in the Middle (2023), Anthropic - Models overview, DeepSeek - karta modelu DeepSeek-V4.1-Flash

Poznaj trzy architektury transformerów (encoder, decoder, encoder-decoder) i dowiedz się, dlaczego BERT, GPT-2 i BART rozwiązują różne zadania inaczej.
Poradnik po metodzie Grand Tour z Distill.pub - jak działa ta wizualizacja i co pokazuje o treningu sieci neuronowych, warstwach i atakach adversarialnych.
Ładowanie zapisanego modelu AI potrafi niepotrzebnie zdublować użycie pamięci. Pokazujemy, dlaczego tak się dzieje i jak tego uniknąć.
Dlaczego model AI myli się przy liczeniu liter i różnie liczy koszt tekstu w różnych językach? Winna jest tokenizacja - mało znany, ale kluczowy mechanizm modeli GPT.
Fine-tuning modeli AI nie wymaga farmy serwerów. Pokazujemy krok po kroku, jak dostroić model Whisper do rozpoznawania mowy na darmowym GPU w Colabie.
Adversarial prompting to nie hakerska ciekawostka, a realna dziura w działaniu dużych modeli językowych. Sprawdź, jak to działa i jak się przed tym chronić.