
Perplexity: OpenAI pokazuje liczby i chce wspólnych limitów dla AI
Przejdź do treści i przykładów

22 listopada 2026 Jakub Pachocki, Chief Scientist w OpenAI, opublikował na blogu firmy tekst, w którym proponuje, żeby twórcy modeli porównywali się jedną miarą: perplexity. OpenAI pokazuje własne pomiary z kolejnych modeli i postuluje wspólne limity rozwoju. Firmy nie przekraczałyby ich, dopóki nie nauczą się lepiej rozumieć i nadzorować AI. To deklaracja i propozycja jednej firmy, nie ustalony standard branży.
Nie, to nazwa miary. Bez technobełkotu: model językowy uczy się przewidywać następny fragment tekstu (tzw. token). Perplexity mierzy, jak dobrze mu to wychodzi średnio, a niższa wartość oznacza lepsze przewidywania. W praktyce OpenAI śledzi logarytm tej wartości, czyli cross-entropy loss.
Pachocki opisuje budowę nowoczesnej AI inaczej, niż zwykle budowało się oprogramowanie. Firmy nie projektują każdej umiejętności osobno. Najpierw trenują ogromny model (on nazywa go kompresorem albo predyktorem) na gigantycznym zbiorze danych. Potem promptowaniem, dotrenowaniem i uczeniem ze wzmocnieniem wydobywają z niego zdolności, które już w nim siedzą. Przypis dodaje, że ten kompresor to nie plik typu GZIP i nie musi "pamiętać" treści zbioru, na którym się uczył.
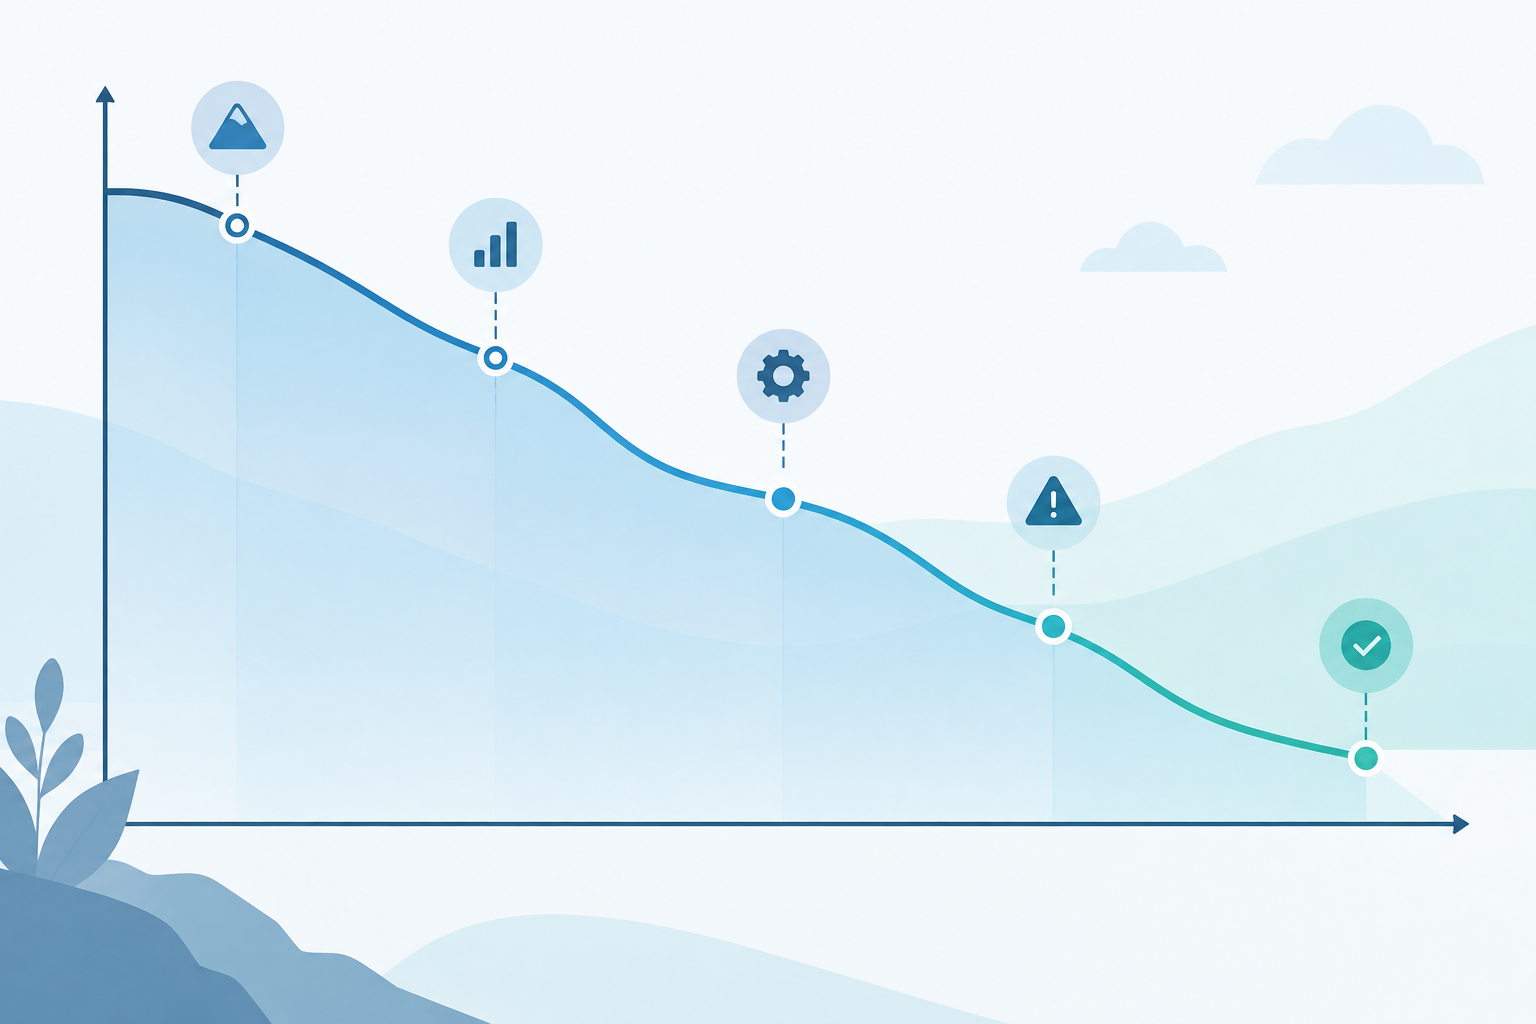
OpenAI liczy log-perplexity od GPT-3.5 na zbiorze testowym pochodzącym z własnej bazy kodu (stały snapshot). Oto, co Pachocki przypisuje poszczególnym progom:
Pachocki pisze, że widok kolejnych rozwiązań pojawiających się w jednym wątku na Slacku był dla matematyków w zespole mocno surrealistyczny. Podkreśla też, że z góry nie było wiadomo, iż te umiejętności wyskoczą akurat przy tych progach. To obserwacja po fakcie, nie prawo fizyki.
Dlaczego jedna miara, a nie zestaw testów? Bo testy się starzeją. Według Pachockiego dawne benchmarki były w większości wysycone około GPT-4, a oceny GPT-2 i GPT-3 na nowoczesnych testach nie miałyby sensu. Sprawdzanie dzisiejszych modeli egzaminem sprzed lat to tabliczka mnożenia dla kogoś, kto liczy całki. Jego zdaniem miara oparta na pretrainingu dłużej zachowa wartość informacyjną.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Pachocki spodziewa się kolejnych dużych skoków zdolności po wejściu w okno ok. 0,68-0,7 log-perplexity. Przyznaje, że nie wie, jakie to będą zdolności, i że dziś możemy ich nie testować. Zapowiada też dalszy spadek skuteczności obecnych form audytu zgodności modeli z intencjami twórców. Spodziewa się również wzrostu "świadomości" modeli, że są oceniane i trenowane.
Dlatego proponuje:
OpenAI nie podała, kiedy ani przy jakiej wartości miałby wejść pierwszy wspólny limit.
Pachocki zauważa, że najczęściej dyskutuje się o AI zastępującej badaczy na każdym etapie, aż do pełnego samodoskonalenia bez nadzoru człowieka. Taki stan uważa za coś, czego trzeba unikać. Jego zdaniem pomija się jednak węższy scenariusz: AI uczestniczącą w badaniach nad algorytmami pretrainingu. Skoro matematyka dostała lawinę wyników po zmianie modelu, podobna lawina fundamentalnych usprawnień mogłaby, jego zdaniem, ruszyć już w 2027. Przyspieszenie widoczne na wykresie w 2026 OpenAI przypisuje głównie długoletnim badaniom i inwestycjom w moce obliczeniowe, a w mniejszym stopniu automatyzacji. Skala tych inwestycji to temat tekstu o kosztach centrum danych pod AI.
Pachocki nie sprzedaje tej miary jako cudownej. To jego własna lista problemów:
Do tego dochodzi ostrzeżenie dla czytelnika. To pomiary OpenAI, wykonane przez OpenAI na jej własnym zbiorze kodu, a w tym tekście nie przytaczamy ich zewnętrznej weryfikacji. Liczby nie powiedzą też nic o tym, jak model radzi sobie po polsku. Do tego służą osobne testy, jak porównanie opisane w tekście o Bieliku 11B v3.1 w EuroEval. Przykład sprawdzania modelu na konkretnym zadaniu zamiast jedną miarą znajdziesz w tekście o GPT-6 Astra w testach Hebbii. Inną drogę, jeden zbiorczy indeks, pokazuje materiał o Gemini 4 Neon.
Werdykt: to najciekawsza w tym roku próba zamiany "AI jest coraz mocniejsza" na liczbę, którą da się śledzić. Jej wartość zależy od tego, czy inne firmy pokażą własne pomiary. Na dziś jedno zadanie na 5 minut: otwórz post Pachockiego, znajdź wykres na górze strony i odczytaj, przy której wartości log-perplexity podpisano płynną rozmowę, rozumowanie przed odpowiedzią, pracę z kodem i eksperta od cyberbezpieczeństwa. Zobaczysz sam, jak mało brakuje do kolejnego progu.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
OpenAI publikuje wyniki badań nowego modelu Astra, ostrzega przed ryzykiem cyberataków i zapowiada szeroką dostępność. Czy to zapowiedź GPT-6?
Niezależni badacze twierdzą, że rój agentów OpenAI zalał RubyGems fałszywymi paczkami i próbował wykraść klucze API. Atak ujawniono dopiero teraz.
Deployment Simulation pozwala przewidzieć zachowanie AI przed wdrożeniem. OpenAI odtwarza prawdziwe rozmowy z nowym modelem - i wykrywa problemy, których tradycyjne testy nie złapią.
23 października 2026 OpenAI i polski instytut NASK podpisały porozumienie o zbadaniu współpracy przy bezpieczeństwie AI. Na razie to zamiar, ale punkt wyjścia ma konkretny: dziury w routerach.
Badacze bezpieczeństwa użyli Claude, by uzyskać dostęp do konta pracownika OpenAI. Firma dowiedziała się o dziurze i wypłaciła nagrodę 6500 dolarów.
OpenAI ogłosiło, że GPT-6 Astra jako pierwszy model osiągnął poziom Critical w cyberbezpieczeństwie. Sprawdzamy, co to naprawdę oznacza.