
Bielik 11B v3.1 na szczycie krzywej Pareto w EuroEval
Przejdź do treści i przykładów

Polski model językowy Bielik AI 11B v3.1 znalazł się na szczycie krzywej Pareto w europejskim benchmarku EuroEval. To wynik z samego zestawienia. Twierdzenie, że żaden mniejszy model nie osiąga tam lepszych rezultatów, pochodzi od twórców Bielika. Sebastian Kondracki, jeden ze współtwórców, napisał na LinkedIn: „Żeby go wyprzedzić, trzeba sięgnąć po modele prawie trzykrotnie większe”.
Krzywa Pareto w tym zestawieniu to w uproszczeniu lista modeli, których nikt mniejszy nie pobił jakością. Bielik 11B stoi na jej szczycie. Żeby go przeskoczyć, trzeba zapłacić rozmiarem, czyli sprzętem. To trochę jak z samochodami: kombi mieści zakupy całej rodziny i nie potrzebujesz do tego ciężarówki, dopóki nie wieziesz palet.
Warto zauważyć, że ta miara nie odpowiada na pytanie, który model jest „najlepszy w ogóle”. Odpowiada na pytanie, ile jakości dostajesz za dany rozmiar. Duże modele komercyjne, takie jak GPT-5, Claude Opus 4.7 czy Gemini 3.1 Pro, grają w zupełnie innej kategorii wagowej i działają wyłącznie w chmurze dostawcy. Krzywa Pareto porządkuje natomiast wybór wśród modeli, które realnie da się uruchomić na własnym sprzęcie. Prawie trzykrotnie większy model od 11B to rząd wielkości około 30 mld parametrów, a taki rozmiar oznacza już zauważalnie wyższe wymagania pamięciowe.
EuroEval to benchmark skupiony na językach europejskich, a nie na samym angielskim. To istotna różnica, bo wiele popularnych testów powstało z myślą o angielszczyźnie, a wynik modelu w innym języku bywa od nich zupełnie odmienny. Ranking oparty na zadaniach w wielu językach europejskich lepiej pokazuje, jak model radzi sobie z gramatyką, odmianą i kontekstem kulturowym. Dla polskiego użytkownika, który pisze o fleksji, siedmiu przypadkach i urzędowych sformułowaniach, to bardziej użyteczny punkt odniesienia niż klasyczne, wysycone testy wiedzy ogólnej.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Praktyczna część jest ciekawsza niż miejsce w rankingu. Bielik 11B mieści się na jednej karcie GPU, więc możesz go uruchamiać lokalnie, na własnej infrastrukturze, bez przekazywania danych zewnętrznym dostawcom. Dla polskich firm, które boją się wklejać umowy czy dane klientów do cudzej chmury, to konkretny argument. Model jest udostępniany jako open-weight, więc możesz pobrać wagi i dostosować rozwiązanie do swoich zastosowań. Warunków licencji i sposobu pobrania szukaj w dokumentacji modelu u jego twórców, czyli Fundacji SpeakLeash i ACK Cyfronet AGH.
Kilka scenariuszy, w których uruchomienie modelu na własnym serwerze jest rozsądniejsze niż korzystanie z zewnętrznego czatu:
Przy takich zadaniach liczy się zwykle nie rekordowy wynik w teście, lecz przewidywalny koszt, kontrola nad danymi i dobra polszczyzna. Lokalny model daje te trzy rzeczy naraz, choć wymaga kogoś, kto go uruchomi i będzie utrzymywał.
Wersję 3.1 wytrenowano na 500 mld tokenów. Obsługuje 56 języków, w tym wszystkie języki urzędowe UE. Więcej o samej premierze znajdziesz w tekście o tym, jak Bielik 11B v3.1 łączy 56 języków i agentów.
Model potrafi korzystać z zewnętrznych narzędzi, generować odpowiedzi w określonym formacie i realizować wieloetapowe zadania wymagające planowania. W benchmarku τ²-bench, który sprawdza m.in. obsługę klienta i wykonywanie operacji w zewnętrznych systemach, wersja 3.1 uzyskała wyniki o 16-45 proc. lepsze niż poprzednia edycja. Jeśli ciekawi Cię, co to oznacza w firmie, zajrzyj do materiału o tym, dlaczego agenci AI potrzebują jednej bazy danych. Rynek agentów mówiących po polsku też się zagęszcza, o czym pisałem przy okazji inwestycji Wonderful w Polsce.
Umiejętność wywoływania narzędzi jest tu ważniejsza, niż mogłoby się wydawać. Model, który potrafi zwrócić odpowiedź w ustalonym formacie, można podpiąć do systemu zgłoszeń, kalendarza czy bazy klientów. Wtedy przestaje być tylko rozmówcą, a zaczyna wykonywać konkretne czynności, na przykład wyszukać zamówienie i przygotować odpowiedź dla klienta. Przy lokalnym wdrożeniu cały ten łańcuch może działać wewnątrz firmowej sieci.
Pozycja na krzywej Pareto to dobry sygnał, ale nie gwarancja, że model sprawdzi się w Twoim przypadku. Wynik pochodzi z konkretnego zestawu zadań, a Twoje dokumenty mogą wyglądać inaczej: mieć branżowy żargon, nietypowe formatowanie albo bardzo długie fragmenty. Najrozsądniej potraktować ranking jako powód, by model przetestować, a nie jako gotową decyzję zakupową. Kilkadziesiąt prawdziwych, zanonimizowanych przykładów z własnej pracy powie więcej niż jakakolwiek tabela.
Nie wiesz, czy lokalny model Ci się przyda? Sprawdzenie zajmuje kwadrans: spisz trzy rodzaje dokumentów w Twojej pracy, których nie chcesz wklejać do zewnętrznego czatu. Ta lista pokaże zadania, przy których model działający na własnym sprzęcie ma realny sens.
Na podstawie: ITwiz
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
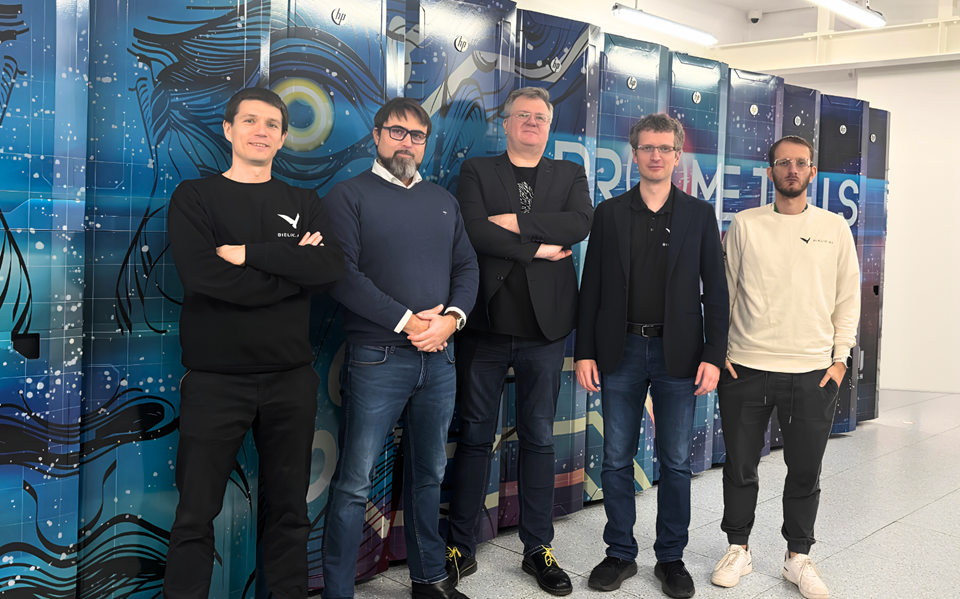
SpeakLeash i ACK Cyfronet AGH pokazały Bielika 11B v3.1: 56 języków zamiast 32, lepsze zadania wieloetapowe i nowa rodzina Bielik-One, która zamiast pisać, ocenia.
Alibaba wypuściła Qwen3.8-Omni-Flash - model, który jednym ruchem przetwarza tekst, obraz, audio i wideo, z kontekstem 1 mln tokenów i niższą ceną API.
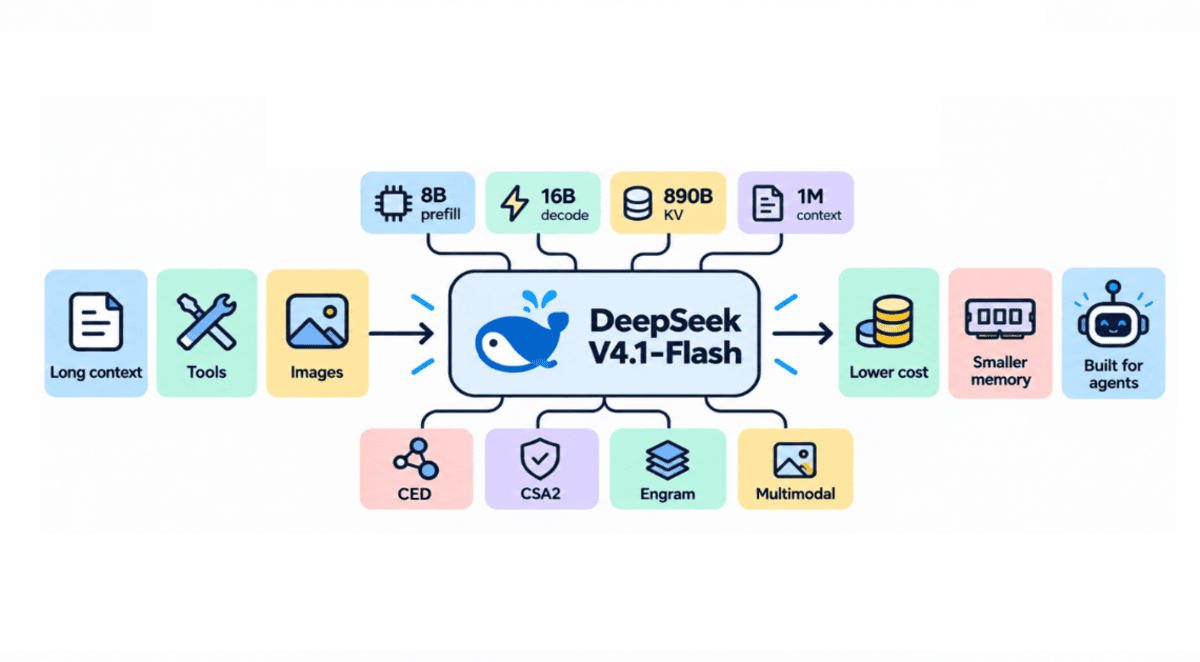
DeepSeek pokazuje, że przyszłość agentów AI nie leży w większych modelach, tylko w tańszej pamięci i szybszym przetwarzaniu długiego kontekstu.

Połowa Fortune 500 korzysta z Hugging Face. CEO Clem Delangue widzi wyraźny trend: firmy najpierw testują zamknięte API, potem przechodzą na open source. Dlaczego?
Poznaj krok po kroku, jak powstaje tokenizator AI - od normalizacji tekstu, przez WordPiece, BPE i Unigram, aż po gotowy model do treningu.
Falcon, Mistral, Claude, Llama - dziesiątki modeli AI, setki wariantów. Który wybrać do swojego projektu? Praktyczny przewodnik po kolekcji dużych modeli językowych.