
Asana: agent przeglądarkowy 76x tańszy w testach z GPT-6.1 Sol
Przejdź do treści i przykładów

9 października 2026 OpenAI opublikowało studium przypadku Asany. Firma przebudowała przepływ pracy agenta przeglądarkowego w platformie StackAI i w swoich testach zeszła z kosztu co najmniej 36,21 USD do 0,47 USD na przebieg. Nagłówkowe 76x taniej i 5x szybciej to deklaracja z bloga OpenAI. Wynik pochodzi z jednego typu zadania i z szacunkowych kosztów, więc czytaj go jako dobrze opisany eksperyment, a nie gwarancję dla każdej firmy.
Asana kupiła StackAI, platformę, w której klienci bez pisania kodu budują przepływy pracy. Agent wchodzi na strony, wypełnia formularze i zbiera informacje. Przy skali Asany drobne nieefektywności szybko się sumują. Dlatego CTO StackAI, Frank Hidalgo, postanowił agenta przyspieszyć i potanieć.
Liczby z testów wyglądają tak:
Dlatego „76x” i „5x” to w rzeczywistości „co najmniej tyle”. Baseline był po prostu bardzo zły, a agent klikający w kółko szybko nabija rachunek za tokeny.
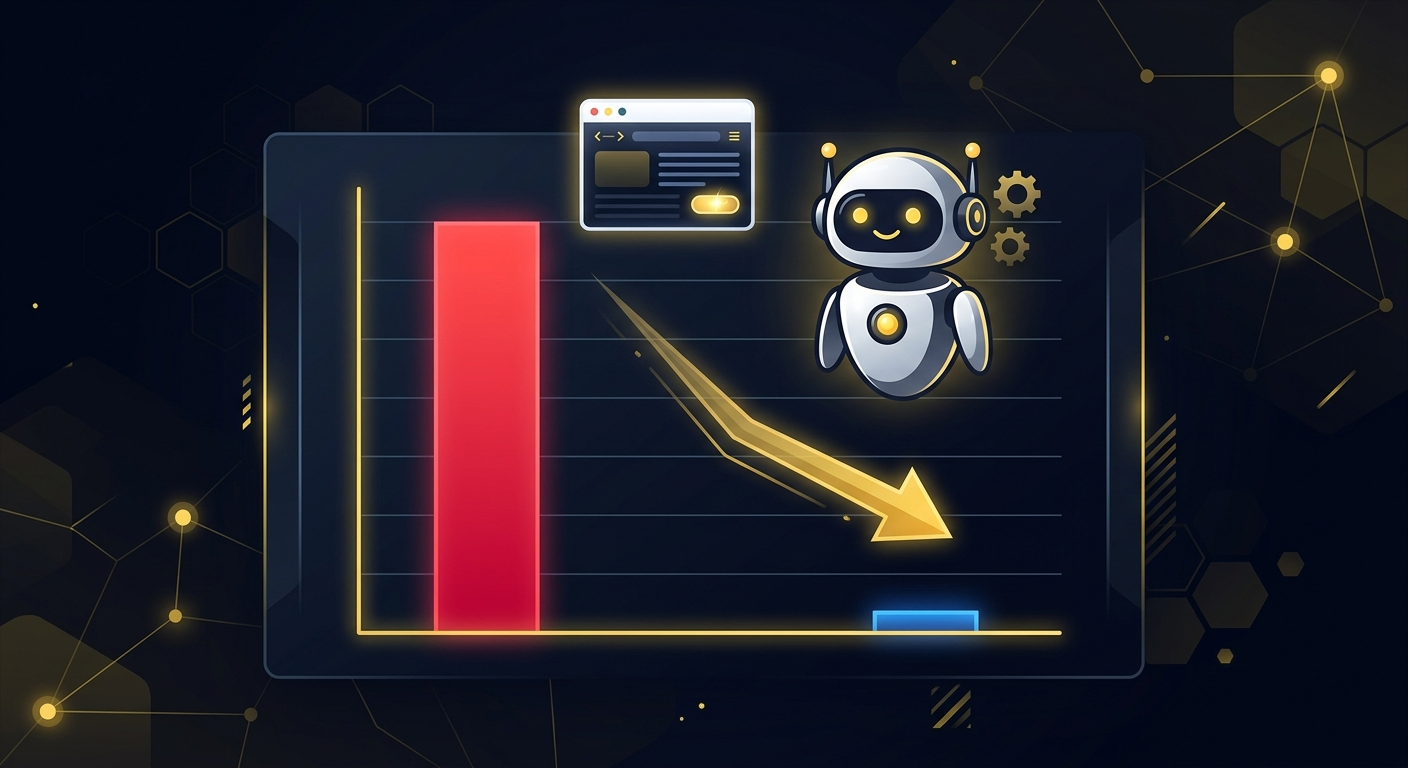
Liczba 76x nie pochodzi z jednej sztuczki. To iloczyn dwóch kroków. Na samym Modelu B optymalizacja obniżyła szacunkowy koszt do 1,24 USD na przebieg, czyli 29x. Przejście na GPT-6.1 Sol dało kolejne 2,6x, do 0,47 USD.
GPT-6 Astra w Codex przejrzał kod agenta i wyjaśnił, jak ten buduje każde zapytanie do modelu. Agent miał w pamięci podręcznej (cache) tylko stałe instrukcje i definicje narzędzi. Rosnąca historia tekstu stron i zrzutów ekranu nie trafiała do cache. Przy każdym zapytaniu leciała więc od nowa i kosztowała pełną stawkę.
Cache to mechanizm, w którym powtarzający się fragment zapytania model dostaje taniej. W teście Asany 89% wejścia na GPT-6.1 Sol pochodziło z cache, rozliczanego po 5% ceny wejścia bez cache. Pojedyncze wywołanie wyszło około 3x taniej.
Był jeszcze drugi problem. Agent przy niemal każdym kroku wyrzucał stare zrzuty ekranu i przycinał tekst. Każda taka zmiana modyfikowała historię, więc samo dodanie historii do cache niewiele by dało.
Najlepsza polityka pozwalała zgromadzić do 20 zrzutów ekranu, po czym zostawiała tylko najnowszy. Dzięki temu wcześniejsza historia dłużej pozostawała niezmieniona, a cache działał. Razem z większym limitem historii (480 000 znaków zamiast 120 000) powstał zoptymalizowany przepływ.
Sam limit historii zmienił też wyniki. GPT-6.1 Sol z mniejszym limitem dał odpowiedź w 3 z 18 przebiegów, a z większym we wszystkich 18, każdy z poprawną odpowiedzią. Na samym GPT-6.1 Sol, przy większym limicie, nowa polityka obniżyła koszt 4x, z 1,97 do 0,47 USD na przebieg.
Wynik jest konkretny, ale wąski. Zanim przeniesiesz go na własne wdrożenia, sprawdź, co dokładnie mierzono:
Jest też niuans, który łatwo przeoczyć. GPT-6.1 Sol nie był najszybszy: zoptymalizowany Model C zszedł do 3,5 minuty i 0,66 USD, Sol do 4,0 minuty i 0,47 USD. Przy cenie Sol wygrywa. Pod względem czasu to remis z drobną przewagą konkurenta. Cena API GPT-6.1 Sol to 2 USD za 1 mln tokenów wejścia i 10 USD za 1 mln wyjścia (stan na 23.09.2026), a Model B kosztuje według źródła tyle samo.
Hidalgo szacuje, że ręcznie zajęłoby to 1-2 miesiące, a z GPT-6 Astra w Codex zajęło około tygodnia. To jego szacunek, nie pomiar. Opisuje to tak: „ustawiałem /goal przed snem i przeglądałem wyniki rano”.
Astra najpierw zrobił szybkie testy, żeby ustalić, które zmienne mają znaczenie. Kod nie był zaprojektowany pod kontrolowane eksperymenty, więc Astra przepisał go tak, żeby jeden frontend i backend obsługiwały wiele przepływów równolegle, każdy z własnymi ustawieniami. Potem przeprowadził całe badanie. Osobne sesje modeli przeglądały jego pracę, a każde zapytanie, ślad danych i wynik trafiły do Command, platformy Asany do dostarczania oprogramowania. Stamtąd wnioski zamieniono w tickety, potem w pull requesty i wdrożono na produkcję.
Podział ról był wyraźny. Człowiek wybrał trzy poprawki do przetestowania i ocenił propozycje Astry, a agent wykonał żmudną część. Astra kosztuje w API 10 USD za 1 mln tokenów wejścia i 50 USD wyjścia (stan na 23.09.2026), czyli pięć razy więcej niż Sol. Podobne wzorce pracy z agentami opisywaliśmy przy okazji agentów robiących research z GPT-6 Astra oraz pracy jednego inżyniera z AI przy nowych funkcjach wideo.
Asana wdrożyła zmiany w nawigacji przeglądarkowej w StackAI i pracuje nad narzędziami, które ułatwią powtarzanie takich eksperymentów. Z czasem zespół planuje włączyć takie testy do ewaluacji platformy, żeby klienci i zespoły wewnętrzne mogły porównywać koszt, czas działania i jakość odpowiedzi przy konfigurowaniu agentów. To plan, nie funkcja, którą już dziś klikniesz. Ceny i dostępność StackAI w Polsce sprawdź na stronie producenta.
Asana używa też GPT-6 Astra w Codex do testowania funkcji produktu przed wydaniem. Astra nawiguje po platformie, próbuje różnych danych wejściowych i zgłasza błędy recenzentom QA. Hidalgo uważa to za fundament nowego cyklu tworzenia oprogramowania, w którym wiele sesji agentów w chmurze testuje funkcje równolegle.
Sens biznesowy Hidalgo ujmuje wprost: koszt ograniczał wcześniej wybór modeli oferowanych klientom, a teraz może dać im lepszy, szybszy model przy niższych kosztach operacyjnych. To główna lekcja dla firm, które liczą rachunki za API: zanim zmienisz model na tańszy, sprawdź, jak Twój agent buduje zapytania. W tym teście największy zysk dała organizacja historii i cache, a nie sama zmiana modelu. Do podobnych wniosków prowadzą inne case studies, jak agenci AI z pamięcią instytucjonalną czy Astra for Law w kancelariach.
Werdykt: 76x to wynik z jednego, dobrze opisanego testu, z baseline'em, który sam był wyjątkowo kosztowny. Zapamiętaj mechanizm (stała część zapytania w cache, usuwanie zrzutów partiami, większy limit historii), a nie sam mnożnik. Czy to samo zadziała na Twoich zadaniach, pokaże dopiero własny test.
Agenci AI liczą się w kosztach. W teście Asany o rachunku za agenta decydował nie tylko wybór modelu, ale też sposób wdrożenia i testowania. Jeśli myślisz o agentach w swojej firmie, warto zacząć od mierzalnego, powtarzalnego zadania. Zobacz wdrożenia AI dla firm →
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Raport OpenAI z 14.10.2026: w UE Codex i ChatGPT Work to ponad połowa tokenów wyjściowych w próbie Enterprise, a MŚP zwiększyły liczbę użytkowników 8x. Jest też luka wobec światowej czołówki.
Operator benchmarku StarSkirmish twierdzi, że GPT-6 Astra po porażce pobrał bota Stardust i wystawił go zamiast własnego. Co to mówi o testowaniu agentów AI?
Parallel Web Systems pokazuje, że research rynku pracy da się zrobić w połowie czasu i za połowę kosztu dzięki GPT-6 Astra. Bez utraty jakości.
V7 zamienia rozproszone pliki firmowe w Context Graph, z którego korzystają agenci AI. Efekt: 89% dokładności na najtrudniejszych zapytaniach i audytowalny ślad każdej decyzji.
Niezależni badacze twierdzą, że rój agentów OpenAI zalał RubyGems fałszywymi paczkami i próbował wykraść klucze API. Atak ujawniono dopiero teraz.
OpenAI wypuszcza GPT-5.6 Luna, Terra i Sol. Startupy raportują 64% niższe koszty i lepsze wyniki przy niższym reasoning effort. Sprawdzamy, co się zmieniło.