Narzedzia AI
·
6 min czytania
·
14 września 2026
DeepSeek-V4.1-Flash: architektura ważniejsza niż wyniki testów
Przejdź do treści i przykładów

Źródło: Link
Źródło: Link
Firmy od miesięcy powtarzają jedno zdanie: "nasz model ma więcej parametrów niż konkurencja". DeepSeek-V4.1-Flash idzie w drugą stronę i pyta o coś bardziej przyziemnego - ile kosztuje utrzymanie agenta AI, który pamięta kontekst przez godziny, a nie sekundy. Odpowiedź, jaką proponuje DeepSeek, jest bardziej interesująca niż same liczby w benchmarkach.
Model ma 552 miliardy parametrów, ale to tylko punkt wyjścia do zrozumienia, o co tu chodzi. Dzięki architekturze Mixture-of-Experts (MoE) w praktyce aktywnych jest zaledwie 8 miliardów parametrów podczas przetwarzania wstępnego (prefill) i 16 miliardów podczas generowania odpowiedzi (decode). To jest sedno sprawy: masz do dyspozycji ogromny, wielowarstwowy model, ale płacisz obliczeniowo tylko za ułamek jego całości przy każdym tokenie.
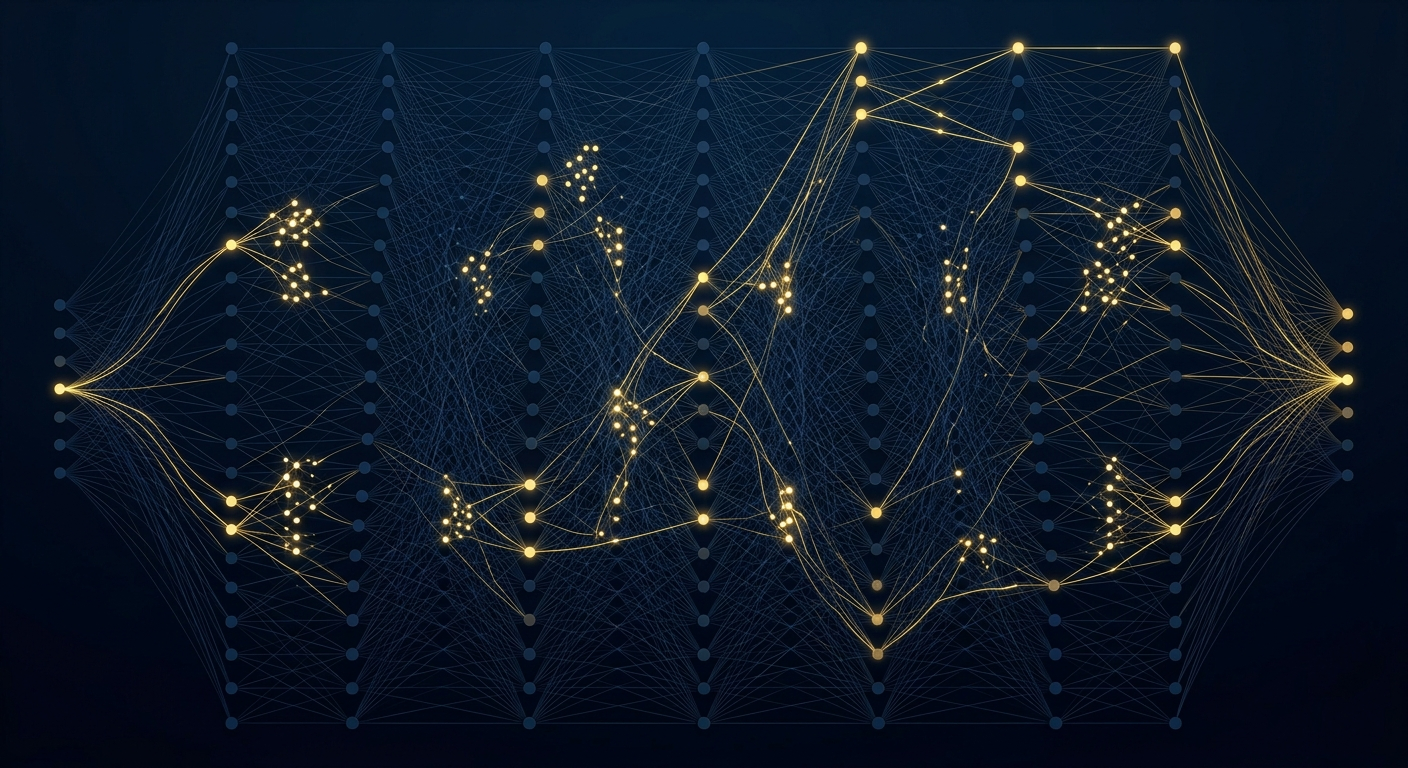
DeepSeek-V4.1-Flash obsługuje okno kontekstu 1 miliona tokenów i przyjmuje zarówno tekst, jak i obrazy. Model trenowano od podstaw na 45 bilionach tokenów multimodalnych - to dane wystarczające, by pokryć szeroki zakres zadań, od kodu po analizę dokumentów.
Najważniejsza liczba w całym zestawieniu to jednak 890 bajtów na token - tyle wynosi globalny rozmiar pamięci KV cache. Dla kogoś, kto nie zajmuje się infrastrukturą AI na co dzień, wygląda to na drobny techniczny detal. W rzeczywistości nim nie jest. KV cache to pamięć, w której model trzyma "na bieżąco" wszystko, co już przeczytał w danej rozmowie. Im dłuższy kontekst, tym więcej tej pamięci trzeba utrzymywać, a to bezpośrednio przekłada się na koszt serwerów. Model z drastycznie mniejszym KV cache może obsłużyć dłuższe rozmowy i więcej użytkowników jednocześnie, bez dokładania kolejnych kart graficznych.
Do tego dochodzi osobny komponent nazwany Engram - warstwa pamięci warunkowej licząca 196 miliardów parametrów, która jest odpytywana rzadko (selektywnie), a nie uruchamiana przy każdym tokenie jak reszta modelu. W praktyce działa jak dodatkowa baza wiedzy, po którą model sięga tylko wtedy, gdy faktycznie jej potrzebuje.
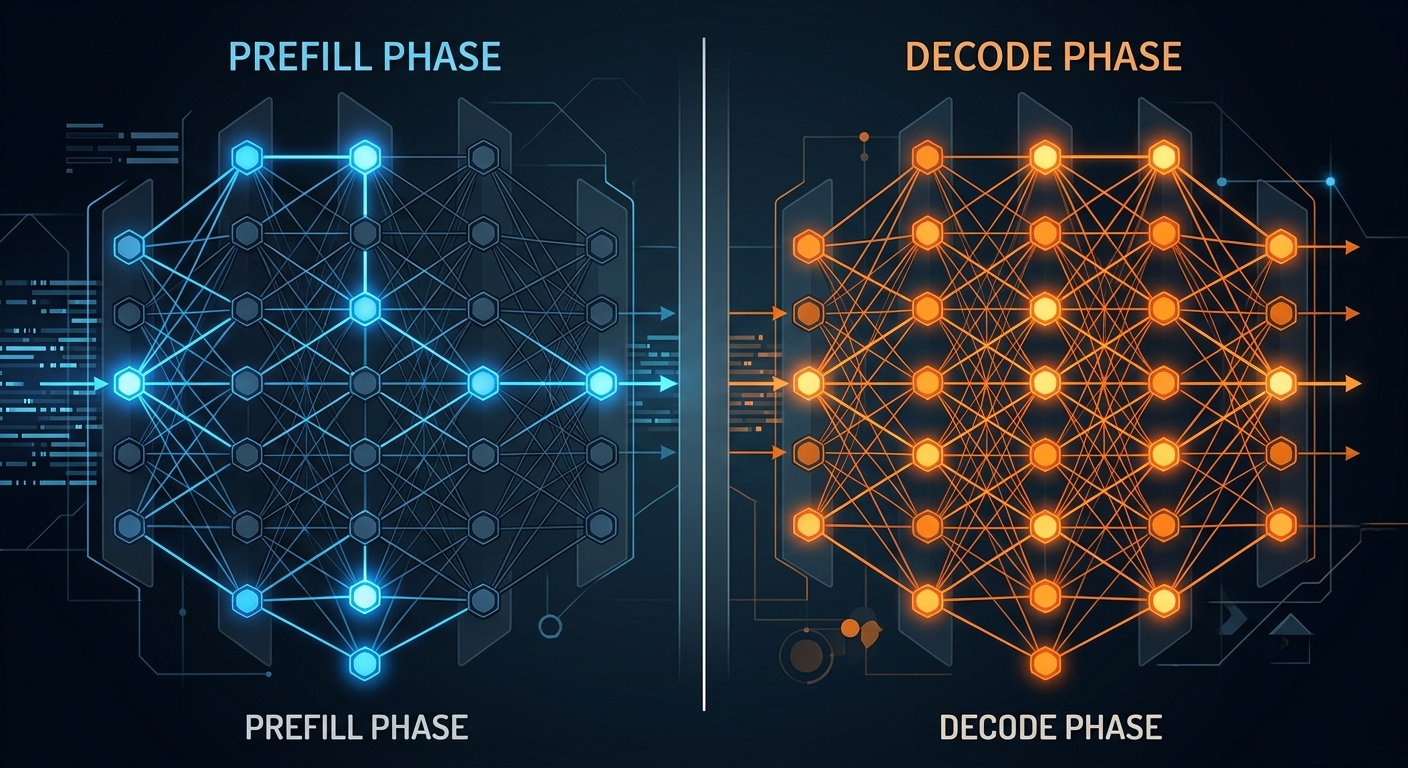
DeepSeek opisuje architekturę modelu jako Causal Encoder-Decoder połączoną z MoE. W praktyce chodzi o rozdzielenie dwóch etapów pracy modelu: czytania (prefill) i pisania odpowiedzi (decode). Te dwa etapy mają zupełnie inną charakterystykę kosztową - przetwarzanie długiego wejścia (np. całego dokumentu wklejonego do agenta) potrafi być drogie samo w sobie, jeszcze zanim model wygeneruje choć jedno słowo odpowiedzi.
Właśnie dlatego liczby 8B (prefill) i 16B (decode) są tak wymowne. Model świadomie różnicuje, ile mocy obliczeniowej angażuje na każdym etapie - mniej przy czytaniu, więcej przy generowaniu. To podejście wpisuje się w szerszy trend, o którym pisaliśmy już przy okazji testów innych dużych modeli dla developerów - liczy się nie tylko "co model potrafi", ale ile kosztuje utrzymanie go w długiej, wielogodzinnej sesji.
Dla zwykłego czatu różnica między 890 bajtami a znacznie większym KV cache jest niezauważalna. Problem pojawia się dopiero, gdy agent AI ma pracować godzinami - przeglądać dokumenty, wracać do wcześniejszych ustaleń, utrzymywać stan rozmowy przez cały dzień. Pisaliśmy już o tym, jak internet zaczyna być projektowany pod agentów, a nie pod ludzi - to dokładnie ten scenariusz. Im dłużej agent "pamięta", tym więcej pamięci serwerowej to kosztuje, a architektura DeepSeek-V4.1-Flash wprost atakuje ten koszt.
Do tego dochodzi kompresja KV cache i mechanizm nazwany CSA2 - oba elementy służą temu samemu celowi, czyli zmniejszeniu ilości pamięci potrzebnej do obsługi długiego kontekstu bez utraty jakości odpowiedzi. Połączenie tych technik z rzadko aktywowanym Engramem tworzy model, który teoretycznie powinien być tańszy w utrzymaniu niż jego surowa liczba parametrów sugeruje.
DeepSeek-V4.1-Flash trafia na rynek na licencji MIT, czyli jednej z najbardziej otwartych licencji open source dostępnych dla modeli AI. Oznacza to, że firmy mogą pobrać wagi modelu, uruchomić go na własnej infrastrukturze i modyfikować pod swoje potrzeby, bez płacenia licencji za każde zapytanie. To ten sam kierunek, który widzieliśmy już przy innych otwartych modelach tych przy okazji integracji DeepSeek z innymi otwartymi modelami w jednym interfejsie - konkurencja w segmencie open source robi się coraz ostrzejsza, a to dobra wiadomość dla każdego, kto nie chce być uzależniony od jednego dostawcy API.
Dla firm rozważających budowę własnych agentów AI (np. do obsługi klienta czy analizy dokumentów) architektura tego typu ma konkretne znaczenie - niższy koszt pamięci per token przekłada się bezpośrednio na rachunek za infrastrukturę, szczególnie gdy mowa o setkach tysięcy zapytań dziennie. Jeśli porównujesz narzędzia do pracy z kodem czy dokumentami, warto zerknąć też na zestawienie asystentów do kodu - tam koszt utrzymania długiego kontekstu też odgrywa coraz większą rolę.
Agenci AI tańsi w utrzymaniu? Modele takie jak DeepSeek-V4.1-Flash pokazują, że wdrożenie własnego agenta AI w firmie nie musi oznaczać astronomicznych kosztów infrastruktury. Zobacz wdrożenia AI dla firm →
Ostatecznie ta premiera niesie jedną konkretną lekcję: liczba parametrów przestaje być jedynym wskaźnikiem wartym śledzenia. Dużo bardziej liczy się to, ile z tych parametrów faktycznie pracuje przy każdym tokenie i ile pamięci trzeba utrzymywać, żeby model nie "zapomniał", o czym rozmawialiście dwie godziny wcześniej.
Kluczowa różnica leży w architekturze Mixture-of-Experts - mimo że model ma 552 miliardy parametrów, przy każdym tokenie aktywnych jest tylko 8-16 miliardów. Dzięki temu model jest tańszy w uruchomieniu niż jego surowa wielkość sugeruje.
Model jest udostępniony na licencji MIT, co oznacza, że można pobrać jego wagi i uruchomić na własnej infrastrukturze bez opłat licencyjnych. To jedna z najbardziej otwartych licencji stosowanych obecnie dla dużych modeli AI.
KV cache to pamięć operacyjna modelu podczas rozmowy - im dłuższy kontekst i im dłużej agent działa, tym więcej tej pamięci potrzeba. Wartość 890 bajtów na token pozwala obsłużyć dłuższe sesje i więcej użytkowników bez proporcjonalnego wzrostu kosztów serwerów.
Engram to osobny, 196-miliardowy komponent pamięci warunkowej, który model odpytuje selektywnie, a nie przy każdym tokenie. Działa jak dodatkowa baza wiedzy uruchamiana tylko wtedy, gdy jest faktycznie potrzebna, co dodatkowo obniża koszt obliczeniowy.
Na podstawie: KDnuggets
10 gotowych promptów do codziennej pracy + 5 narzędzi + plan na pierwszy tydzień. PDF, 4 strony konkretu.

DeepSeek V4 Flash zużył 8 bilionów tokenów w ciągu doby na jednym narzędziu. To więcej niż cały OpenRouter dziennie. Ekonomia agentów AI właśnie zmieniła zasady gry.

DeepSeek formalnie wypuścił V4.1 Flash i od 14 września przekierowuje żądania do V4 Pro na nowy model z niższymi stawkami.
Alibaba wypuściła Qwen3.8-Omni-Flash - model, który jednym ruchem przetwarza tekst, obraz, audio i wideo, z kontekstem 1 mln tokenów i niższą ceną API.
Tencent open-sources'uje WeKnora, platformę RAG-to-agent z ponad 25 tys. gwiazdek na GitHubie, wraz z oficjalną wtyczką do DeepSeek Harness dla firmowych baz wiedzy.
DeepSeek zaktualizował Harness do wersji 0.1.5 - obsługa V4.1 Flash, wgrywanie plików, podgląd w panelu bocznym i eksperymentalne zespoły agentów.

Tencent otworzył swojego systemowego asystenta Marvis na modele trzecie - Kimi, Zhipu GLM, DeepSeek, MiniMax - i na lokalne modele open source, synchronizowane między urządzeniami.