
Bielik 11B v3.1: 56 języków, agenci i modele, które decydują
Przejdź do treści i przykładów

Fundacja SpeakLeash i ACK Cyfronet AGH zaprezentowały Bielika 11B v3.1. Według twórców model obsługuje już 56 języków (wersja 3.0 miała ich 32) i lepiej radzi sobie z zadaniami wieloetapowymi. Razem z nim zadebiutowały Bielik-One, czyli rodzina czterech modeli decyzyjnych, oraz Bielik DFlash, który ma przyspieszać generowanie odpowiedzi. Premierę opisał 10 listopada 2026 portal ITwiz.
W nagłówkach króluje liczba 56. Najbardziej praktyczna jest jednak rzecz, która ledwo się w nich mieściła: model, który nie pisze, tylko ocenia.
Bielika 11B v3.1 wytrenowano na 500 mld tokenów (tokeny to kawałki tekstu, z których model się uczy). Dzięki temu ogarnia wszystkie języki urzędowe Unii Europejskiej, a także m.in. arabski, chiński, japoński, koreański, ormiański, azerski i gruziński. Twórcy zapewniają, że to rozszerzenie nie odbyło się kosztem jakości pracy z polskim i lokalnym kontekstem. To deklaracja twórców, nie wynik niezależnego testu.
Konkretne liczby dotyczą porównania z wersją 3.0, a nie z modelami konkurencji:
Wersja 3.1 łączy trzy umiejętności. Function calling to wywoływanie zewnętrznych funkcji i narzędzi. Structured output to odpowiedź w ustalonym formacie, który może odczytać inny system. Reasoning to jawne rozumowanie. Razem pozwalają zrealizować zadanie wymagające kilku kolejnych działań, zamiast poprzestać na odpowiedzi na pytanie. Krzysztof Ociepa z SpeakLeash podkreśla, że Bielik 3.1 korzysta z trybu rozumowania także w trakcie wywoływania narzędzi. To ma znaczenie, gdy model musi zaplanować sekwencję działań i po drodze dobrać właściwe narzędzia.
Test τ²-bench symuluje obsługę klienta w lotnictwie, handlu i telekomunikacji. Model musi zrozumieć problem, wybrać narzędzia, wykonać operacje (na przykład sprawdzić rezerwację albo zmienić usługę) i doprowadzić sprawę do końca zgodnie z regułami. Tu właśnie padły wyniki lepsze o 16-45% niż w wersji 3.0.
Agenci AI po polsku to temat, który rozkręca się też po stronie biznesu, o czym pisałem przy okazji planów Wonderful na agentów AI po polsku. Wynik agenta zależy zresztą nie tylko od samego modelu, co pokazuje tekst o tym, jak poprawić agenta bez zmiany modelu.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
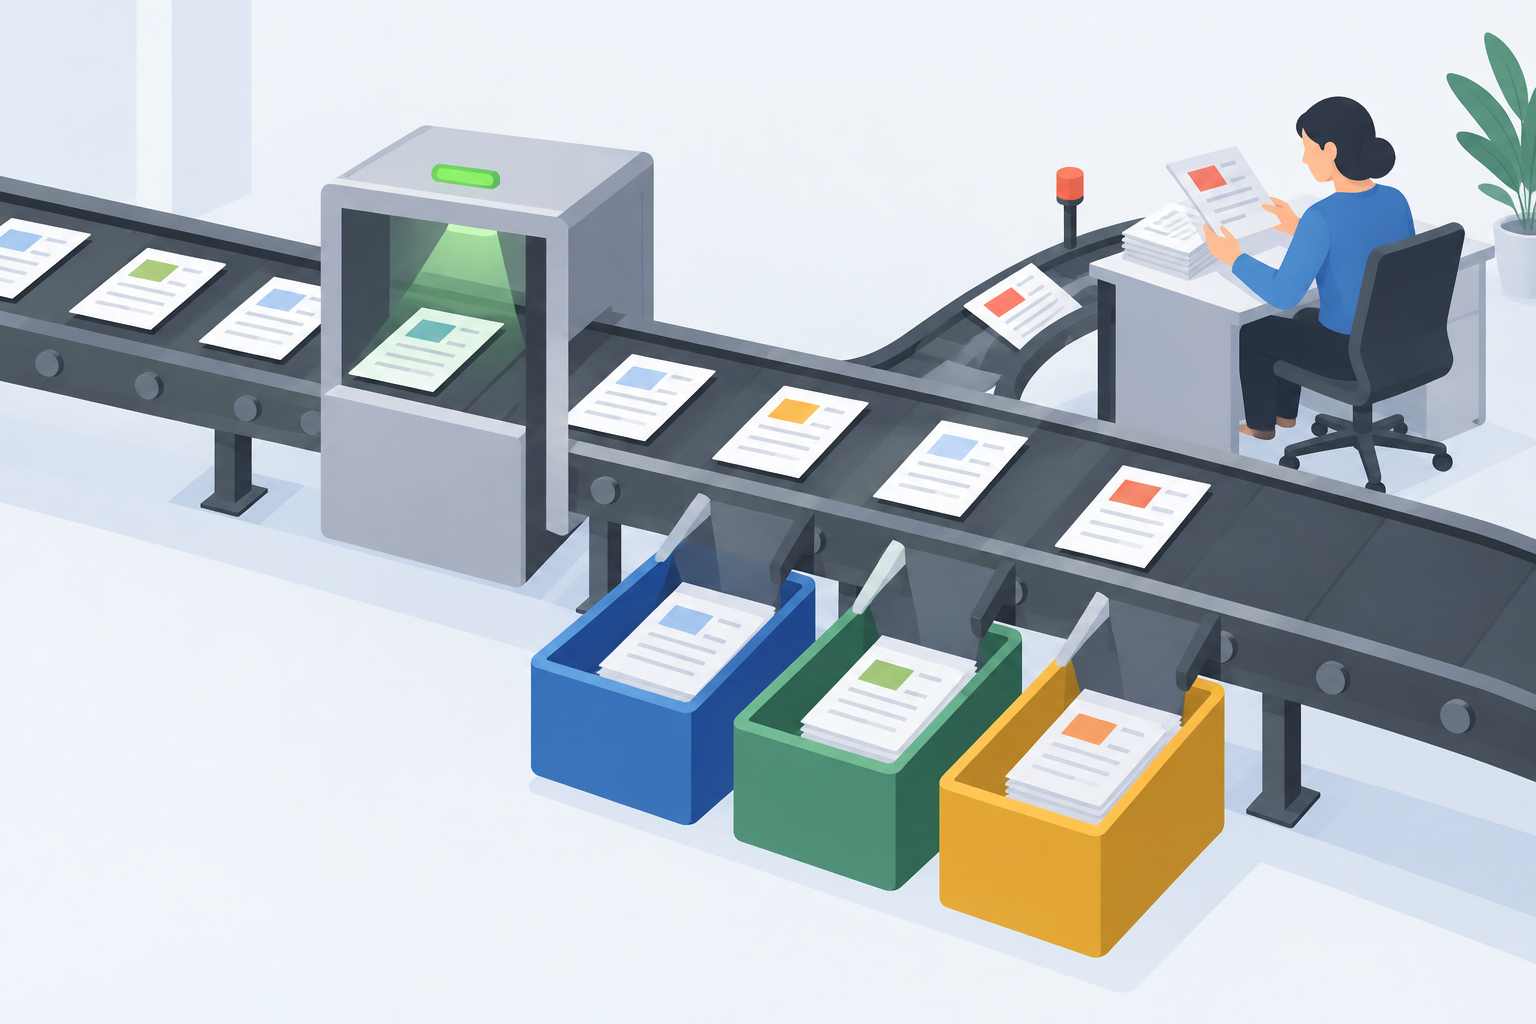
W wielu firmowych procesach nikt nie potrzebuje eseju, tylko odpowiedzi: ta kategoria, ta ocena, zgodne albo niezgodne. Rodzina Bielik-One powstała właśnie do takich zadań. Cztery modele analizują informacje i oceniają je według ustalonych kryteriów. Twórcy podają przykłady:
Przypisywanie zgłoszeń do kategorii przez model, który za każdym razem pisze trzy akapity uzasadnienia, to zatrudnianie felietonisty do przybijania pieczątek. Bielik-One zwraca rozkład prawdopodobieństwa dla poszczególnych odpowiedzi. Dzięki temu można ustalić progi automatyzacji: sprawy spełniające warunki obsługuje system bez człowieka, a budzące wątpliwości trafiają do weryfikacji. Cztery modele różnią się wielkością, więc dobierasz je do zadania i dostępnej mocy obliczeniowej. Krzysztof Wróbel z SpeakLeash opisuje to jako rozwiązanie dla miejsc, gdzie część decyzji chcemy zautomatyzować, ale z możliwością przekazania wybranych przypadków człowiekowi.
Te progi mają sens tylko wtedy, gdy ktoś liczy, co automatyzacja daje (a zwrot z AI mierzy co dziewiąta firma) i gdy ktoś umie sprawdzać pracę maszyny, o czym jest tekst o sprawdzaniu tego, co oddaje agent AI.
Bielik 11B v3.1 DFlash to model draftowy oparty na technice speculative decoding. Lżejszy model pomocniczy proponuje kolejne fragmenty odpowiedzi, a model główny je weryfikuje. Główny nie musi więc sam generować każdego elementu, co według twórców przyspiesza proces bez utraty jakości odpowiedzi.
Modele i ich wagi mają być dostępne na zasadach open science w ramach projektu SpeakLeash. Fundacja SpeakLeash nie podała terminu, od kiedy będzie można je pobrać.
Kolejne informacje padną 26 listopada podczas Bielik Summit 2026. Główna zapowiedź to model multimodalny z ponad 100 mld parametrów, budowany od podstaw na autorskiej architekturze, przy wsparciu krajowych firm i instytucji. Prace trwają od sześciu miesięcy. Według Sebastiana Kondrackiego, prezesa SpeakLeash, otwarte modele tej skali ze zdolnościami agentowymi buduje dziś w Europie właściwie jedna firma, francuski Mistral, a żaden projekt open science nie przekroczył jeszcze tej granicy. To na razie zapowiedź, więc oceń ją dopiero po Summit.
Co z tego wynika? Liczba języków robi wrażenie na slajdzie, ale w codziennej pracy częściej przyda Ci się ocena zamiast elaboratu. Weź dziś jeden proces z własnej pracy, który sprowadza się do sortowania (zgłoszenia, maile, dokumenty do sprawdzenia). Wypisz na kartce trzy kategorie i zdecyduj, które sprawy mogłyby iść bez Ciebie, a które musiałbyś zobaczyć osobiście. To 10 minut, a dostaniesz gotowy szkic progów, o których mówi Bielik-One.
Na podstawie: ITwiz
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
<p>Polski model językowy <strong>Bielik AI 11B v3.1</strong> znalazł się na szczycie krzywej Pareto w europejskim benchmarku EuroEval. To wynik z samego zestawienia. Twierdzenie, że żaden mniejszy model nie osiąga tam lepszych rezultatów, pochodzi od twórców Bielika. Sebastian Kondracki, jeden ze...

Połowa Fortune 500 korzysta z Hugging Face. CEO Clem Delangue widzi wyraźny trend: firmy najpierw testują zamknięte API, potem przechodzą na open source. Dlaczego?
Alibaba wypuściła Qwen3.8-Omni-Flash - model, który jednym ruchem przetwarza tekst, obraz, audio i wideo, z kontekstem 1 mln tokenów i niższą ceną API.
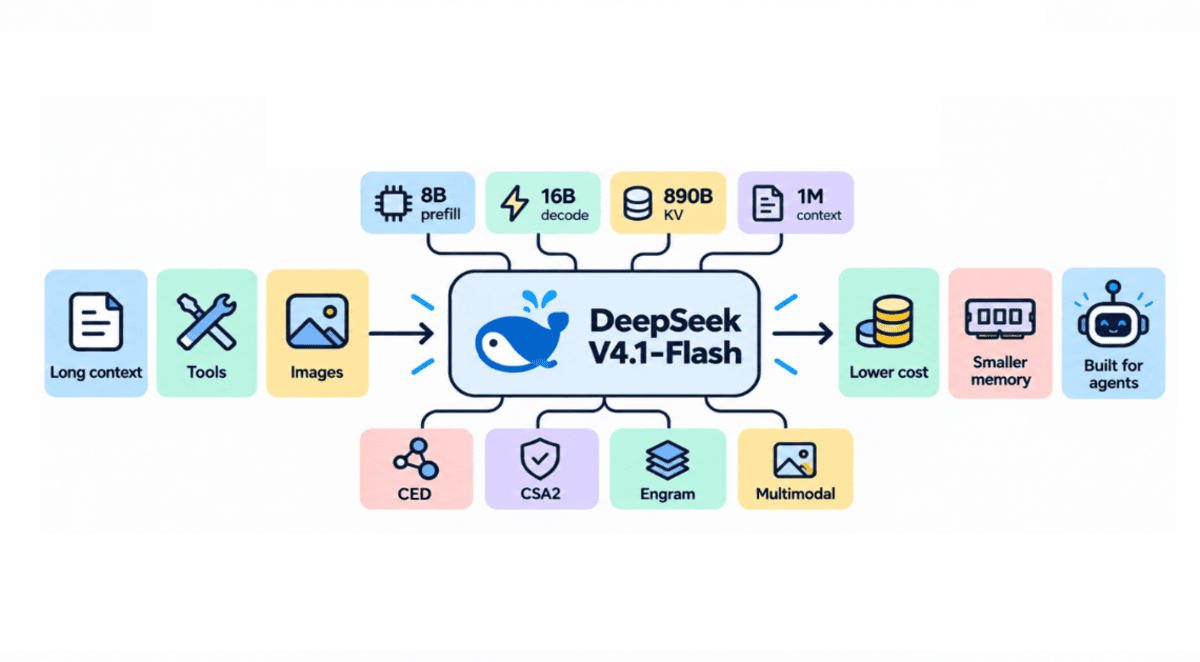
DeepSeek pokazuje, że przyszłość agentów AI nie leży w większych modelach, tylko w tańszej pamięci i szybszym przetwarzaniu długiego kontekstu.
TechCrunch zebrał ponad 20 agentów AI, do których piszesz jak do znajomego. Ceny, status bety i jedno pytanie, które zadaj, zanim oddasz im dostęp do poczty.
Computerworld.pl: firmy w Polsce kupują aplikacje AI, a zaniedbują infrastrukturę danych. Skąd się biorą kopie i potoki oraz co proponuje autor? To opinia i prognoza, nie test.