
Co to jest parametr w AI? Wyjaśniamy bez żargonu
Przejdź do treści i przykładów

Grafika: technologyreview.com
Grafika: technologyreview.com
Parametr w AI to liczba zapisana wewnątrz modelu, której wartość ustala algorytm treningu, a nie człowiek. Takich liczb są miliardy - to głównie tzw. wagi, czyli siła połączeń między elementami sieci neuronowej - i to one decydują, jak model przetwarza tekst i jaką odpowiedź poda. Gdy czytasz, że model ma „70B parametrów”, chodzi o 70 miliardów takich liczb. Parametrów modelu nie ustawiasz Ty: po treningu zostają zamrożone. Czym innym są parametry zapytania, np. temperatura (temperature), które można ustawić w zapytaniu do modelu, jeśli dany model na to pozwala - o nich niżej.
Aktualizacja 13.10.2026: dopisaliśmy definicję na początku tekstu i sekcję o parametrach zapytania (temperatura). Poprawiliśmy błędne liczby: 405 mld parametrów ma Llama 3.1, a nie Llama 4, a 175 mld - GPT-3, a nie GPT-5. Usunęliśmy szacunki, których producenci nie potwierdzili (liczba parametrów GPT-5, koszt jego treningu, „95% możliwości” po optymalizacji).
Najprostsza analogia pochodzi z matematyki. W równaniu y = ax + b litery a i b to parametry: od ich wartości zależy wynik. Model językowy to taka funkcja, tylko z miliardami „a” i „b”.
Redaktor MIT Technology Review obudził się w nocy i zapisał w notesie przy łóżku: „Co to w ogóle jest parametr?”
I właśnie od tego pytania zaczyna się tekst, na którym opiera się ten artykuł.
Bo wszyscy mówimy o modelach AI z miliardami parametrów. GPT-3 z 2020 roku miał ich 175 miliardów. Llama 3.1 od Meta w największej wersji - 405 miliardów. Brzmi imponująco. Ale co to właściwie znaczy?
Wyobraź sobie stary radioodbiornik. Ma pokrętła do głośności, tonów wysokich, niskich. Każde można ustawić w konkretnej pozycji.
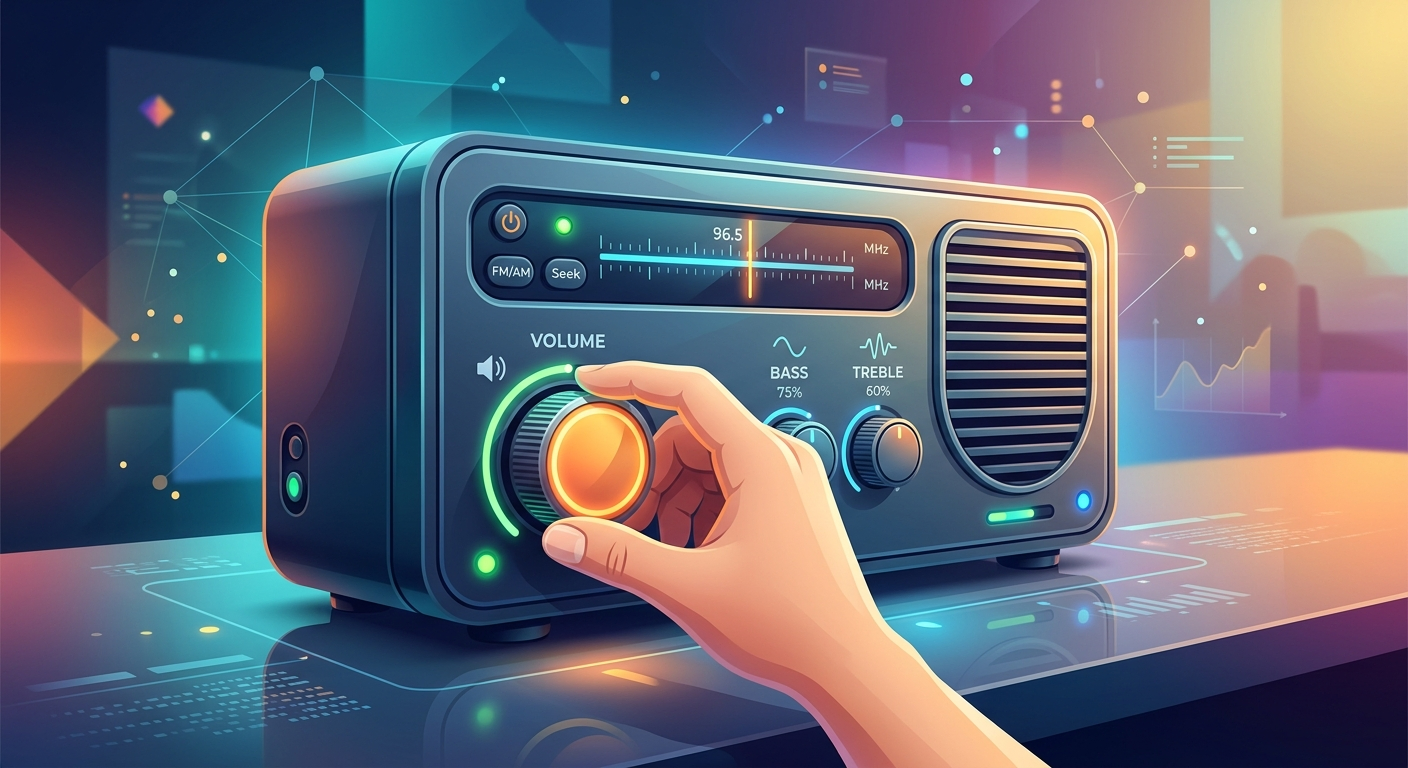
Parametr w modelu AI działa podobnie.
To liczba, którą można dostroić. Wartość, którą model "nauczył się" podczas treningu. Każdy parametr wpływa na to, jak AI reaguje na dane wejściowe - dokładnie jak pokrętło basu zmienia brzmienie muzyki.
Konkretniej: parametry to liczby przechowywane w warstwach sieci neuronowej. Kiedy wpisujesz pytanie do modelu, tekst zamienia się na liczby, przepływa przez kolejne warstwy - i na każdym etapie jest mnożony, dodawany i przekształcany właśnie przez te parametry. Wynik na końcu to odpowiedź, którą czytasz. Zmień choćby jeden parametr, a odpowiedź może być inna. Zmień miliardy - masz zupełnie inny model.
MIT Technology Review wyróżnia trzy główne rodzaje parametrów. Embeddingi to liczbowy zapis każdego tokenu (słowa albo jego fragmentu) ze słownika modelu - zwykle lista kilku tysięcy liczb na token. Wagi określają siłę połączeń między częściami modelu. Biasy to wartości dodawane (a nie mnożone) w trakcie obliczeń, które przesuwają progi, przy których dana część modelu się „włącza”.
Problem? Zamiast kilku pokręteł masz ich miliardy. W największej Llamie 3.1 - 405 miliardów.
Bo język jest cholernie skomplikowany.
Żeby model rozumiał kontekst, niuanse, ironię, metafory - potrzebuje ogromnej liczby "pokręteł" do dostrajania. Każde słowo, każda relacja między słowami, każdy wzorzec w tekście wymaga osobnych parametrów.
Sam słownik zjada ich mnóstwo. Według MIT Technology Review słownik modelu może liczyć do kilkuset tysięcy tokenów, a embedding każdego z nich to często 4096 liczb. Przy 100 tysiącach tokenów daje to ponad 400 milionów parametrów, zanim model zacznie cokolwiek „rozumieć”.
Dodaj do tego fakt, że model musi rozumieć nie tylko słowa, ale też ich wzajemne relacje w zdaniu, kontekst z poprzednich akapitów, ton wypowiedzi, a nawet intencję pytającego. Każda z tych warstw znaczenia wymaga parametrów odpowiedzialnych za wychwytywanie konkretnych wzorców. Dlatego modele językowe są tak duże - nie z kaprysu, ale z konieczności.
Niekoniecznie.
To jak z megapikselami w aparacie. Przez lata producenci ścigali się w liczbach. 12 megapikseli! 48! 108! Potem okazało się, że liczy się optyka, procesor obrazu, algorytmy.
Z AI podobnie. MIT Technology Review podaje przykład z rodziny Meta: Llama 2 z 70 miliardami parametrów trenowano na 2 bilionach tokenów tekstu, a Llama 3 z 8 miliardami - na ponad 15 bilionach. W testach Meta czatowa wersja Llamy 3 8B wypada lepiej od czatowej Llamy 2 70B we wszystkich pokazanych porównaniach. Liczy się nie tylko liczba pokręteł, ale też to, ile danych model zobaczył i jak go wytrenowano.
Meta wypuściła Llamę 3.1 w trzech rozmiarach: 8B, 70B i 405B (B od ang. billion, czyli miliard parametrów). Przy Llamie 4 sama liczba bywa już myląca: Llama 4 Maverick ma 400 mld parametrów łącznie, ale przy każdym tokenie pracuje tylko 17 mld z nich. To architektura mixture of experts (MoE) - model składa się z wielu „ekspertów” i do każdego fragmentu tekstu włącza tylko część z nich.
Praktyczna wskazówka, jeśli uruchamiasz modele lokalnie: liczba parametrów mówi, ile pamięci potrzebujesz. Parametr zapisany w 16 bitach zajmuje 2 bajty, więc same wagi modelu 8B to ok. 16 GB, a modelu 70B - ok. 140 GB. Po kwantyzacji do 4 bitów (o niej niżej) to ok. 4 GB i ok. 35 GB, plus zapas na działanie programu. Dlatego na zwykłym laptopie zaczyna się od najmniejszych wersji.
Proces wygląda tak:
Model dostaje tekst. Próbuje przewidzieć następne słowo. Myli się. Dostosowuje parametry. Próbuje znowu. Myli się mniej. Dostosowuje. I tak miliardy razy.
Jak uczenie się gry na instrumencie. Na początku wszystkie "pokrętła" są ustawione losowo. Brzmi okropnie. Po milionach powtórzeń model znajduje ustawienia, przy których myli się najrzadziej.
Mechanizm dostosowywania parametrów nazywa się wsteczną propagacją błędu. W uproszczeniu: model sprawdza, które parametry najbardziej przyczyniły się do pomyłki, i koryguje je proporcjonalnie do ich "winy". Robi to warstwa po warstwie, od końca sieci do początku. Powtórzone ogromną liczbę razy, na ogromnych zbiorach tekstu, daje model, który potrafi pisać, tłumaczyć i rozumować.
To kosztuje. Według MIT Technology Review każdy ze 175 miliardów parametrów GPT-3 był w trakcie treningu aktualizowany dziesiątki tysięcy razy, a trening dużego modelu to tysiące wyspecjalizowanych komputerów pracujących bez przerwy przez miesiące. Samo OpenAI podało w pracy o GPT-3, że jego trening pochłonął ok. 314 tryliardów operacji zmiennoprzecinkowych - to liczba z 24 cyframi. Bo te miliardy parametrów same się nie dostroją.
Słowo „parametr” ma w AI jeszcze jedno znaczenie i to częste źródło pomyłek. Korzystając z modelu przez API, w wielu przypadkach możesz ustawić parametry zapytania: temperaturę (temperature), top-p albo top-k. MIT Technology Review nazywa je hiperparametrami.
Temperatura działa jak pokrętło kreatywności: decyduje, czy model wybiera najbardziej prawdopodobne następne słowo, czy częściej sięga po mniej prawdopodobne. Top-p i top-k każą modelowi losować kolejne słowo z puli najbardziej prawdopodobnych. Od nich zależy, czy tekst brzmi twórczo, czy sztampowo.
Najważniejsza różnica: te ustawienia nie zmieniają ani jednej wagi w modelu. Wpływają tylko na to, jak model wybiera słowa z tego, co już umie. Parametry modelu ustawia trening, parametry zapytania - człowiek.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Kilka praktycznych wniosków.
Po pierwsze: większy model jest zwykle wolniejszy i droższy w użyciu. Dlatego producenci dzielą modele na warstwy. W rodzinie GPT-6 najmocniejszy GPT-6 Astra kosztuje w API 10 USD za milion tokenów wejściowych i 50 USD za milion tokenów wyjściowych, a najtańszy GPT-6 Luna - 0,10 USD i 0,50 USD za milion tokenów (stan na 13.10.2026). W ChatGPT mocniejsze modele są w płatnych planach. Ile parametrów ma każda z tych wersji, OpenAI nie podaje.
Po drugie: liczby parametrów najczęściej nie da się porównać, bo najwięksi producenci jej nie ujawniają. W dokumentacji modeli Claude, GPT-6 i Gemini tej liczby nie ma (stan na 13.10.2026). Modele porównuje się po wynikach testów, cenie i szybkości, a nie po rozmiarze.
Po trzecie: małe modele z otwartymi wagami, liczące kilka-kilkanaście miliardów parametrów, możesz uruchomić na własnym komputerze. Nie dorównują największym modelom w chmurze, ale do prostszych zadań często wystarczają. I działają bez wysyłania danych do chmury.
Częsta pomyłka.
Parametry to "pokrętła" w modelu. Są stałe po zakończeniu treningu - zmienić je można tylko kolejnym treningiem, np. douczaniem (fine-tuningiem). Jeśli chcesz dać modelowi nową wiedzę bez ruszania parametrów, służy do tego RAG.
Tokeny to jednostki tekstu, które przetwarzasz: całe słowo albo jego fragment. Słownik modelu może liczyć do kilkuset tysięcy różnych tokenów. Każde zapytanie "zużywa" tokeny - i za nie płacisz w API. Jak tekst dzieli się na tokeny, wyjaśnia artykuł o tokenizacji.
Można to porównać do książki kucharskiej i składników. Parametry to przepis - zapisany raz, niezmienny. Tokeny to składniki, które zużywasz przy każdym gotowaniu. Droga książka kucharska nie sprawia, że składniki są tańsze. I odwrotnie - tanie składniki nie poprawią złego przepisu.
Liczba parametrów mówi, jak duży jest model. Liczba tokenów - ile tekstu przetwarzasz i ile za to zapłacisz. To dwie różne rzeczy.
Modele rosły. GPT-3 z 2020 roku miał 175 miliardów parametrów. Przy GPT-4 OpenAI przestało podawać rozmiar swoich głównych modeli - raport techniczny z 2023 roku wprost zastrzega, że nie zawiera szczegółów architektury, w tym rozmiaru modelu. Liczby krążące w mediach dla nowszych modeli OpenAI, Google czy Anthropic, także te z bilionami parametrów, to szacunki, których producenci nie potwierdzają. Inaczej jest przy modelach z otwartymi wagami: według karty modelu Kimi K3 chińskiej firmy Moonshot AI ma on 2,8 biliona parametrów, z których przy każdym tokenie pracuje 104 miliardy.
MIT Technology Review zauważa, że zyski z samego powiększania modeli maleją, a dokładanie parametrów nie robi już takiej różnicy jak kiedyś. Równolegle dzieje się coś ciekawszego: optymalizacja.
Kwantyzacja zapisuje parametry z mniejszą precyzją: 4 bity zamiast 16 to czterokrotnie mniej pamięci, kosztem pewnej utraty jakości, która zależy od modelu i metody. Przycinanie (pruning) usuwa mniej potrzebne parametry. Destylacja wykorzystuje duży model do wytrenowania mniejszego.
Efekt? Coraz więcej modeli da się uruchomić bez superkomputera.
Parametr to liczba, którą AI dostrajało podczas treningu - jedno z miliardów "pokręteł" pozwalających modelowi rozumieć język.
Teraz gdy widzisz "405B parameters", wiesz co to znaczy. I że liczba imponuje, ale nie jest jedynym co się liczy.
Przeczytaj też:
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Sam Altman zaprosił autora do biura OpenAI. Ten wykorzystał okazję, by powiedzieć pracownikom prawdę o tym, jak ChatGPT wpływa na nauczycieli i uczniów.
Wykładowcy biją na alarm: studenci przestali się uczyć, bo ChatGPT robi za nich pracę. Zamiast walczyć z narzędziem, warto zmienić sposób nauczania?
Terminal X twierdzi, że jego Eval Agent na GPT-6.1 Sol zgadza się ze starszym recenzentem w 88,6% osądów. Sprawdzamy, co to znaczy i czego uczy Cię ta 54-punktowa rubryka.
OpenAI wstrzymało GPT-6.1 Astra ze względów bezpieczeństwa i deklaruje, że ma wewnętrzny model mocniejszy od Astry. Co wiadomo, co to domysły i co dostajesz dziś w ChatGPT.
Mistral AI pokazało Mistral Large 4 z 1,05 bln parametrów. Sprawdzamy, co deklaruje firma, co pokazują benchmarki i czego jeszcze nie wiadomo, w tym o języku polskim.
OpenAI pokazało GPT-6.1 Sol: model ma być bliski GPT-6 Astra w kodowaniu i pracy zawodowej, a kosztuje 1/5 ceny. Według producenta błędy faktograficzne przy niskim wysiłku rozumowania spadły z 11,4% do 7,7%.