Gemini 3.8 TTS: Google uczy AI mówić z emocjami, nie tylko czytać
Przejdź do treści i przykładów

Źródło: Link
Źródło: Link
Znasz ten głos z automatycznej sekretarki. Płaski, równy, bez emocji, jakby ktoś czytał instrukcję obsługi pralki podczas własnego pogrzebu. Przez lata tak właśnie brzmiała syntetyczna mowa. Większość ludzi się z tym pogodziła, traktując to jako cenę za automatyzację. Google właśnie pokazuje, że ta cena spada.
23 września 2026 zespół Gemini Audio (Leland Rechis, Group Product Manager, i Alan Cowen, Director of Research Science) ogłosił dwa nowe modele: Gemini 3.8 Flash TTS i Gemini 3.8 Flash-Lite TTS. Google określa je jako najbardziej ekspresyjne modele generowania audio, jakie do tej pory wypuścili. Dostępne są od razu w kilku miejscach: Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook oraz Google Vids.
Największa zmiana nie dotyczy jakości brzmienia jako takiej, tylko sposobu, w jaki go tworzysz. Zamiast nagrywać godziny materiału albo wybierać z zamkniętej listy gotowych lektorów, opisujesz głos zwykłym zdaniem. Google mówi wprost: możesz stworzyć niestandardowy głos od zera albo odtworzyć istniejący, posługując się prostym promptem w języku naturalnym.
To oznacza, że postać w grze, bohater audiobooka albo wirtualny asystent może mieć głos zaprojektowany pod konkretny charakter, akcent czy nastrój - bez angażowania aktora głosowego do każdej nowej linijki dialogu.
Drugi element to kontrola nad wykonaniem. Modele pozwalają kierować audio krok po kroku, decydując o:
Dostajesz więc coś bliższego reżyserii scenariusza niż odtwarzaczowi tekstu na mowę. Dla kogoś, kto pracuje z podcastami tworzonymi z pomocą AI albo montuje materiały wideo, to konkretna oszczędność czasu: nie musisz wracać do nagrania dwadzieścia razy, żeby wymusić właściwy ton.
Google wskazuje konkretne zastosowania, do których te modele mają się nadawać w praktyce:
To akurat ciekawe dla firm, które od miesięcy szukają sposobu, żeby ich boty głosowe przestały brzmieć jak boty głosowe. Jeśli interesuje Cię, jak podobne rozwiązania działają już po stronie tłumaczenia mowy, sprawdź Gemini Live Translate - Google testował tam podobne podejście do naturalnej mowy w czasie rzeczywistym.
Skoro generowanie realistycznego głosu staje się prostsze, pytanie o nadużycia jest naturalne. Google deklaruje, że modele mają wbudowane narzędzia bezpieczeństwa, w tym znakowanie wodne (watermarking), które ma pomóc odróżnić dźwięk wygenerowany przez AI od nagrania prawdziwej osoby. To nie rozwiązuje problemu deepfake'ów głosowych raz na zawsze, ale pokazuje, że temat traktowany jest jako część produktu, a nie dodatek na później.
Dla porównania: inni gracze na rynku audio AI idą podobną drogą. Alibaba rozwija CosyVoice Studio, co pokazuje, że ekspresyjny, kontrolowalny głos syntetyczny staje się standardem, o który konkurują wszystkie duże firmy technologiczne, nie tylko Google.
Dla polskich twórców i firm największe pytanie brzmi, kiedy i jak dobrze te modele obsłużą język polski z jego intonacją i akcentami regionalnymi. Google w materiale nie precyzuje listy obsługiwanych języków, więc zanim zaczniesz planować produkcję audiobooka po polsku w oparciu o Gemini 3.8 TTS, sprawdź aktualną dokumentację w Google AI Studio.
Głos AI to dopiero jeden klocek. Jeśli chcesz zrozumieć, jak łączyć takie narzędzia w realny proces pracy, zamiast testować je pojedynczo i po omacku, zapisz się na darmowy webinar, gdzie pokazujemy krok po kroku, jak ogarnąć AI bez chaosu. Zapisz się na darmowy webinar →
Co z tego wynika? Głos syntetyczny przestaje być technicznym kompromisem, a staje się narzędziem kreatywnym, którym sterujesz podobnie jak reżyser aktorem. Czy to koniec pracy dla lektorów i aktorów głosowych? Nie od razu i nie wszędzie, ale próg wejścia w produkcję dźwięku z charakterem właśnie mocno się obniżył, a to zawsze zmienia, kto może wejść na ten rynek.
Na podstawie: DeepMind Blog
10 gotowych promptów do codziennej pracy + 5 narzędzi + plan na pierwszy tydzień. PDF, 4 strony konkretu.
Google uruchamia Gemini 3.5 Live Translate - model audio tłumaczący mowę w ponad 70 językach niemal natychmiast. Dostępny w Google AI Studio, Translate i Meet.
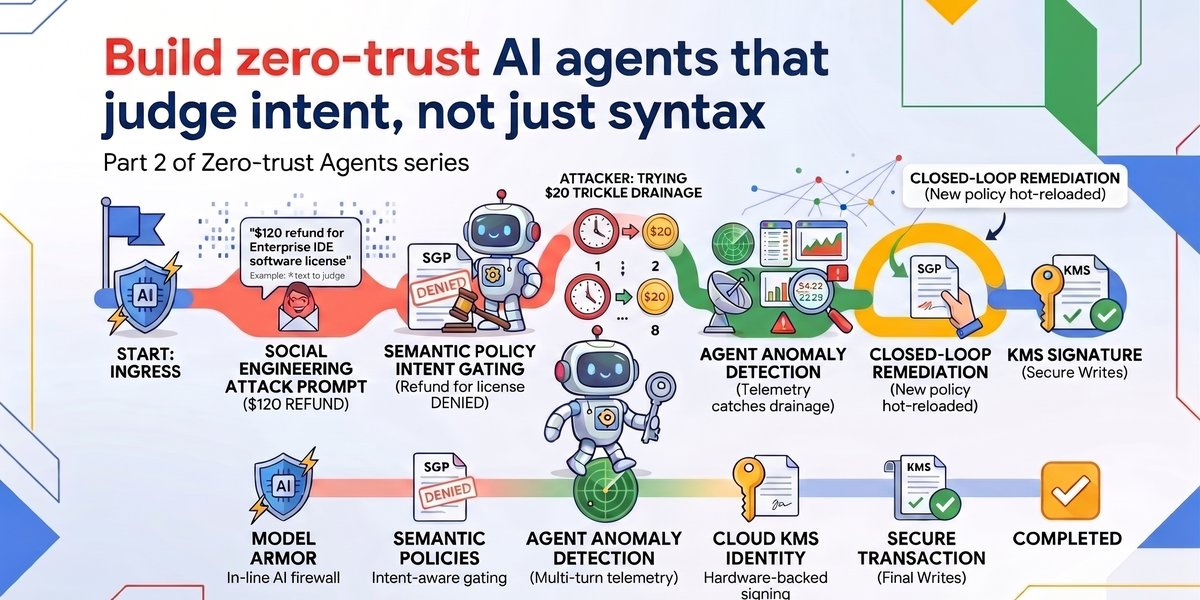
Google pokazuje, jak przenieść zabezpieczenia agentów AI z twardych reguł na poziom platformy, która ocenia zamiar działania, a nie tylko poprawność zapytania.

Google Photos dostaje osobistego asystenta AI. Gemini Spark segreguje albumy, tworzy wspólne kolekcje i zamienia zdjęcia w wydarzenia kalendarza.
Nowy model kosztuje połowę mniej niż 3.6 Flash i ma lepsze wyniki w kodowaniu. Google przyspiesza, bo chińskie modele AI biją ceną.

Google Gemini osiągnął miliard aktywnych użytkowników miesięcznie. 63% rozmawia głosem, a aplikacja generuje 150 milionów obrazów dziennie.
Google rozszerza rodzinę Gemini o trzy modele: 3.6 Flash, 3.5 Flash-Lite i 3.5 Flash Cyber. Stawka jest prosta: niższy koszt, większa skala i mocniejszy nacisk na bezpieczeństwo.