
Polski basal-omni wygrywa JevBench, ale to nie rywal ChatGPT
Przejdź do treści i przykładów

Polski model basal-omni-1.0-ultra, rozwijany przez Remigiusza Kinasa, zajął pierwsze miejsce wśród modeli z otwartymi wagami w rankingu JevBench. W zestawieniu v1.6.28 z 17 października zdobył 82,5 pkt w kategorii Capability Score. Jak opisał 21 października ITwiz, w ocenie trafności decyzji i pewności odpowiedzi wyprzedził m.in. rozwiązania OpenAI i Microsoftu. To wynik testu. Deklaracją jest komentarz autora na X: „Czyli można? Można! Polskie AI”.
Nagłówek „polski model pokonał OpenAI” czyta się jak wiadomość o nowym rywalu ChatGPT. Nim nie jest. Basal powstał do automatyzacji powtarzalnych decyzji, które firmy podejmują tysiące razy dziennie. Zobacz, co ten wynik naprawdę mówi.
JevBench nie sprawdza, który model najlepiej pisze teksty, generuje kod albo prowadzi rozmowę. Sprawdza, jak radzi sobie z podejmowaniem konkretnych decyzji. W teście obejmującym 1500 przypadków system musi wybrać odpowiedź z dostępnych opcji. Ranking ocenia m.in. trafność oraz kalibrację, czyli zgodność deklarowanej pewności z rzeczywistą skutecznością.
Kalibracja to pojęcie z akademickiego słownika, a jest bardzo praktyczna. Model, który mówi „jestem pewien na 95%” i myli się co drugi raz, jest groźniejszy niż taki, który mylił się równie często, ale uczciwie to zaznaczał. Ranking nagradza właśnie tę uczciwość.
Ranking kierowców wózków widłowych nic nie mówi o tym, kto lepiej prowadzi tira. Tak samo wynik basala nie oznacza, że jest ogólnie lepszy od modeli OpenAI czy Microsoftu. W rankingu chodzi o określony typ zadań i konkretną metodę pomiaru.
Liczby warto czytać razem, bo każda mówi coś innego:
Tyle faktów. Do tabeli wynikowej wracaj samodzielnie, bo ranking ma wersje i może się zmieniać. Opisany wynik dotyczy wersji z 17 października.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Basal to autorski projekt Remigiusza Kinasa. Składa się z własnego silnika uruchomieniowego basal-serve i dwóch rodzin modeli. Basal-2.0 bazuje na polskim Bieliku v3, a basal-omni na modelu Gemma 4 od Google. Kinas pracuje jako Principal AI Researcher w Ingenix.ai i jest jednym ze współtwórców polskich modeli Bielik.
Model ma dawać konkretną decyzję, a nie rozbudowaną odpowiedź. Może na przykład:
Silnik obsługuje wybór jednej lub kilku odpowiedzi, decyzje „tak”, „nie” albo „nie wiadomo”, ocenianie na skali i analizę dokumentów. Najciekawsza jest opcja „nie wiadomo”. Jeśli model nie ma wystarczającej pewności, może przekazać sprawę człowiekowi. Twórca rozwija też mechanizmy, które określają, kiedy model może rozstrzygnąć sprawę sam, a kiedy powinien oddać ją pracownikowi.
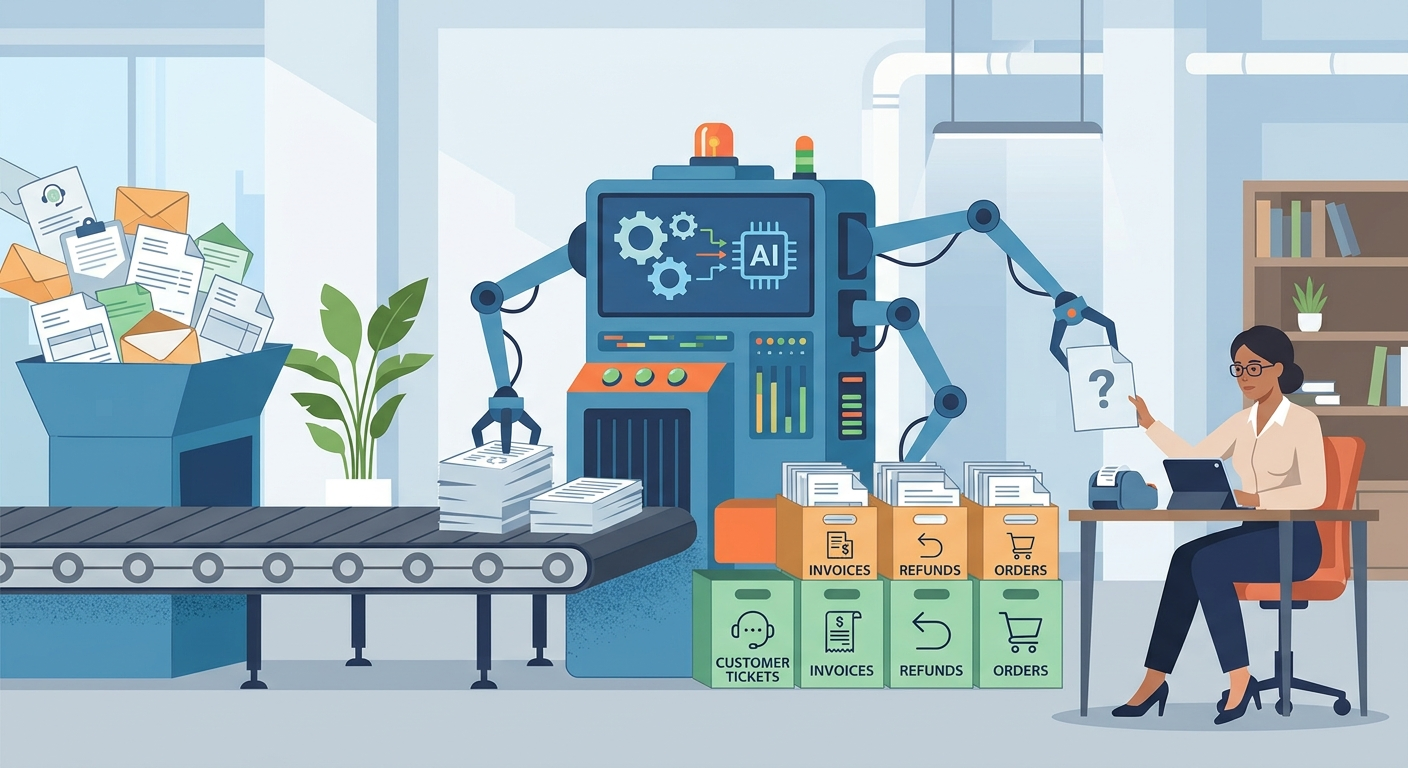
Taki układ ma sens tam, gdzie firma obsługuje duże liczby podobnych spraw. Zamiast angażować rozbudowany model językowy do każdej operacji, możesz użyć systemu, który szybko wybiera jedną z określonych odpowiedzi. Podobne zadania, czyli klasyfikację, ekstrakcję i routing, Anthropic przypisuje swojemu najtańszemu modelowi, opisanemu w tekście o Claude Haiku 5.5. Pole do wyboru rośnie, ale porównywać trzeba na własnych danych. Rankingi mierzą inne rzeczy niż Twoje faktury.
Kod silnika basal-serve jest na GitHubie, a modele na Hugging Face. Firma może więc uruchomić je na własnej infrastrukturze, bez przesyłania danych do zewnętrznego dostawcy usługi. To ważne zwłaszcza przy dokumentach z danymi osobowymi albo informacjami objętymi tajemnicą przedsiębiorstwa. Licencję i wymagania uruchomieniowe sprawdzisz w repozytorium na GitHubie i na karcie modelu w Hugging Face.
Otwarte wagi wracają też przy europejskich modelach, na przykład Mistral Large 4. Dla polskiej firmy ciekawy jest tu jeszcze jeden wątek. Część tego projektu wyrasta z polskiego Bielika.
Rodzina basal-omni obsługuje tekst, obrazy i w części wariantów dźwięk. Nie wszystkie możliwości są równie dojrzałe. Kinas zaznacza, że funkcje eksperymentalne trzeba sprawdzić na własnych danych, zanim trafią do firmowych procesów. Samo udostępnienie modelu nie znaczy, że możesz od razu powierzyć mu procesy biznesowe.
Według twórcy start nie wymaga trenowania modelu od podstaw. Uruchamiasz silnik, opisujesz zadanie i sprawdzasz działanie na przykładach z własnej organizacji. Dopiero po takich testach widać, które decyzje model może podejmować sam. To ta sama lekcja, którą daje każdy test własny producenta: liczba z rankingu jest punktem wyjścia, nie zgodą na wdrożenie.
Masz powtarzalną decyzję w pracy, na przykład segregowanie maili do działów albo sprawdzanie, czy faktura ma komplet danych? Weź dziś 20 prawdziwych przypadków z ostatnich dni i przy każdym zapisz, jaka odpowiedź była właściwa. Zaznacz te, przy których wahanie trwało dłużej niż chwilę. To zajmie kwadrans, a dostaniesz gotowy zestaw testowy i wiedzę, ile spraw mógłby przejąć model, a ile powinno zostać u człowieka.
Na podstawie: ITwiz
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Alibaba wypuściło preview Qwen 3.7 - najlepszego chińskiego modelu AI. Problem w tym, że Anthropic, Google i OpenAI wciąż są o krok dalej.
OpenAI od 21 października 2026 wdraża Locked Chats: rozmowy chowasz za PIN-em. Co ta blokada robi, czego nie robi i co traci się po resecie kodu?
OpenAI wdraża GPT-Live-1.1 w trybie głosowym ChatGPT: 13 nowych głosów, lepsze akcenty i mniej powtarzanego „sprawdzam”. Polskiego głosu brak, a limity zależą od planu.
ByteDance dodało do Doubao Work import ustawień, pamięci, projektów i czatów z ChatGPT, Claude Code i TRAE Work. Do tego adnotacje w odpowiedziach i boczny panel podsumowania.
Intelligent UI w ChatGPT: od 7 października 2026 GPT-6 odpowiada przyciskami, formularzami i wykresami, Free i Go od 8 października. Gdzie działa, jak ją ograniczyć i co mówi OpenAI.
OpenAI wprowadza niewidzialny znak wodny textGrain w tekstach z ChatGPT i Codex. Start w UE, API z opt-in na świecie, detektor tylko dla wybranych badaczy.