
DeepSeek - chiński model AI, który zaszokował branżę
Przejdź do treści i przykładów
Liang Wenfeng, założyciel DeepSeek, od początku przekonywał, że zbudowanie modelu na poziomie GPT-4 nie wymaga miliardów dolarów. W grudniu 2024 wypuścił DeepSeek-V3, który w niektórych benchmarkach dorównywał najlepszym wtedy modelom zamkniętym - GPT-4o i Claude 3.5 Sonnet. Koszt treningu? Ułamek tego, co wydają OpenAI czy Anthropic.
Aktualizacja 13.10.2026: dopisaliśmy, co DeepSeek wydał od tamtej pory (V3.1, V3.2, V4 Pro i V4.1 Flash), aktualne ceny API z porównaniem do modeli OpenAI i Anthropic oraz informacje z polityki prywatności i regulaminu API. Usunęliśmy porównania jakości bez źródeł i poprawiliśmy kilka szczegółów technicznych według raportów DeepSeek. Stan na 13.10.2026.
To nie jest kolejna historia o "chińskim klonie". To historia o tym, jak zespół z Hangzhou zmienił zasady - i zmusił całą branżę do przemyślenia, ile naprawdę kosztuje zbudowanie dobrego modelu AI.
DeepSeek to firma badawcza założona przez Liang Wenfeng, który wcześniej prowadził High-Flyer Capital Management - jeden z największych funduszy quantowych w Chinach. W 2023 roku postanowił, że zamiast tylko inwestować w AI, sam zbuduje model językowy.
Różnica między DeepSeek a typowym startupem AI? Liang nie szukał kapitału venture. Finansował badania z własnych pieniędzy, co dało mu coś rzadkiego w tej branży - wolność od presji inwestorów na szybką komercjalizację.
Zespół zaczął od prostego pytania: czy da się zbudować model konkurencyjny wobec GPT-4, ale bez dostępu do najnowszych chipów NVIDIA (które USA zablokowało w eksporcie do Chin) i bez budżetu rzędu setek milionów dolarów?
DeepSeek Coder (2023) był pierwszym sygnałem, że coś się dzieje. Model specjalizujący się w kodowaniu - według DeepSeek wersja Instruct 33B wypadała w teście HumanEval lepiej niż GPT-3.5 Turbo - a do tego z otwartymi wagami i licencją pozwalającą na użycie komercyjne. Warto pamiętać, że sam HumanEval jest dziś uznawany za wysycony i mało reprezentatywny - dzisiejsze modele porównuje się raczej na trudniejszych testach, takich jak GPQA Diamond czy SWE-bench Pro (OpenAI od lutego 2026 nie ocenia już modeli na SWE-bench Verified, bo uznało go za zanieczyszczony).
DeepSeek-V2 (2024) poszedł dalej - model ogólnego przeznaczenia z architekturą Mixture of Experts (MoE), który pokazał, że można trenować duże modele efektywniej niż przez zwykłe skalowanie parametrów.
Oba modele miały jedną wspólną cechę: były dostępne publicznie z pełnymi wagami. W świecie zdominowanym przez zamknięte API OpenAI i Anthropic to była rzadkość.
W grudniu 2024 DeepSeek wypuścił V3 - i tu zaczęło się prawdziwe zamieszanie. Model miał 671 miliardów parametrów (z czego aktywnych przy każdym tokenie było 37 miliardów dzięki MoE), a według raportu technicznego jego finalny trening kosztował około 5,6 miliona dolarów: 2,788 mln godzin pracy kart H800 przy założonej cenie wynajmu 2 dolarów za godzinę.
DeepSeek sam zaznacza, że ta kwota obejmuje tylko finalny trening - bez wcześniejszych badań i eksperymentów z architekturą, algorytmami i danymi. Porównania z kosztami amerykańskich laboratoriów trzeba więc traktować ostrożnie - liczby nie są liczone w ten sam sposób.
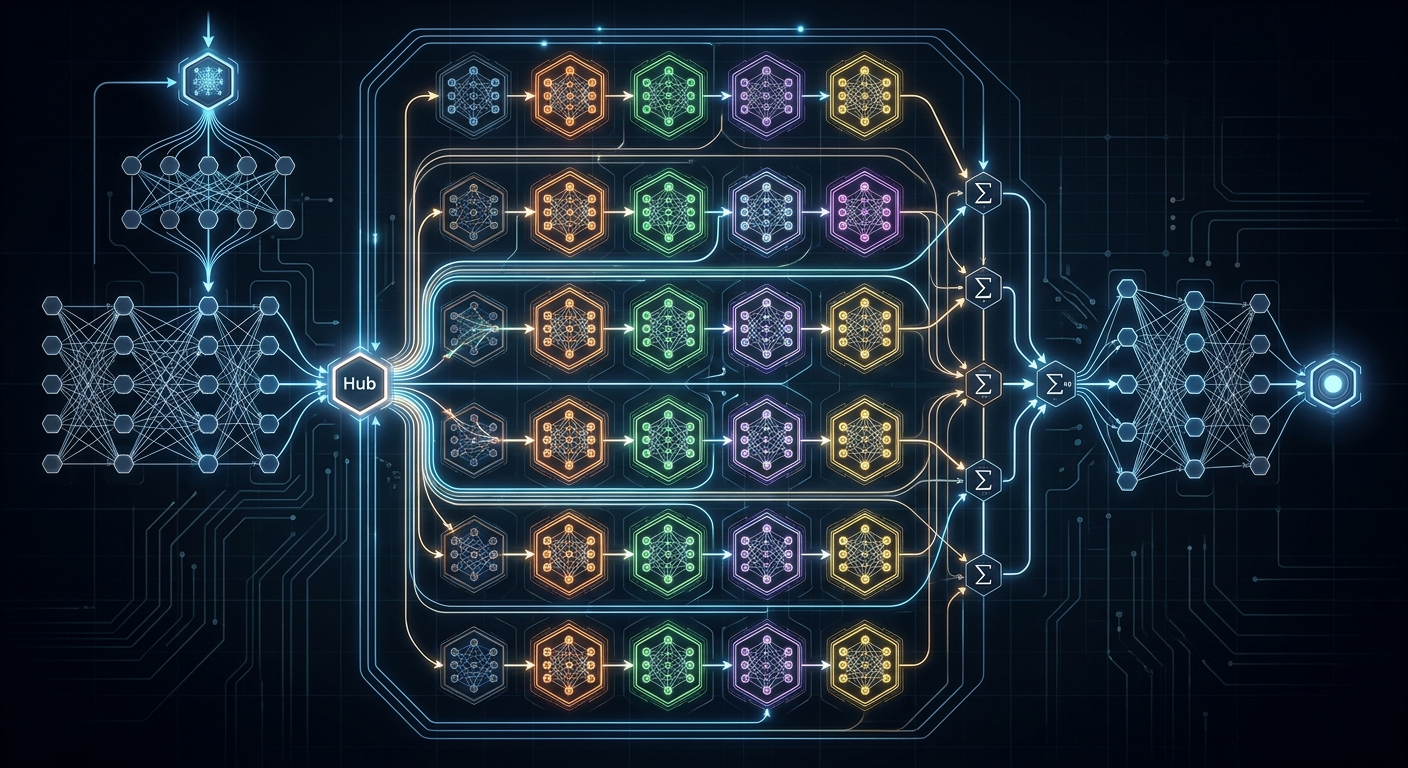
DeepSeek-V3 nie wygrał przez magię. Wygrał przez inżynierię. Zespół zastosował kilka rozwiązań, które obniżyły koszty bez utraty jakości:
Żadna z tych technik nie jest rewolucyjna sama w sobie. Rewolucyjne jest to, że DeepSeek połączył je w sposób, który działa w praktyce - i udostępnił szczegóły w otwartych publikacjach.
W styczniu 2025 przyszedł R1 - odpowiedź DeepSeek na o1 od OpenAI. Model zaprojektowany nie do szybkich odpowiedzi, ale do głębokiego rozumowania w zadaniach matematycznych, naukowych i programistycznych.
R1 działa inaczej niż standardowe modele. Zamiast od razu generować odpowiedź, "myśli na głos" - generuje wewnętrzny łańcuch rozumowania (chain of thought), który możesz zobaczyć w interfejsie. Patrzysz, jak ktoś rozwiązuje zadanie krok po kroku.
W AIME 2024 (American Invitational Mathematics Examination) - teście matematycznym dla licealistów - R1 osiągnął według DeepSeek 79,8% wobec 79,2% dla o1 od OpenAI. W GPQA Diamond (pytania naukowe na poziomie doktoranckim) wypadł nieco słabiej: 71,5% wobec 75,7%.
Różnica? R1 jest dostępny jako open source na licencji MIT. Możesz go pobrać, uruchomić na własnym, mocnym sprzęcie i zobaczyć dokładnie, jak działa. OpenAI nie udostępnia wag o1.
Od wersji V3.1 (sierpień 2025) DeepSeek nie rozwija już osobno modelu "zwykłego" i modelu rozumującego. Najważniejsze daty według dziennika zmian API (stan na 13.10.2026):
Dziś w API są więc dwa modele: deepseek-flash (V4.1 Flash) i deepseek-v4-pro (V4 Pro). Oba mają okno kontekstu 1 mln tokenów, tryb z myśleniem i bez oraz wyjście do 384 tys. tokenów. Stare nazwy deepseek-chat i deepseek-reasoner miały zostać wyłączone po 24.07.2026 (zapowiedź DeepSeek z 24.04.2026).
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Porównanie modeli AI to zawsze komplikacja, bo każdy jest dobry w czym innym. Kilka rzeczy da się jednak powiedzieć konkretnie.
Przy premierze wersji preview (kwiecień 2026) DeepSeek pisał, że V4 Pro to najlepszy otwarty model w testach agentowego programowania, a w wiedzy ogólnej wyprzedza wszystkie otwarte modele i ustępuje tylko Gemini 3.1 Pro. O V4.1 Flash firma pisze, że w testach wyprzedza flagowe modele, w tym własny V4 Pro. To deklaracje producenta, liczone na wybranych przez niego testach i ustawieniach, więc nie da się ich wprost zestawić z wynikami GPT-6.1 Sol czy Claude Opus 5.5, które publikują OpenAI i Anthropic. Starsze teksty na blogu - np. o Claude Sonnet 5 czy o GPT-5.6 - opisują poprzednie generacje modeli.
Tu porównanie jest proste, bo wszyscy podają ceny w dolarach za milion tokenów. DeepSeek od sierpnia 2026 ma dwie stawki: szczytową (w dni robocze 01:00-04:00 i 06:00-10:00 UTC, poza chińskimi świętami) i o połowę niższą w pozostałych godzinach.
| Model | Wejście (USD za 1 mln tokenów) | Wyjście (USD za 1 mln tokenów) |
|---|---|---|
| DeepSeek V4.1 Flash | 0,30 (poza szczytem 0,15) | 1,20 (poza szczytem 0,60) |
| DeepSeek V4 Pro | 1,32 (poza szczytem 0,66) | 3,96 (poza szczytem 1,98) |
| GPT-6 Luna (OpenAI) | 0,10 | 0,50 |
| GPT-6.1 Sol (OpenAI) | 2 | 10 |
| Claude Haiku 5.5 (Anthropic) | 0,10 | 0,50 |
| Claude Sonnet 5.5 (Anthropic) | 2 | 10 |
| Claude Opus 5.5 (Anthropic) | 4 | 20 |
Ceny wejścia DeepSeek dotyczą tokenów spoza pamięci podręcznej (cache), ceny GPT-6.1 Sol - kontekstu do 272 tys. tokenów, a Claude Haiku 5.5 przy promptach dłuższych niż 100 tys. tokenów kosztuje 0,50 USD za wejście i 2,50 USD za wyjście. Wniosek: V4 Pro jest wyraźnie tańszy od GPT-6.1 Sol i Claude Opus 5.5, ale DeepSeek nie zawsze jest najtańszy - GPT-6 Luna i Claude Haiku 5.5 (przy promptach do 100 tys. tokenów) mają niższe stawki za token niż V4.1 Flash, nawet poza szczytem. Pamiętaj też, że cena za token to nie cały koszt: modele zużywają różną liczbę tokenów na to samo zadanie.
Testy, które DeepSeek podaje w ogłoszeniach modeli, nie obejmują języka polskiego. Jeśli potrzebujesz modelu do pisania tekstów marketingowych, podsumowań raportów czy rozmów z klientami, porównaj kilka modeli na własnych materiałach po polsku. Do zadań technicznych (kod, matematyka) język ma mniejsze znaczenie.
Żaden chiński model AI nie wychodzi na rynek bez pytań o bezpieczeństwo danych i cenzurę. DeepSeek nie jest wyjątkiem.
DeepSeek, jak wszystkie modele trenowane w Chinach, ma wbudowane filtry blokujące pytania o wrażliwe tematy polityczne (Tiananmen, Tybet, Xinjiang, tajwańska niepodległość). Jeśli zapytasz o te tematy, dostaniesz odmowę odpowiedzi.
Dla użytkowników w Chinach to standard. Dla użytkowników na Zachodzie - problem. Chiński kontekst bywa trudny także dla firm z USA - zobacz, jak Anthropic potraktował użytkowników Claude Code z Chin.
DeepSeek oferuje API, stronę z czatem i aplikacje. Gdzie trafiają dane? Polityka prywatności aplikacji i strony (aktualizacja z 10.02.2026) mówi wprost, że DeepSeek zbiera, przetwarza i przechowuje dane osobowe w Chińskiej Republice Ludowej. Dane mogą też służyć do trenowania modeli - polityka wymienia prawo do sprzeciwu wobec takiego użycia wśród praw, które mogą przysługiwać użytkownikowi, zależnie od miejsca zamieszkania. Regulamin API (obowiązuje od 29.04.2026) podlega prawu ChRL, a spory rozstrzyga sąd właściwy dla siedziby firmy w Hangzhou.
Jeśli pracujesz z danymi wrażliwymi (medycznymi, finansowymi, korporacyjnymi) - używanie DeepSeek przez API jest ryzykowne. Jeśli pobierzesz wagi modelu i uruchomisz lokalnie - ten problem znika, ale potrzebujesz bardzo mocnego sprzętu.
USA zablokowało eksport najnowszych chipów NVIDIA (A100, H100) do Chin. DeepSeek trenował modele na układach o obniżonych parametrach - w raporcie technicznym V3 firma podaje 2048 kart H800 (eksportowa, ograniczona wersja H100).
To rodzi pytanie: czy podany koszt treningu (5,6 mln USD za finalny trening V3) oddaje całość wydatków? Jeśli DeepSeek miał dostęp do lepszych chipów przez szare kanały, realne koszty mogły być wyższe. Sam raport podkreśla tylko, że kwota nie obejmuje wcześniejszych badań i eksperymentów.
DeepSeek pokazał trzy rzeczy, które zmieniają rozmowę o AI:
Pierwszy: Nie potrzebujesz budżetu Google, żeby zbudować konkurencyjny model. Inteligentna architektura i efektywne techniki treningu mogą zrównoważyć przewagę w zasobach. Dobra wiadomość dla startupów i mniejszych graczy.
Drugi: Open source w AI nie jest martwy. Przeciwnie - modele z otwartymi wagami (DeepSeek, Llama 4, Qwen 3) doganiają zamknięte API w coraz większej liczbie zadań.
Trzeci: Geopolityka AI się komplikuje. USA próbuje kontrolować rynek przez ograniczenia eksportowe chipów. Chiny odpowiadają efektywnością - DeepSeek pokazał, że konkurencyjne modele da się trenować na ograniczonym sprzęcie. Zamiast zatrzymać rozwój AI w Chinach, ograniczenia zmuszają chińskie firmy do innowacji.
Dla polskich firm i użytkowników DeepSeek to ciekawa opcja, ale z zastrzeżeniami. Jeśli potrzebujesz modelu do zadań technicznych (kodowanie, analiza danych, matematyka) i możesz uruchomić go lokalnie - warto przetestować. Jeśli pracujesz z danymi klientów i musisz korzystać z API w chmurze, wybierz dostawcę, który podpisze z Tobą umowę powierzenia przetwarzania danych zgodną z RODO i jasno określi, gdzie dane są przetwarzane. Na tle DeepSeek ciekawy jest przykład z naszego podwórka: NASK dostał od OpenAI dostęp do specjalistycznego modelu do cyberbezpieczeństwa.
Polskie uczelnie i instytuty badawcze mogą skorzystać na otwartych wagach DeepSeek - licencja MIT, na której wydano R1 i modele z serii V4, pozwala na eksperymenty i użycie komercyjne bez opłat licencyjnych i bez kosztów API.
Ten artykuł pokazuje, jak działa DeepSeek. W kursie AI Evolution uczę, jak praktycznie używać modeli językowych - od podstaw promptowania przez wybór odpowiedniego modelu do zadania, po budowanie własnych workflow. 118 lekcji, 5 poziomów, aktualizacje co tydzień.
Sprawdź AI Evolution →Nie jesteś pewien? Zacznij od darmowego webinaru na żywo - 90 minut konkretów o AI.
Wagi modeli są do pobrania za darmo. Na licencji MIT udostępniono m.in. R1, V3-0324, V4 Pro, V4 Flash i V4.1 Flash; pierwsza wersja V3 i DeepSeek Coder mają własną licencję DeepSeek, która też pozwala na użycie komercyjne. API jest płatne: V4.1 Flash kosztuje 0,30 USD za milion tokenów wejścia i 1,20 USD za milion tokenów wyjścia, V4 Pro - 1,32 i 3,96 USD, a poza godzinami szczytu stawki są o połowę niższe (stan na 13.10.2026).
Jeśli uruchomisz model lokalnie na własnych serwerach - dane nie wychodzą poza Twoją infrastrukturę. Jeśli używasz API albo aplikacji DeepSeek, pamiętaj, że według polityki prywatności dane są przetwarzane i przechowywane w Chinach, a regulamin API podlega prawu chińskiemu. Przed wysłaniem danych klientów skonsultuj to z inspektorem ochrony danych.
Tego nie da się ocenić na podstawie danych producenta. Według raportu technicznego V3 dane treningowe objęły także inne języki niż angielski i chiński, ale DeepSeek nie publikuje wyników dla języka polskiego. Jeśli tekst po polsku jest dla Ciebie ważny, porównaj DeepSeek z innymi modelami na własnych przykładach. Do zadań technicznych (kod, matematyka) język ma mniejsze znaczenie.
Tak. Model ma wbudowane filtry blokujące pytania o wrażliwe tematy polityczne w Chinach (Tiananmen, Tybet, Xinjiang, Tajwan). Jeśli zapytasz o te tematy, dostaniesz odmowę odpowiedzi. W innych obszarach (nauka, technologia, kultura) model odpowiada normalnie.
Bardzo mocny. Repozytoria z wagami na Hugging Face zajmują około 865 GB w przypadku V4 Pro, około 510 GB w przypadku V4.1 Flash i około 690 GB w przypadku V3 (stan na 13.10.2026). Do sprawnej pracy model powinien zmieścić się w pamięci kart graficznych, więc w praktyce to zadanie dla serwera z wieloma GPU klasy centrum danych, nie dla domowego komputera. Dla większości użytkowników realną opcją jest API albo mniejsze modele z otwartymi wagami.
Tak. Wersja preview V4 Pro i V4 Flash trafiła do API 24.04.2026, V4 Flash w wersji oficjalnej 31.07.2026, a V4 Pro w wersji ogólnodostępnej 13.08.2026. 10.09.2026 DeepSeek wydał V4.1 Flash, który zastąpił V4 Flash. W API wywołujesz go jako deepseek-flash, a V4 Pro jako deepseek-v4-pro (stan na 13.10.2026).
Zależy od przypadku użycia. Jeśli pracujesz głównie z kodem lub zadaniami matematycznymi i chcesz obniżyć koszty API - DeepSeek V4 Pro jest wyraźnie tańszy od GPT-6.1 Sol i Claude Opus 5.5, więc warto go przetestować. Jeśli liczy się najniższa cena za token, porównaj go też z GPT-6 Luna i Claude Haiku 5.5. Jeśli pracujesz z danymi klientów, ważniejsze od ceny mogą być lokalizacja danych i regulamin. Przetestuj kilka modeli i porównaj wyniki w swoim konkretnym zadaniu.
Na podstawie: AI Evolution Blog
Źródła aktualizacji (13.10.2026): DeepSeek - Change Log, DeepSeek - Models & Pricing, DeepSeek V4 Preview, DeepSeek-V4.1-Flash, DeepSeek-V3 Technical Report, DeepSeek-R1 (GitHub), DeepSeek Coder (GitHub), DeepSeek na Hugging Face, DeepSeek Privacy Policy, DeepSeek Open Platform Terms of Service, OpenAI - cennik API, Anthropic - cennik API, OpenAI - dlaczego nie oceniamy już SWE-bench Verified
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
DeepSeek ogłosiła 20.10 otwarcie kodu DeepInfer, oprogramowania do uruchamiania swoich modeli AI. Co to oznacza i gdzie sprawdzić licencję oraz wyniki.
DeepSeek pokazuje V4.1-Flash z encoder-decoder MoE, milionem tokenów kontekstu i kompresją KV do ~890 bajtów na token. Architektura ma obniżyć koszt agentów AI.
Llama 4, DeepSeek V4, Mistral, Qwen 3 - kompletny przewodnik po modelach open-source, które możesz uruchomić lokalnie lub przez API. Porównanie z komercyjnymi, ceny, praktyczne zastosowania.
Trzy topowe modele AI, trzy różne podejścia. Sprawdzamy, który sprawdzi się w kodowaniu, analizie danych i codziennej pracy - bez marketingowego bełkotu.

DeepSeek-V4-Flash-Vision-Exp trafił na Hugging Face na licencji MIT. Model V4 po raz pierwszy widzi obrazy, nie tylko czyta tekst.
Falcon, Mistral, Claude, Llama - dziesiątki modeli AI, setki wariantów. Który wybrać do swojego projektu? Praktyczny przewodnik po kolekcji dużych modeli językowych.