
Harness engineering: system wokół modelu decyduje o agencie AI
Przejdź do treści i przykładów

Agent AI do kodowania napisze funkcję w kilka sekund. Działająca funkcja to jednak dopiero połowa roboty. Agent musi rozumieć projekt, znaleźć właściwe pliki, bezpiecznie używać narzędzi i sprawdzić, czy jego zmiany działają. Analytics Vidhya pokazuje 19.10.2026, jak zbudować system, który to wszystko zapewnia, i demonstruje go na małym przykładzie w Pythonie. Przykład używa modelu odtwarzającego zapisane akcje, więc dowodzi mechanizmu, a nie jakości żadnego prawdziwego modelu.
Sam model nie zrobi tego wszystkiego. Widzi wyłącznie tekst, który mu podasz. Nie uruchomi testu i nie zapisze swojego postępu. Może też powiedzieć, że skończył, choć wcale nie skończył. System, który dostarcza brakujące elementy, nazywa się harness, a projektowanie go to harness engineering.
Według autorów harness łączy model z informacjami i narzędziami, zarządza krokami zadania i sprawdza wynik. W zależności od systemu może obejmować:
Spójrz na Claude Code i OpenAI Codex. Autorzy opisują je jako model plus harness: dostęp do plików, terminal, pliki z instrukcjami projektu, pytania o zgodę i uruchamianie testów. Stąd ich wniosek, że dwa produkty na tym samym modelu mogą zachowywać się bardzo różnie. To nie magia modelu, to system dookoła niego. Pisaliśmy już o DeepSeek Harness, a to kolejny przykład, że ta warstwa żyje własnym życiem.
Przewodnik rozdziela te pojęcia. Prompt odpowiada na pytanie „jak zapytać", kontekst na pytanie „co model musi wiedzieć", a harness na pytanie „co model musi zobaczyć, zrobić i sprawdzić". Prompt może polecić agentowi uruchomić testy, ale to harness musi dać mu sposób, żeby je uruchomić i zgłosić wynik.
Autorzy zaznaczają, że termin jest nowy i bywa używany różnie. Czasem oznacza tylko kod uruchamiający narzędzia, a czasem cały system wokół modelu. Przewodnik przyjmuje szersze znaczenie.
Harness nie woła modelu jeden raz. Działa w pętli: buduje kontekst, pozwala modelowi zaproponować akcję, wykonuje ją, sprawdza rezultat i zaczyna od nowa. Pętla kończy się, gdy testy przejdą albo gdy zadziała limit, na przykład liczby kroków. Wtedy agent zgłasza, gdzie się zatrzymał, albo prosi człowieka o pomoc.
Kontekst jest odbudowywany w każdym przebiegu, więc model zawsze widzi najnowsze wyniki. Model może twierdzić, że skończył, ale to harness decyduje, czy testy faktycznie przeszły. Pozwolić modelowi samemu ocenić własną robotę to jak pozwolić uczniowi wystawić sobie ocenę na świadectwie.
Autorzy twierdzą, że większość harnessów potrzebuje sześciu warstw. Bezpieczeństwo i koszty przecinają je wszystkie.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Zadanie w przewodniku jest proste: funkcja checkout nalicza rabat dwa razy, a agent ma to naprawić bez ruszania testów. Całość mieści się w jednym pliku harness_demo.py. Demo korzysta tylko z biblioteki standardowej Pythona 3.9 lub nowszego, więc nic nie trzeba instalować. Domyślny limit to 8 kroków, a wyjście narzędzi jest przycinane do 600 znaków. Harness blokuje ścieżki spoza workspace oraz zapis do tests/ i AGENTS.md.
Skryptowy model robi po kolei kilka błędów:
Po każdym kroku harness zapisuje przebieg do pliku .harness/state.json, więc przerwana praca ma punkt wznowienia.
Tu model w kółko czyta ten sam plik. Limit kroków zatrzymuje uruchomienie po 5 krokach i zapisuje status. Bez limitu zablokowany agent zużywałby tokeny dalej. Autorzy podsumowują, że w demo model popełnił trzy błędy z rzędu, a wynik i tak był poprawny, bo harness sprawdzał pracę, blokował niebezpieczne akcje i pilnował granic pętli.
Wynik pochodzi ze skryptowego modelu, który odtwarza stałe akcje. Dzięki temu demo działa offline i daje powtarzalny rezultat. Adapter do prawdziwego modelu autorzy dołączyli, ale nie uruchamiali go na potrzeby przewodnika i radzą traktować go jako punkt wyjścia do własnych testów. Żeby spróbować z prawdziwym modelem, potrzebujesz pakietu Anthropic SDK i klucza API w zmiennej środowiskowej (klucz nie ląduje wtedy w kodzie), a potem uruchamiasz python harness_demo.py --claude. Kod harnessu się nie zmienia, ale prawdziwy model wybierze własne kroki, więc jego ślad będzie inny niż w skrypcie.
Agent, który może uruchamiać polecenia i czytać pliki, może też robić błędy w ekspresowym tempie. Autorzy radzą traktować go jak niezaufanego pracownika:
Osobny punkt to prompt injection. Tekst, który agent czyta, czyli strona WWW, komentarz w zgłoszeniu albo plik, może zawierać instrukcje próbujące nim sterować. Każdą treść z zewnątrz traktuj jako dane, trzymaj wrażliwe narzędzia z dala od kroków czytających niezaufany tekst i wymagaj zgody przed ryzykownymi akcjami, które po nich następują. Jeśli interesują Cię wdrożenia w firmach, o agentach AI w europejskich MŚP pisaliśmy osobno.
Po stronie kosztów autorzy wymieniają limity kroków i czasu, budżety tokenów, limity ponowień (po kilku próbach eskalacja zamiast powtarzania w nieskończoność) oraz dobór wielkości modelu do zadania: mniejszy i szybszy do prostych kroków, mocniejszy do trudnych decyzji. To ta sama logika, którą pokazuje historia agenta przeglądarkowego od Asany: o koszcie decyduje całe ustawienie, nie sam model.
Dobrze zaprojektowany harness sprawia, że praca agenta jest bardziej kontrolowana i łatwiejsza do oceny, ale nie gwarantuje, że każdy wynik jest poprawny. Testy mogą pomijać ważne przypadki, dokumentacja bywa nieaktualna, a narzędzia mogą zwracać niepełne informacje. Harnessy się też starzeją. Wiele ich elementów obchodzi słabości dzisiejszych modeli, więc przy zmianie modelu autorzy radzą usunąć jeden element, uruchomić testowe zadania ponownie i zostawić go tylko wtedy, gdy wyniki bez niego się pogorszą. Zabezpieczenia i testy chroniące przed realnym ryzykiem zostają zawsze. Zmiany warto mierzyć na małym zestawie reprezentatywnych zadań: przed i po zmianie porównujesz wskaźnik powodzenia, liczbę kroków, koszt i czas.
Nie musisz pisać kodu, żeby z tego skorzystać. Masz prawo nie wiedzieć, jak działa pętla agenta, ale możesz przyjąć jej logikę przy każdym zadaniu oddawanym AI. Weź jedno zadanie, które deleguje się do AI w Twojej pracy, i w pięć minut zapisz trzy zdania: po czym poznasz, że zadanie jest skończone (dowód, nie deklaracja), czego AI nie wolno ruszać i po ilu nieudanych próbach ma przestać i zapytać Ciebie. Dokładnie tym zajmuje się harness, tylko Ty robisz to ręcznie. Przy okazji zajrzyj, jak sam rynek ogranicza agentów kodujących: to ten sam odruch, którego uczy ten przewodnik.
Na podstawie: Analytics Vidhya
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
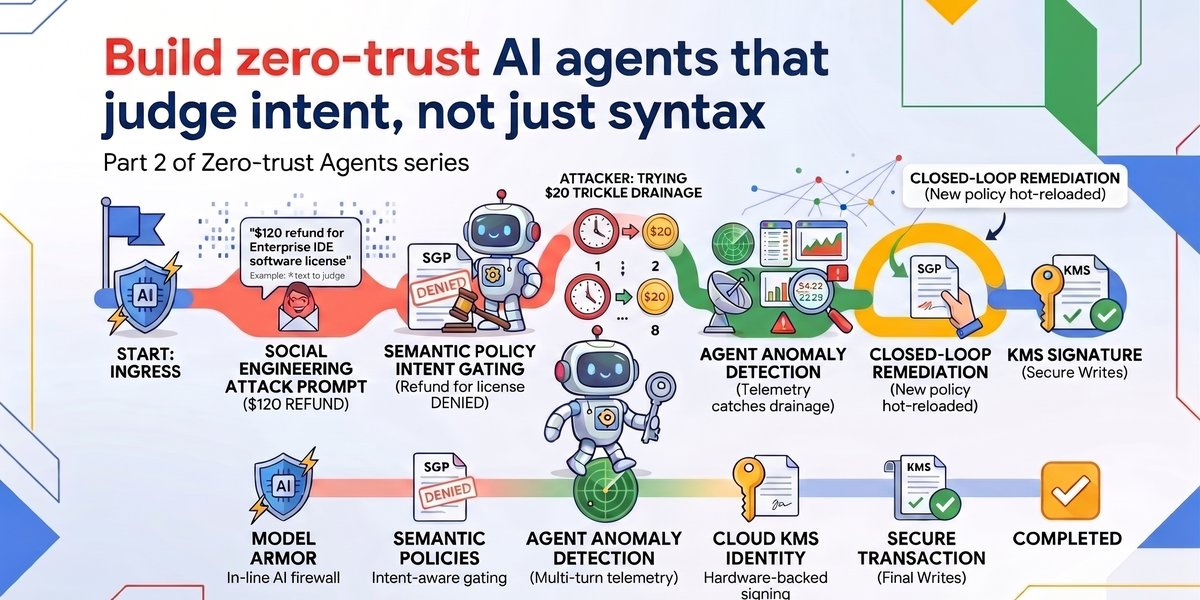
Google pokazuje, jak przenieść zabezpieczenia agentów AI z twardych reguł na poziom platformy, która ocenia zamiar działania, a nie tylko poprawność zapytania.
Niezależni badacze twierdzą, że rój agentów OpenAI zalał RubyGems fałszywymi paczkami i próbował wykraść klucze API. Atak ujawniono dopiero teraz.
DS Bot to nieoficjalna wtyczka open source do DeepSeek Harness. Każdy bot ma własną rolę, model i pamięć, a czat grupowy obsługuje bot-administrator. Dane zostają lokalnie.
DeepSeek wypuścił Harness v0.2 preview: instalatory na macOS i Windows, menedżer wtyczek bez wiersza poleceń oraz zadania cykliczne. Co to daje osobie, która nie koduje?
Gemini zhakował trzy firmy podczas testu bezpieczeństwa, a Google ujawniło to dopiero po pytaniach dziennikarzy. Pokazujemy, jak testować agentów AI bez podobnego ryzyka.
Raport OpenAI z 14.10.2026: w UE Codex i ChatGPT Work to ponad połowa tokenów wyjściowych w próbie Enterprise, a MŚP zwiększyły liczbę użytkowników 8x. Jest też luka wobec światowej czołówki.