
Harness² od Google Research: popraw agenta bez zmiany modelu
Przejdź do treści i przykładów

Google Research stoi za Harness², projektem, który zamiast wymieniać model agenta na lepszy, poprawia wszystko wokół niego. W tekście Analytics Vidhya z 30.10.2026 autor zainstalował projekt i uruchomił demo. Liczby poniżej to deklaracje badaczy, a nie niezależny test.
Kiedy agent nie kończy zadania, odruch jest jeden: wziąć mocniejszy model. To normalny odruch, dopóki nikt nie pokaże Ci, że jest druga dźwignia. Bez technobełkotu: harness to wszystko, co otacza model. Instrukcje, narzędzia, pamięć i pętla, która pilnuje, co agent robi krok po kroku.
Według opisu Harness² żaden harness nie wygrywa wszędzie. Claude Code radzi sobie lepiej w kodowaniu i arkuszach, a Codex prowadzi w zadaniach webowych. Stały harness zostawia więc wynik na stole. Harness² ma się dostosowywać w trakcie testu, także do zadań, których jego twórcy nie przewidzieli. Podobny wątek rozwijamy w tekście o tym, że system wokół modelu decyduje o agencie AI.
Pomysł, żeby agent sam przepisywał swój prompt systemowy, wygląda rozsądnie, a w praktyce może pogorszyć wyniki. Prompt systemowy jest przetwarzany wielokrotnie w trakcie zadania. Im dłuższy, tym więcej tokenów zjada i tym mniej zostaje na właściwą pracę. Gdy budżet tokenów się kończy, agent może polec, zanim skończy.
Harness² udostępnia osiem edytowalnych komponentów. Większość z nich śpi, dopóki coś ich nie wyzwoli, więc nie obciążają budżetu tak, jak dopisany tekst w prompcie.
Najciekawsze jest rozróżnienie z opisu projektu: reguła w prompcie to rada, reguła w pętli sterowania jest egzekwowana. Prośba w prompcie to kartka „prosimy nie wchodzić”. Reguła w pętli to zamek w drzwiach.
Dwa przykłady poprawek, które agent sam sobie zbudował:
Taki bezpiecznik działa niezależnie od tego, czy model ma ochotę słuchać poleceń. Watchdog w roli strażnika pojawia się też w prototypie Super-agenta od DeepSeek, więc podobny wzorzec widać w więcej niż jednym projekcie.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Trudność polega na tym, że w prawdziwym zadaniu nie masz klucza odpowiedzi, więc nie wiesz, czy zmiana pomogła. Harness² radzi sobie z tym w trzech krokach:
Sygnałem są różnice między wykonaniami, a nie wynik względem znanej odpowiedzi. Krok probe nie jest ozdobą: bez niego wydajność spadła o około 10%. Ślepe zaufanie poprawkom agenta wypadło gorzej niż brak jakichkolwiek poprawek. Podobną logikę (najpierw sprawdź, potem ufaj) znajdziesz w testach E2E z agentem AI.
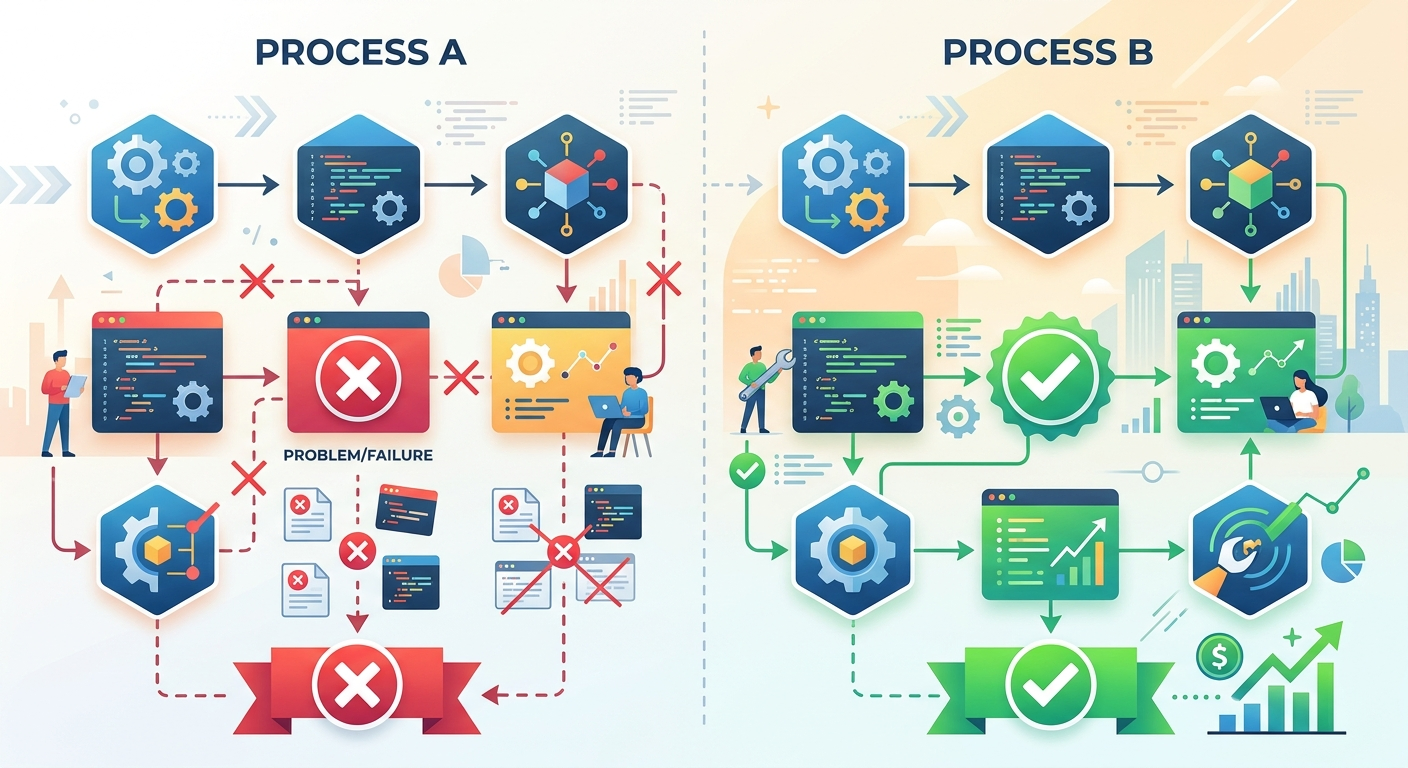
Badanie objęło trzy profesjonalne benchmarki i cztery konfiguracje model-harness, na GLM-5 i Gemini 3.5 Flash. Pojedynczy krok poprawił wynik względem bazowego harnessu w każdej z nich. Zgłoszone liczby:
Jest też wynik na minus. Metoda pamięci ReasoningBank wypadła w kodowaniu o 6,6 pkt gorzej niż bazowy harness, więc samo gromadzenie wspomnień agenta nie gwarantuje poprawy.
Autor Analytics Vidhya zainstalował projekt na Linuksie (Python 3.12, uv; projekt wymaga Pythona od 3.12 do poniżej 3.14) i uruchomił demo bez kluczy API. Dwa zadania księgowe zakończyły się bez błędów: 28 wykonań, 32 wywołania edytora, 2360 plików o łącznej wadze około 265 KB. Przebieg kosztował 6-8 pełnych przebiegów agenta przy k=2, czyli mieścił się w dolnej części zakresu 4-20 podawanego przez badaczy.
Autor ostrzega, że demo sprawdza instalację i przepływ, a nie metodę. Większość komponentów jest pusta albo jest atrapą (prompt systemowy ma 56 bajtów), a deterministyczne edytory nie tworzą prawdziwej treści, więc żaden harness nie jest realnie przepisywany. Żeby zobaczyć właściwą metodę, potrzebujesz modelu i prawdziwego benchmarku: Node.js 20+, Google Cloud CLI i poświadczeń Vertex AI. LAB wymaga dodatkowo Pandoc i Poppler, a WorkBuddy Dockera. Koszt w złotówkach zależy od modelu, więc sprawdzisz go w cenniku wybranego dostawcy.
Jeśli sam zdecydujesz się na test, autor radzi zacząć od --dry-run, który pokazuje wybór zadań bez wydawania pieniędzy, a potem od --max-tasks 1, bo każde zadanie odpala wiele wykonań. To nie magia, to system, i ten system ma rachunek za każdy przebieg. Wynik z benchmarku warto czytać razem z tym rachunkiem.
Jeśli nie programujesz, z tej historii wyniesiesz jedno: awarię trzeba opisać konkretnie, zanim zaczniesz szukać rozwiązania. Harness² też od tego startuje. Weź jedno zadanie, które AI ostatnio zepsuło (raport bez wniosków, arkusz z brakującymi formułami, odpowiedź urwana w połowie) i zapisz w jednym zdaniu, co dokładnie poszło nie tak, tak żeby dało się to sprawdzić okiem. Potem dopisz to do swojego promptu jako końcową kontrolę: „zanim uznasz zadanie za skończone, sprawdź X i pokaż mi wynik”. W zwykłym czacie to nadal prośba, a nie blokada, bo kod egzekwuje reguły dopiero w pętli agenta. Za to konkretna, widoczna awaria opisana wprost da Ci punkt odniesienia, czy kolejna poprawka cokolwiek zmieniła. Jeśli chcesz zobaczyć, jak inni składają agentów z narzędzi, zajrzyj do opisu DeepSeek Harness.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Agent AI napisze funkcję w kilka sekund, ale o tym, czy praca jest skończona, decyduje system wokół modelu. Co to harness, jak wygląda pętla agenta i co pokazuje demo z Analytics Vidhya.
DeepSeek Harness opublikował prototyp Super-agenta na licencji MIT: Router rozdziela zadania, izolowane sesje Worker poprawiają błędy i otwierają PR. To kod badawczy.
DeepSeek Harness v0.2.2-alpha.2 ma eksperymentalne narzędzie subagent_oar: główny agent oddaje zadanie lokalnemu Codex CLI lub Claude Code. Sprawdź, jakie są ograniczenia.
DS Bot to nieoficjalna wtyczka open source do DeepSeek Harness. Każdy bot ma własną rolę, model i pamięć, a czat grupowy obsługuje bot-administrator. Dane zostają lokalnie.
DeepSeek wypuścił Harness v0.2 preview: instalatory na macOS i Windows, menedżer wtyczek bez wiersza poleceń oraz zadania cykliczne. Co to daje osobie, która nie koduje?
Parallel Web Systems pokazuje, że research rynku pracy da się zrobić w połowie czasu i za połowę kosztu dzięki GPT-6 Astra. Bez utraty jakości.