
Jak zbudować i wdrożyć system RAG krok po kroku
Przejdź do treści i przykładów

Duże modele językowe mają jeden problem: wiedzą tylko tyle, ile zapamiętały podczas treningu. Zapytaj ChatGPT albo Claude o dane z Twojej firmy - model ich po prostu nie zna. Zapytaj o dokument, który właśnie dostałeś mailem - cisza. Model nie ma dostępu do Twoich plików, baz danych ani świeżych informacji.
Aktualizacja 13.10.2026: nowe modele, ceny i narzędzia, plan wdrożenia, wybór bazy i modeli, przygotowanie strony pod wyszukiwarki AI oraz treści z naszych starszych poradników o wdrażaniu RAG. Usunęliśmy liczby bez źródła i porzucone narzędzia.
Retrieval Augmented Generation (RAG) rozwiązuje ten problem. Zamiast polegać wyłącznie na pamięci modelu, RAG najpierw wyszukuje potrzebne informacje z zewnętrznych źródeł, a potem przekazuje je modelowi jako kontekst. Efekt? Model odpowiada na podstawie Twoich danych, nie ogólnej wiedzy z internetu.
W tym przewodniku pokażę Ci, jak działa system RAG, jak go wdrożyć krok po kroku i którą drogę wybrać: gotowe narzędzie, low-code czy własny kod. Sam mechanizm i skrót wyjaśnia tekst RAG po polsku - jak działa.
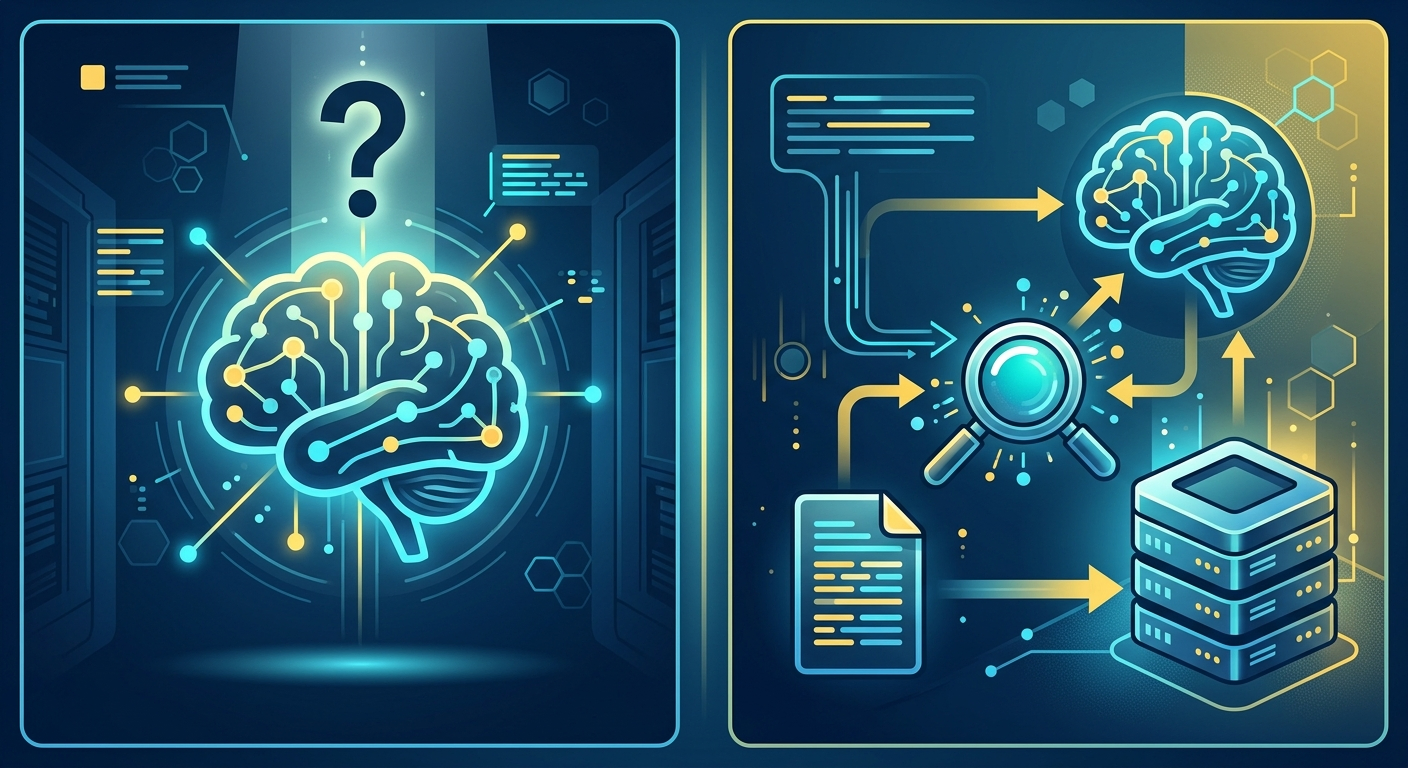
RAG to skrót od Retrieval Augmented Generation. Rozbijmy to na czynniki pierwsze.
Retrieval (wyszukiwanie) - system przeszukuje Twoje dokumenty, bazy danych lub inne źródła i znajduje fragmenty najbardziej pasujące do pytania.
Augmented (wzbogacone) - znalezione informacje trafiają do modelu jako dodatkowy kontekst, wzbogacając jego wiedzę.
Generation (generowanie) - model tworzy odpowiedź na podstawie zarówno swojej wiedzy, jak i dostarczonych danych.
Przykład z życia: masz 500 stron dokumentacji technicznej swojego produktu. Klient pyta o konkretną funkcję. Zamiast przeszukiwać ręcznie wszystkie pliki, system RAG:
Różnica między zwykłym LLM a RAG? Zwykły model odpowiada: "Nie mam dostępu do dokumentacji Twojego produktu". RAG odpowiada: "Według dokumentacji z sekcji 3.2, ta funkcja działa następująco..."
RAG nie jest uniwersalnym rozwiązaniem. Ma sens, gdy:
RAG to przesada, gdy:
Jeśli Twoje pytanie można rozwiązać prostym wyszukiwaniem Ctrl+F, RAG prawdopodobnie nie jest Ci potrzebny. Jeśli masz setki plików i potrzebujesz inteligentnej syntezy informacji - to właśnie to narzędzie.
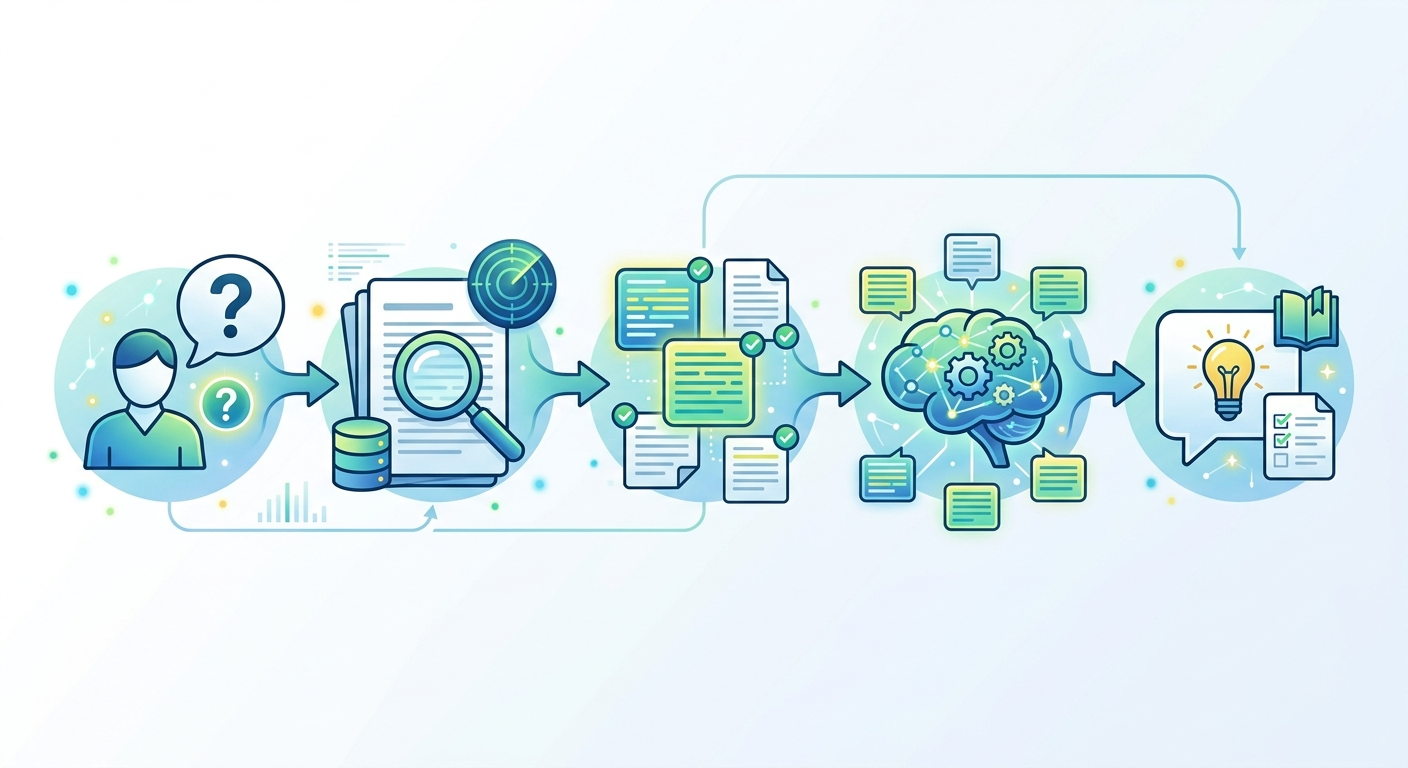
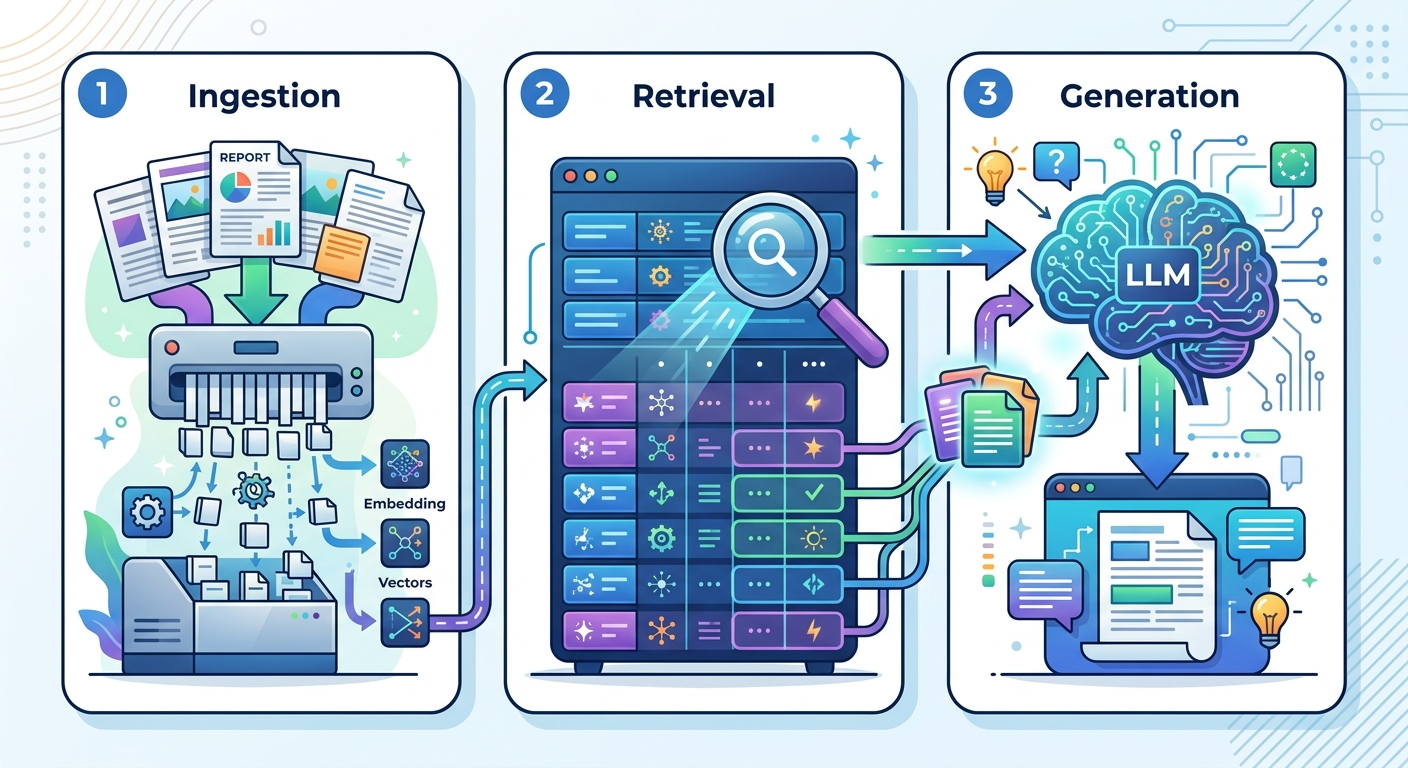
System RAG składa się z trzech głównych elementów. Nie musisz ich programować samodzielnie (istnieją gotowe narzędzia), ale warto rozumieć, co się dzieje w środku.
Najpierw system musi przygotować dokumenty:
Gdy zadajesz pytanie, system:
To nie jest wyszukiwanie słów kluczowych. Jeśli zapytasz "jak naprawić błąd połączenia", system znajdzie fragmenty o "problemach z siecią" - nawet jeśli nie zawierają tych słów.
Znalezione fragmenty trafiają do dużego modelu językowego jako kontekst. Prompt wygląda mniej więcej tak:
"Odpowiedz na pytanie użytkownika na podstawie poniższych fragmentów dokumentacji. Jeśli informacji nie ma w kontekście, powiedz to wprost. Cytuj źródła.
Kontekst: [fragment 1], [fragment 2], [fragment 3]
Pytanie: Jak naprawić błąd połączenia?"
Model analizuje kontekst i generuje odpowiedź. Jeśli system jest dobrze skonfigurowany, doda też źródła ("według sekcji 4.2...").
Masz produkt SaaS i 200 stron dokumentacji, a klienci zadają te same pytania: "jak skonfigurować integrację", "gdzie znaleźć API key", "dlaczego nie działa webhook". Gdy klient pyta: "Jak dodać użytkownika do zespołu?", chatbot RAG z wgraną dokumentacją znajduje właściwy fragment i odpowiada: "Przejdź do Settings → Team → Add Member. Szczegóły w sekcji 2.3". Powtarzalne pytania obsługuje chatbot, a zespół wsparcia zajmuje się trudniejszymi przypadkami. Jeśli odpowiedzi nie ma w dokumentacji, chatbot powinien przekazać sprawę człowiekowi, zamiast zgadywać.
Prawnik dostaje 50-stronicową umowę i pyta system: "Jakie są warunki wypowiedzenia umowy?", "Czy jest klauzula arbitrażowa?", "Kto ponosi koszty w przypadku sporu?". System znajduje odpowiednie paragrafy i cytuje je dosłownie. Prawnik nadal weryfikuje odpowiedzi, bo AI może się mylić, ale zamiast czytać całość, przegląda wskazane fragmenty.
Dokumenty leżą w Google Drive, Confluence, Notion, Slacku i mailach, a nowy pracownik pyta: "Jak wygląda proces onboardingu klienta?". Chatbot RAG przeszukuje wszystkie źródła naraz i odpowiada z linkami do oryginalnych dokumentów. Tak działa m.in. Glean, który ma ponad 275 gotowych połączeń z aplikacjami firmowymi i przenosi z nich uprawnienia do dokumentów.
Zanim wybierzesz narzędzie, ustal, co ma działać i jak to sprawdzisz:
Nie musisz być programistą, żeby zbudować prosty system RAG. Oto trzy ścieżki - od najprostszej do bardziej zaawansowanej.
Jeśli chcesz przetestować RAG bez pisania kodu, użyj gotowych platform:
Zacznij od ChatGPT lub Claude. Wgraj 5-10 dokumentów i zadaj kilka pytań. Zobaczysz, jak działa wyszukiwanie i generowanie odpowiedzi.
Jeśli potrzebujesz więcej kontroli, ale nadal bez kodowania:
Uwaga na starsze poradniki: Flowise zarchiwizowano, a jego wsparcie skończyło się 31.08.2026 - nie zaczynaj na nim nowego projektu. PrivateGPT nie uruchamia już modeli sam, tylko łączy się z osobnym serwerem modeli, np. Ollama.
Jeśli znasz podstawy Pythona (lub chcesz się nauczyć), możesz zbudować RAG od zera:
Kod ze starszych poradników często już nie działa: pinecone.init() usunięto w bibliotece Pinecone 3.0.0, RetrievalQA i moduły langchain.vectorstores czy langchain.document_loaders przeniesiono do langchain-classic, a langchain-community wygaszono w maju 2026. Sprawdzaj przykłady z aktualną dokumentacją.
Zasadę działania takiej bazy wyjaśnia przewodnik jak działa baza wektorowa.
Model embeddingów decyduje, czy wyszukiwanie znajdzie właściwy fragment. Do polskich tekstów wybierz taki, który zna polski - darmowe przykłady (MMLW, multilingual-e5-large, BGE-M3) opisujemy w tekście RAG po polsku. Płatne: OpenAI text-embedding-3-small (0,02 USD za milion tokenów), text-embedding-3-large (0,13 USD) albo rodzina voyage-4 (0,02-0,12 USD). Zmiana modelu oznacza ponowne zaindeksowanie bazy.
Do odpowiedzi z kilku fragmentów często wystarczy tańszy model - sprawdź to na zestawie testowym. Ceny API za milion tokenów wejścia/wyjścia (stan na 13.10.2026): Claude Sonnet 5.5 - 2/10 USD, Claude Haiku 5.5 - 0,10/0,50 USD (prompty do 100 tys. tokenów), GPT-6.1 Sol - 2/10 USD, GPT-6 Luna - 0,10/0,50 USD, Gemini 3.8 Flash - 0,75/3,75 USD do końca 2026 roku (potem 1,50/7,50 USD), DeepSeek V4.1 Flash - 0,15/0,60 USD poza godzinami szczytu (w szczycie dwa razy więcej). Gdy dane nie mogą opuścić firmy - model z otwartymi wagami (np. z rodziny Llama 4 albo Qwen 3) uruchomiony lokalnie przez Ollama.
Jeśli dopiero zaczynasz, polecam naukę podstaw AI przed skokiem na głęboką wodę. RAG to zaawansowana technika - najpierw opanuj prompt engineering i automatyzację prostych zadań.
To pytanie ma dwa znaczenia: dokumenty do własnego systemu RAG i strona WWW, którą mają znaleźć i cytować wyszukiwarki AI (ChatGPT, Perplexity, Google).
Dokumenty do własnego RAG: jeden temat na sekcję i czytelne nagłówki (fragment o jednej sprawie łatwiej znaleźć), tekst zamiast skanów, data i wersja w każdym dokumencie, żadnych starych wersji obok nowych, częste pytania jako pary pytanie-odpowiedź.
Strona WWW pod wyszukiwarki AI:
Jak działają same wyszukiwarki AI, opisujemy w tekście o Google, Perplexity i SearchGPT.
RAG brzmi prosto w teorii, ale w praktyce można się natknąć na kilka problemów. Oto najczęstsze i jak je obejść.
Jeśli Twoje dokumenty są chaotyczne, nieaktualne lub pełne błędów, RAG będzie generować takie same odpowiedzi. System nie weryfikuje prawdziwości - tylko wyszukuje i cytuje.
Rozwiązanie: Zanim wgrasz dane do systemu, uporządkuj je. Usuń zduplikowane pliki, zaktualizuj przestarzałe informacje, ujednolicaj formatowanie. To nudna robota, ale krytyczna dla jakości odpowiedzi.
Jeśli podzielisz dokumenty na zbyt małe fragmenty (np. 50 słów), stracisz kontekst. Jeśli na zbyt duże (np. 2000 słów), wyszukiwanie będzie nieprecyzyjne.
Rozwiązanie: Eksperymentuj z wielkością chunków. Punkt wyjścia daje samouczek LangChain: fragmenty po 1000 znaków (ok. 150 słów) nachodzące na siebie o 200 znaków. Potem sprawdzaj na zestawie testowym, czy większe albo mniejsze fragmenty dają lepsze wyniki. Dokumenty o wyraźnej strukturze, jak regulamin czy instrukcja, dziel po sekcjach, a nie po liczbie słów.
Nawet z dobrym kontekstem, model czasem wymyśla fakty. Dlaczego? Bo został wytrenowany do generowania płynnego tekstu, nie weryfikowania prawdy.
Rozwiązanie: Dodaj do promptu instrukcję: "Odpowiadaj TYLKO na podstawie dostarczonych fragmentów. Jeśli informacji nie ma w kontekście, powiedz: 'Nie znalazłem tej informacji w dokumentacji'". To nie wyeliminuje halucynacji w 100%, ale znacznie je ograniczy.
Każde pytanie to tysiące tokenów: instrukcja, pytanie i fragmenty. Przy drogim modelu i dużym ruchu rachunek rośnie szybko.
Rozwiązanie: Policz koszt na swoim przypadku. Pytanie z pięcioma fragmentami to ok. 3000 tokenów wejścia i 500 tokenów odpowiedzi: na Claude Sonnet 5.5 wychodzi ok. 11 USD za 1000 pytań, na Claude Haiku 5.5 ok. 0,55 USD (bez tokenów rozumowania). Indeksowanie jest tanie (milion tokenów w text-embedding-3-small to 0,02 USD), a lokalne embeddingi open source w ogóle nie wymagają API OpenAI. Pomaga też cache dla powtarzalnych pytań.
Wyszukiwanie po znaczeniu radzi sobie z synonimami, ale potrafi minąć się z dokładnym ciągiem znaków, np. „art. 15 ust. 3” albo kodem produktu.
Rozwiązanie: wyszukiwanie hybrydowe (wektory plus wyszukiwanie po słowach BM25), wbudowane m.in. w Weaviate i Qdrant, a do tego reranking: osobny model (np. Cohere Rerank 4 za 2-2,50 USD za 1000 wyszukiwań albo Voyage rerank-3) wybiera z kilkunastu kandydatów kilka najlepszych.
Zależy od skali. Prosty system RAG dla 100-1000 dokumentów możesz uruchomić na laptopie lub tanim serwerze w chmurze. Dla milionów dokumentów i tysięcy użytkowników potrzebujesz dedykowanej infrastruktury i zespołu technicznego. Większość małych i średnich firm spokojnie zmieści się w pierwszym scenariuszu - albo użyje gotowych narzędzi SaaS, które skalują się automatycznie.
To dwa różne podejścia do tego samego problemu. Fine-tuning uczy model nowych wzorców (np. stylu pisania, specjalistycznej terminologii), ale nie dodaje nowych faktów - model nadal nie będzie znał Twoich dokumentów. RAG nie zmienia modelu, tylko dostarcza mu kontekst w czasie rzeczywistym. Często łączy się oba - fine-tuning dla stylu i domeny, RAG dla aktualnych danych.
Tak, ale z ostrożnością. Jeśli używasz API zewnętrznych dostawców (OpenAI, Anthropic), Twoje dane przechodzą przez ich serwery - sprawdź w umowie i dokumentacji, czy mogą służyć do trenowania modeli i gdzie są przetwarzane (RODO). Alternatywa: modele z otwartymi wagami na własnej infrastrukturze - wtedy dane nie opuszczają Twojego serwera. Pilnuj też uprawnień: jeśli ktoś nie powinien widzieć danego pliku, system musi odfiltrować jego fragmenty, zanim trafią do modelu - narzędzia typu Glean przenoszą uprawnienia z podłączonych systemów, we własnym systemie trzeba to zaprogramować.
Najszybciej sprawdzisz pomysł na gotowym narzędziu - wgrywasz pliki i od razu pytasz. Platforma low-code wymaga zbudowania i przetestowania przepływu, a system produkcyjny z własnym kodem - także infrastruktury, monitoringu i uprawnień. W każdym wariancie najwięcej pracy pochłania zwykle przygotowanie dokumentów i testowanie odpowiedzi, a nie sama technologia.
Tak, ale najpierw zamień je na tekst: nagrania przez transkrypcję, strony przez pobranie treści, maile przez eksport. Potem indeksujesz je jak zwykłe dokumenty. Niektóre narzędzia robią to same - Chatbase przyjmuje adresy stron, a Notion AI i Glean łączą się z firmowymi aplikacjami.
Nie całkowicie. Tradycyjne wyszukiwarki (Elasticsearch, Algolia) są szybsze i tańsze dla prostych zapytań ("znajdź wszystkie faktury z marca"). RAG ma sens, gdy potrzebujesz syntezy informacji z wielu źródeł ("podsumuj kluczowe ryzyka z umów z Q1"). W praktyce firmy często łączą oba - wyszukiwarka do filtrowania, RAG do generowania odpowiedzi.
Ten poradnik to dopiero początek. W naszym kursie AI Evolution nauczysz się korzystać z ChatGPT, Claude i innych narzędzi AI w sposób systematyczny - od zera do zaawansowanego poziomu.
Sprawdź kurs →RAG to konkretna technologia łącząca wyszukiwanie z generowaniem AI. Działa świetnie dla dokumentacji, obsługi klienta, analizy danych i wewnętrznych wyszukiwarek. Ma sens tam, gdzie masz dużo dokumentów i potrzebujesz inteligentnej syntezy informacji.
Załóż projekt w ChatGPT (działa także w darmowym planie) albo w Claude. Wgraj 3-5 dokumentów z Twojej pracy (raporty, procedury, notatki). Zadaj 10 pytań, na które normalnie musiałbyś przeszukiwać te pliki ręcznie. Sprawdź, jak system radzi sobie z wyszukiwaniem i generowaniem odpowiedzi. To zajmie Ci 15 minut i pokaże, czy RAG ma sens w Twoim przypadku - jeśli tak, przejdź do planu wdrożenia opisanego wyżej.
Na podstawie: SukcesAI Course Material Generator, OpenAI - projekty w ChatGPT, Anthropic - RAG w projektach Claude, Anthropic - okno kontekstowe w planach płatnych, Notion - wyszukiwanie AI, Glean - połączenia z aplikacjami, n8n - Qdrant Vector Store, Dify - baza wiedzy, Flowise - zakończenie projektu, LangChain - migracja do wersji 1, Pinecone - limity planu Starter, Qdrant - wyszukiwanie hybrydowe, OpenAI - cennik API, Voyage AI - cennik, Cohere - cennik, Anthropic - modele i ceny API, Google - cennik Gemini API, DeepSeek - cennik API, OpenAI - roboty OAI-SearchBot i GPTBot, Perplexity - roboty, Google - funkcje AI w wyszukiwarce a Twoja strona
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Chcesz uruchomić chatbota AI bez programowania? Zobacz, jak wybrać narzędzie, dodać wiedzę, ustawić odpowiedzi i wdrożyć bota na stronie.
Poznaj krok po kroku, jak stworzyć agenta AI łączącego wyszukiwanie, pobieranie danych i pamięć konwersacji - bez wiedzy programistycznej.

RAG po polsku wyjaśniony bez żargonu: jak działa, czym różni się od fine-tuningu i jak zbudować własny mini-system na darmowych narzędziach.
Podział dokumentów na fragmenty to fundament skutecznego RAG. Dowiedz się, jak to zrobić praktycznie - od wyboru strategii po testowanie wyników.
Platformy, integracje i najlepsze praktyki wdrożenia chatbotów AI nowej generacji. Przewodnik dla firm, które chcą zautomatyzować obsługę bez utraty jakości kontaktu.
RAG miał wyeliminować halucynacje AI. Problem w tym, że system może cytować oficjalne źródła i nadal udzielić odpowiedzi, która jest prawdziwa, dobrze udokumentowana - i kompletnie nietrafiona.