
Testy E2E z agentem AI: błędy łapiesz, zanim zobaczy je klient
Przejdź do treści i przykładów

31 października 2026 Towards Data Science opublikowało poradnik o testach end-to-end, w których agent AI klika po aplikacji tak, jak zrobiłby to użytkownik. Autor twierdzi, że to, co dawniej było żmudną ręczną robotą, dziś da się zlecić jednym promptem. Tekst jest dla każdego, kto buduje aplikację z Claude Code lub Codex, także gdy kod pisze za niego agent. Poniżej opisuję, co autor deklaruje i jak wygląda to krok po kroku. Liczb ani wyników pomiarów w poradniku nie ma, więc to relacja z podejścia, nie z testu.
Test end-to-end (w skrócie E2E) sprawdza gotową aplikację, a nie pojedyncze fragmenty kodu. Agent widzi ekran, decyduje, w który przycisk kliknąć, klika i patrzy, co pojawiło się na następnej stronie. Potem zgłasza problem: błąd po kliknięciu, przycisk, który nic nie robi, albo sytuację, w której oczekiwana akcja po prostu się nie wydarzyła.
Autor uzasadnia to prosto. Agenci kodujący świetnie piszą kod, ale zdarza im się coś przeoczyć albo napisać zawiły kod z nieoczekiwanymi skutkami ubocznymi. Test E2E nie interesuje się tym, jaki kod uruchomiono. Patrzy na końcowy produkt, taki, jaki widzi użytkownik.
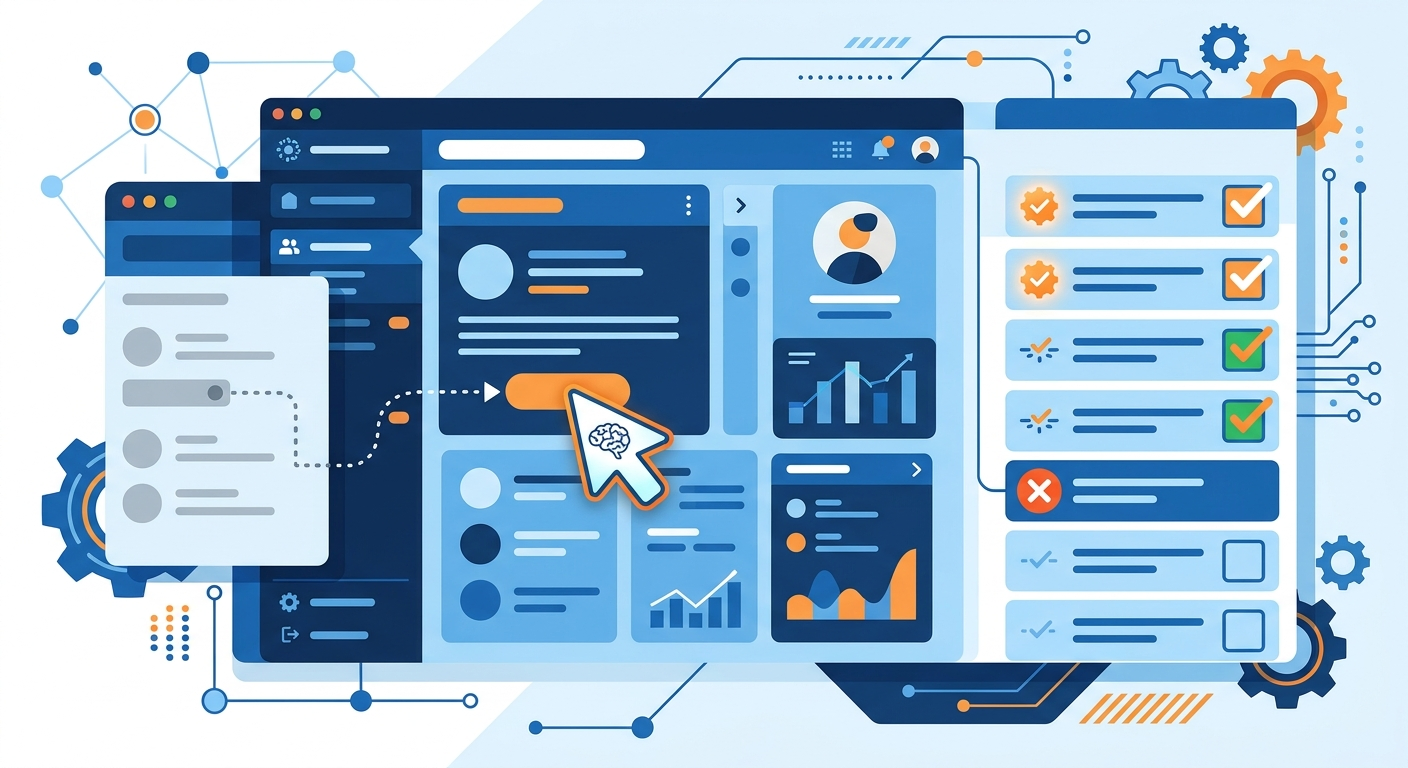
Według autora trzeba je było tworzyć ręcznie. Przechodziłeś przez każdą stronę, podawałeś testowi identyfikator przycisku do kliknięcia i zapisywałeś, co ma się stać po kliknięciu. Już na starcie była to żmudna robota.
Gorsza była konserwacja. Zmieniasz wygląd strony albo jakąś logikę, a testy trzeba poprawiać. Autor nazywa to dość poważnym kosztem utrzymania, który ciągnie się przez cały czas życia testu. Mój komentarz: test, któremu sam wskazujesz każdy przycisk, to ankieta, w której sam wpisujesz odpowiedzi respondentom. Znajdzie tylko te błędy, które już przewidziałeś.
Dziś, jak opisuje autor, test E2E to agent z dostępem do przeglądarki (albo komputera) i planem działania. Na przykład: dojdź do strony A, wykonaj akcję B, oczekiwany wynik to C. Agenta nie trzeba aktualizować po zmianie wyglądu strony, o ile przycisk nadal na niej jest. Autor dodaje, że takie testy są bardziej ogólne, więc wykrywają problemy, których wąskie dawne testy nie łapały, i łatwo ich stworzyć więcej.
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Agent musi mieć dostęp do przeglądarki. Autor podaje jako przykład Playwright MCP, czyli narzędzie, które pozwala agentowi sterować wybraną przeglądarką. Pisze, że u niego działa bardzo dobrze i nie wracał do innych rozwiązań, ale dopuszcza, że istnieją skuteczniejsze, których nie próbował.
Potem prosisz agenta, żeby przygotował test dla konkretnej ścieżki. Przykład z poradnika to strona przeglądu zespołu:
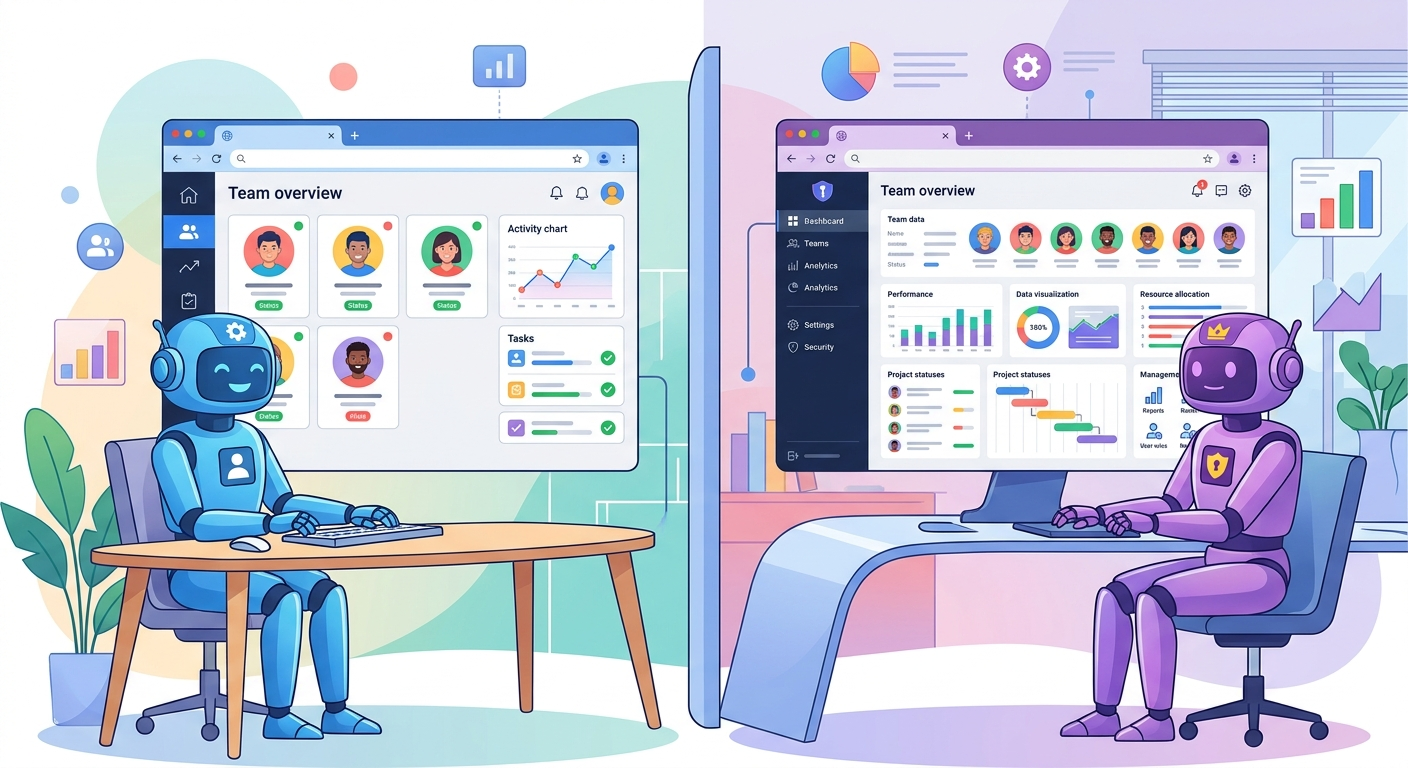
Agent testowy dostaje zwykle te same uprawnienia i reguły co prawdziwy użytkownik. Zwykłego użytkownika i admina reprezentują więc dwaj osobni agenci, a całość konfiguruje jeden prompt. To nie magia, tylko system: opis oczekiwanego zachowania zamiast listy identyfikatorów.
Przy pierwszym podejściu autor radzi uruchamiać testy na serwerze, który się nie wywala. Może to być osobna maszyna w chmurze, GitHub Actions runner albo Mac mini stojący gdzieś w kącie. Sposób uruchamiania, np. natywny harmonogram Maca albo zadania cykliczne (Cron jobs) w Vercelu, według autora wybierze za Ciebie agent kodujący, na przykład Claude lub Codex.
Autor wymienia dwa momenty i sam używa obu:
To drugie ma sens z prostego powodu: aplikacja potrafi się zepsuć, mimo że nikt nie ruszył ani linijki kodu. Gdy agent pisze za Ciebie dużą część programu, dobrze mieć kogoś, kto sprawdza efekt. Podobny wątek, czyli system wokół modelu, który decyduje o jakości pracy agenta, rozwijamy w tekście o harness engineering. A jeśli korzystasz z kilku agentów naraz, zobacz, jak DeepSeek Harness zleca zadania Codex i Claude Code.
Autor zachęca, by wdrożyć testy E2E dla wszystkich funkcji i stron, bo są jego zdaniem relatywnie tanie w uruchamianiu i pomagają mu odkrywać wiele problemów. To opinia, bez liczb. Realny koszt zobaczysz w cenniku narzędzi, z których korzystasz (Claude Code, Codex, Playwright MCP), i w dokumentacji ich dostawców. Pamiętaj też, że agent z dostępem do przeglądarki to agent z uprawnieniami, więc dawaj mu te same prawa co zwykłemu użytkownikowi, nie więcej. O tym, jak łatwo zaufanie do agenta bywa wykorzystane, przeczytasz w historii o tym, jak AGENTS.md w Download nakłonił Codex i Claude Code do malware. Jeśli dopiero uczysz się pracy z Claude Code, zerknij na kurs Claude Code i koszt planu Pro.
Według autora ręczne wypisywanie przycisków i oczekiwanych wyników przestaje być potrzebne, bo ścieżkę możesz opisać zwykłym językiem. Weź swoją aplikację, stronę albo formularz i zapisz w notatniku trzy najważniejsze ścieżki użytkownika według schematu: strona A, akcja B, oczekiwany wynik C (osobno dla zwykłego użytkownika i, jeśli jest, admina). Dostaniesz gotowy materiał na prompt dla agenta testowego.
Na podstawie: Towards Data Science
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
DeepSeek Harness v0.2.2-alpha.2 ma eksperymentalne narzędzie subagent_oar: główny agent oddaje zadanie lokalnemu Codex CLI lub Claude Code. Sprawdź, jakie są ograniczenia.
Forever Security odtworzyła atak: plik AGENTS.md w folderze Download skłonił Codex i Claude Code do instalacji złośliwego pakietu. Co sprawdzić u siebie.
Analytics Vidhya opisuje budowę ResolveAI: platformy do eskalacji skarg klientów z bramką menedżera dla dużych zwrotów, stworzonej przez Claude Fable 5.1 w Claude Code.
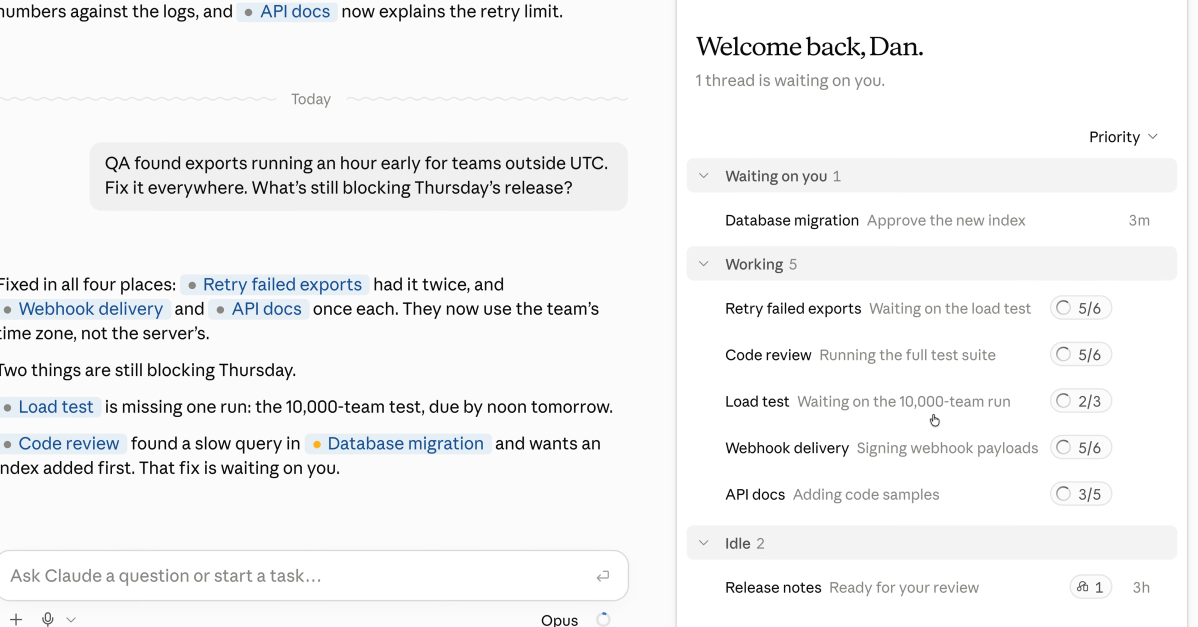
Anthropic odświeża Projects w Claude Code - teraz jeden koordynator zarządza wieloma agentami pracującymi równolegle nad tym samym kodem.

Chińskie laboratorium AI rekrutuje do nowego zespołu w Pekinie. Cel? Zbudować narzędzie kodujące, które zmierzy się z Claude Code od Anthropic.
Gemini Enterprise Agent Platform dostaje Agent Anomaly Detection - warstwę nadzoru, która wyłapuje ryzykowne zachowania agentów bez spowalniania ich pracy.