
Algorytm BERT - co to jest i jak działa model Google
Przejdź do treści i przykładów

BERT (Bidirectional Encoder Representations from Transformers) to model językowy, który Google opublikowało w październiku 2018 roku. Zbudowany jest z samego enkodera transformera i czyta zdanie w obie strony naraz: żeby zrozumieć słowo, bierze pod uwagę słowa przed nim i po nim. Uczył się na dwóch zadaniach - zgadywaniu zamaskowanych słów i ocenianiu, czy jedno zdanie następuje po drugim. BERT nie pisze tekstów jak ChatGPT, tylko je rozumie: klasyfikuje, znajduje odpowiedź w podanym fragmencie, rozpoznaje nazwy. W 2019 roku Google zaczęło używać BERT w wyszukiwarce - stąd określenie „algorytm BERT”.
Aktualizacja 13.10.2026: dopisaliśmy, czym jest algorytm BERT w Google, uzupełniliśmy dane techniczne (rozmiary modelu, zadania treningowe), poprawiliśmy zdania sugerujące, że BERT wprowadził transformery i atencję, zaktualizowaliśmy przykłady modeli do stanu na 13.10.2026 i usunęliśmy opis klikalnych diagramów, których we wpisie Alammara nie ma. Jeśli transformery to dla Ciebie nowość, zacznij od przewodnika po transformerach dla nietechnicznej osoby.
Przystępne, obrazkowe wyjaśnienie BERT napisał Jay Alammar we wpisie „The Illustrated BERT, ELMo, and co.” z grudnia 2018 roku. Nie przez równania, tylko przez rysunki. W tym przewodniku pokażę Ci, jak korzystać z jego materiałów - nawet jeśli nigdy nie widziałeś linii kodu - i dlaczego warto zrozumieć BERT, nawet jeśli na co dzień używasz tylko czatu.
Przykład dwukierunkowego czytania: w zdaniu „Zgubiłem klucz do mieszkania” słowo „klucz” oznacza przedmiot do zamka. W zdaniu „Nad jeziorem przeleciał klucz żurawi” - stado ptaków. BERT rozróżnia te znaczenia, bo przy każdym słowie bierze pod uwagę całe zdanie, z obu stron.
Google opisało dwie wielkości modelu: BERT-base (12 warstw, 12 głów atencji, 110 mln parametrów) i BERT-large (24 warstwy, 16 głów, 340 mln parametrów). Model przyjmuje do 512 tokenów naraz, a trenowano go na zbiorze książek BooksCorpus (800 mln słów) i angielskiej Wikipedii (2,5 mld słów).
BERT nie jest dziś najnowszym modelem - na 13.10.2026 czołowe modele czatowe to m.in. rodzina GPT-6 od OpenAI, Claude Opus 5.5 i Fable 5.1 od Anthropic czy Gemini 3.1 Pro od Google. BERT i jego następcy wciąż jednak pracują tam, gdzie tekst trzeba szybko zrozumieć, a nie napisać: w klasyfikacji i wyszukiwaniu. Sam model bert-base-uncased pobrano z Hugging Face ponad 34 mln razy w ostatnich 30 dniach (odczyt 13.10.2026).
Jedno sprostowanie, bo to częsty skrót myślowy: BERT nie wymyślił transformera ani mechanizmu atencji. Transformer opisano w 2017 roku, a wstępne trenowanie modeli językowych i ich dostrajanie rozwijały wcześniej m.in. ELMo, ULMFiT i pierwsze GPT od OpenAI - Alammar omawia je w swoim wpisie. Nowością BERT było głęboko dwukierunkowe uczenie przez maskowanie słów.
25 października 2019 roku Google ogłosiło, że używa modeli BERT w wyszukiwarce: do układania wyników i do wyróżnionych fragmentów z odpowiedzią (featured snippets). Przy układaniu wyników BERT miał na start pomóc lepiej zrozumieć co dziesiąte zapytanie po angielsku w USA, z zapowiedzią kolejnych języków.
Przykład Google: w zapytaniu „2019 brazil traveler to usa need a visa” kluczowe jest słówko „to” - chodzi o Brazylijczyka jadącego do USA, a nie odwrotnie. Wcześniej wyszukiwarka pokazywała wyniki o Amerykanach jadących do Brazylii. Google przyznało przy tym, że BERT nie zawsze trafia.
BERT nadal figuruje w przewodniku Google Search Central po systemach rankingowych - jako system AI, który pomaga zrozumieć, jak kombinacje słów wyrażają różne znaczenia i intencje (odczyt 13.10.2026). Jak wyszukiwanie z AI wygląda dziś, opisujemy w tekście Google SGE, Perplexity, SearchGPT: jak działa wyszukiwanie AI.
Transfer learning to technika, która zmieniła przetwarzanie języka naturalnego. Zamiast uczyć model od zera na każdym nowym zadaniu, bierzesz model już wytrenowany na ogromnym zbiorze tekstów - i dostosowujesz go do swojego problemu.
Jeśli znasz włoski, nauka hiszpańskiego nie zaczyna się od zera - przenosisz wiedzę o gramatyce, słownictwie, budowie zdań. Transfer learning działa podobnie.
BERT nie był pierwszy, ale ten schemat spopularyzował: tuż po publikacji pracy Google udostępniło kod i gotowe, wstępnie wytrenowane modele, więc każdy mógł dostroić BERT do swojego zadania - klasyfikacji tekstu, odpowiadania na pytania, analizy sentymentu.
Alammar pokazuje, jak to wygląda krok po kroku:
Dziś ten schemat jest standardem także dla czatów. Anthropic opisuje w słowniczku, że model bazowy Claude jest najpierw trenowany na przewidywanie kolejnego słowa, a potem douczany, m.in. metodą RLHF, żeby wykonywał polecenia. Różni je skala: BERT-large miał 340 mln parametrów, GPT-3 z 2020 roku - 175 mld, a DeepSeek V4 Pro (2026) - 1,6 bln, z czego przy każdym tokenie pracuje 49 mld. Liczby parametrów najnowszych modeli OpenAI i Anthropic nie są publiczne.
Jeśli chcesz zrozumieć, jak zrobić fine-tuning modelu AI, warto zacząć od BERT - na nim ten proces widać najwyraźniej.
Materiały Alammara to nie podręcznik do przeczytania od deski do deski. To zestaw rysunków, do których wracasz, gdy chcesz zrozumieć konkretny mechanizm.
Oto jak z nich korzystać, jeśli dopiero zaczynasz:
Zanim przejdziesz do BERT, przeczytaj wpis Alammara o transformerach - sam odsyła do niego we wpisie o BERT. Transformer to architektura, na której opiera się i BERT, i dzisiejsze czaty.
Zobaczysz w nim, jak działa mechanizm attention - czyli jak model „zwraca uwagę” na różne słowa w zdaniu, żeby zrozumieć kontekst. Nie musisz rozumieć równań. Wystarczy, że prześledzisz na diagramach, jak dane przepływają przez model.
Gdy już wiesz, czym jest transformer, przeczytaj wpis o BERT. Alammar pokazuje, że BERT to w gruncie rzeczy stos enkoderów transformera, i wyjaśnia, jak model uczy się czytać tekst w obie strony.
Kluczowy fragment: sekcja Masked Language Model. Model dostaje tekst, w którym 15% tokenów wybrano do odgadnięcia - większość z nich zastąpiono znacznikiem [MASK], część losowym słowem, część zostawiono bez zmian - i musi odtworzyć oryginał. Drugie zadanie to ocena, czy zdanie B następuje po zdaniu A (w połowie przykładów tak, w połowie B jest losowe). Nauka języka przez uzupełnianie luk w tekście - tylko na gigantyczną skalę.
Jeśli chcesz zobaczyć, jak dostosować model językowy z maskowaniem, ten wpis Alammara to najlepszy punkt startu.
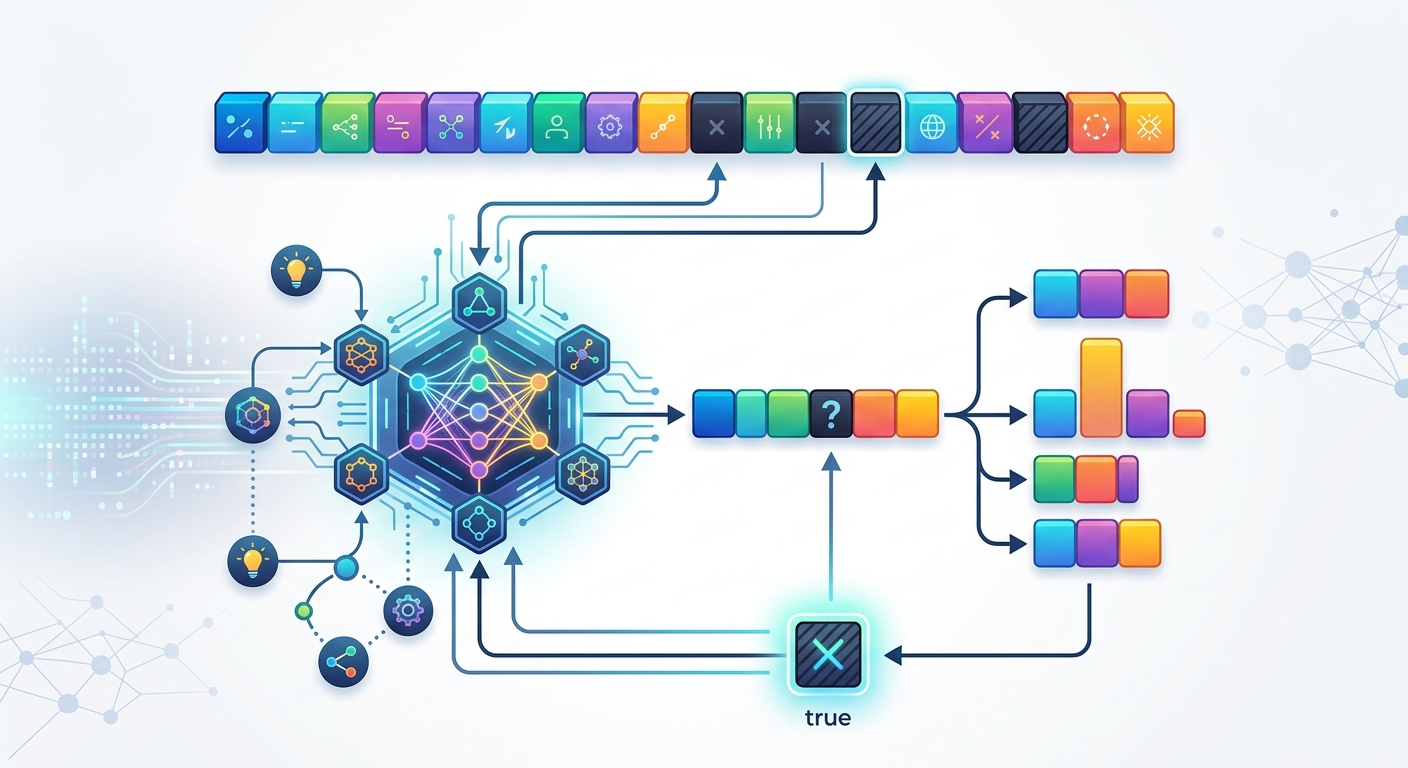
Wpis o BERT składa się ze statycznych ilustracji - klikalnych diagramów w nim nie ma. Interaktywne przykłady Alammar przygotował w innym tekście, „Interfaces for Explaining Transformer Language Models”: najeżdżasz kursorem na słowa wygenerowane przez model i widzisz, które słowa wejścia miały na nie największy wpływ.
Jeśli znasz podstawy Pythona, na końcu wpisu o BERT znajdziesz odnośnik do notatnika Google Colab z dostrajaniem BERT, a Alammar ma też osobny poradnik „A Visual Guide to Using BERT for the First Time”.
Gdy już rozumiesz mechanizmy, czas na praktykę. Nie musisz programować. Możesz:
Jeśli chcesz zobaczyć, jak pisać prompty do ChatGPT, żeby działały, wiedza o tym, jak model przetwarza kontekst, daje Ci przewagę.
Bo pokazują, zamiast tłumaczyć.
Tradycyjny podręcznik do AI zaczyna od równań. Potem przechodzi do kodu. Potem - jeśli masz szczęście - dostaniesz diagram.
Alammar odwraca tę kolejność. Zaczyna od obrazka. Pokazuje, jak dane przepływają przez model. Dopiero potem - jeśli chcesz - możesz zagłębić się w matematykę.
Alammar zrobił dla uczenia maszynowego to, co 3Blue1Brown robi dla matematyki - zamienił abstrakcyjne pojęcia w rysunki, które da się śledzić krok po kroku. Wpis o BERT przetłumaczono na chiński, francuski (dwa tłumaczenia), japoński, koreański, perski, rosyjski i hiszpański. Alammar jest też współautorem książki „Hands-On Large Language Models”.
BERT nie jest już najnowszym modelem, ale jego pomysły żyją w dwóch miejscach.
Po pierwsze, schemat „najpierw trening na ogromnym zbiorze tekstu, potem dostrajanie” stał się standardem także dla modeli, które piszą teksty. Po drugie, rodzina enkoderów rozwija się dalej. RoBERTa (2019) pokazała, że BERT był niedotrenowany i że bez zadania o kolejności zdań wyniki są takie same albo nieco lepsze. ModernBERT (grudzień 2024) trenowano na 2 bln tokenów z oknem 8192 tokenów zamiast 512. Dla polskiego jest wielojęzyczny BERT od Google (104 języki, w tym polski) i HerBERT (2021) - polski model oparty na BERT.
Czego czaty od BERT nie przejęły? Dwukierunkowości. Modele generujące tekst czytają tylko wstecz, bo piszą odpowiedź słowo po słowie. Dlatego do klasyfikacji i wyszukiwania wciąż sięga się po enkodery - autorzy ModernBERT piszą, że dają one bardzo dobry stosunek jakości do wielkości w porównaniu z dużo większymi modelami generującymi.
Jeśli chcesz zdobyć kompetencje AI, których szukają pracodawcy, zrozumienie różnicy między modelem, który rozumie tekst, a modelem, który go pisze, pomoże Ci dobierać narzędzia do zadań. Jak ten podział wygląda w praktyce, pokazujemy w poradniku jak transformery AI rozwiązują zadania.
Nie potrzebujesz wiedzy technicznej. Nie musisz programować. Kilka rzeczy ułatwi Ci naukę:
Jeśli dopiero zaczynasz przygodę z AI, warto najpierw przejść przez podstawy. Wpis Alammara jest przystępny, ale zakłada, że wiesz, czym jest model językowy i po co się go trenuje.
Jeśli potrzebujesz uporządkowanej ścieżki nauki, przewodnik po czytaniu papers z AI pomoże Ci zrozumieć żargon, który pojawia się w takich materiałach.
To potoczna nazwa użycia modeli BERT w wyszukiwarce Google. Od października 2019 roku Google używa ich, żeby lepiej rozumieć zapytania i dobierać wyniki oraz wyróżnione fragmenty z odpowiedzią. Sam BERT to model językowy z 2018 roku, który czyta tekst w obie strony naraz. W przewodniku Google Search Central po systemach rankingowych BERT nadal jest wymieniony (odczyt 13.10.2026).
Nie. Wpis Jaya Alammara „The Illustrated BERT” jest napisany tak, żeby osoby bez technicznego przygotowania mogły zrozumieć mechanizmy. Rysunki pokazują, jak model przetwarza tekst - bez linii kodu. Jeśli chcesz potem eksperymentować z kodem, to już inna sprawa - do zrozumienia koncepcji programowanie nie jest potrzebne.
Tak, choć nie w czatach. BERT i jego następcy (m.in. RoBERTa, ModernBERT, polski HerBERT) służą do klasyfikacji tekstu, wyszukiwania i wyciągania informacji. Model bert-base-uncased pobrano z Hugging Face ponad 34 mln razy w ostatnich 30 dniach (odczyt 13.10.2026), a Google wciąż wymienia BERT wśród systemów rankingowych wyszukiwarki. Do pisania tekstów służą modele generujące - na 13.10.2026 czołowe to m.in. rodzina GPT-6, Claude Opus 5.5 i Gemini 3.1 Pro.
Podstawy tak: enkoder, mechanizm atencji i maskowanie słów działają tak, jak na rysunkach. Zmieniło się sporo szczegółów. Modele generujące tekst czytają tylko wstecz, w wielu otwartych modelach dawne kodowanie pozycji zastąpiło RoPE, a okno kontekstu urosło z 512 tokenów w BERT do 1 mln w obecnych modelach Claude (stan na 13.10.2026). Sam Alammar zamroził bloga i publikuje teraz na Substacku.
Wizualizacje Jaya Alammara to dobry punkt startu - pokazują mechanizmy bez matematyki. Jeśli wolisz uporządkowaną ścieżkę, sprawdź nasz kurs AI Evolution (sukcesai.com/kurs). Jeśli wolisz wideo, 3Blue1Brown ma serię lekcji o sieciach neuronowych. Przegląd kursów o modelach językowych znajdziesz w tekście jak znaleźć najlepsze kursy o dużych modelach językowych. A jeśli chcesz eksperymentować - ChatGPT i Claude pozwalają testować koncepcje w praktyce.
Ten poradnik to dopiero początek. W naszym kursie AI Evolution nauczysz się korzystać z ChatGPT, Claude i innych narzędzi AI w sposób systematyczny - od zera do zaawansowanego poziomu.
Sprawdź kurs →BERT to model Google z 2018 roku, który czyta tekst w obie strony i uczył się przez zgadywanie zamaskowanych słów. Od 2019 roku pomaga wyszukiwarce Google rozumieć zapytania. Nie wymyślił transformera, ale spopularyzował schemat „trenuj wstępnie, potem dostrajaj”, z którego korzystają też dzisiejsze czaty. Jay Alammar we wpisie „The Illustrated BERT” pokazuje te mechanizmy rysunkami - bez matematyki i bez kodu.
Nie musisz być programistą, żeby to zrozumieć. Musisz być ciekawy, jak AI przetwarza język - i mieć pół godziny na przeczytanie wpisu.
Otwórz wpis Jaya Alammara „The Illustrated BERT” (link w źródłach poniżej) i przewiń do sekcji „Masked Language Model”. Zakryj podpis pod rysunkiem i spróbuj własnymi słowami powiedzieć, co model ma odgadnąć i na podstawie czego. Potem zrób to samo z rysunkiem drugiego zadania - o kolejności zdań. To 5 minut, po których BERT przestaje być czarną skrzynką.
Na podstawie: The Illustrated BERT, ELMo, and co. - Jay Alammar, Devlin i in. - BERT: Pre-training of Deep Bidirectional Transformers (2018), Google - Understanding searches better than ever before (2019), Google Search Central - A guide to Google Search ranking systems, Liu i in. - RoBERTa (2019), Warner i in. - ModernBERT (2024), Google Research - Multilingual BERT, Mroczkowski i in. - HerBERT (2021), Hugging Face - google-bert/bert-base-uncased, Jay Alammar - Interfaces for Explaining Transformer Language Models, Anthropic - Glossary, DeepSeek - karta modelu DeepSeek-V4-Pro
Darmowy webinar na żywo z Janem Gajosem · w najbliższą środę o 19:00
Czytasz o AI, a w pracy dalej robisz wszystko ręcznie? Znam to.
Sam tak robiłem. Na webinarze pokazuję na swoim ekranie, jak oddać AI powtarzalne zadania: maile, proste automatyzacje, asystenta do pracy. Bez programowania i bez teorii. 90 minut, a na końcu pytasz, o co chcesz.
Link do pokoju przyjdzie mailem. Zapisując się, zgadzasz się na wiadomości e-mail zgodnie z polityką prywatności. Wolisz zacząć od lektury? Zobacz e-booki Jana Gajosa
Fine-tuning modelu BERT to jak nauczenie go Twojego branżowego żargonu. Pokazuję, jak to zrobić bez kodowania - krok po kroku, z konkretnymi narzędziami.
BPE to algorytm, który uczy modele AI czytać tekst. Bez niego GPT-5 czy Claude nie rozumieliby ani słowa. Oto jak to działa - bez matematyki.
Chcesz zrozumieć, jak naprawdę działają duże modele językowe? Zbuduj swój własny - krok po kroku, bez magii. Przewodnik dla osób bez doświadczenia w programowaniu.
Stable Diffusion to nie czarna magia. To system kilku współpracujących modeli. Dowiedz się, jak tekst zamienia się w obraz - krok po kroku, bez technicznego żargonu.
Poznaj krok po kroku, jak powstaje tokenizator AI - od normalizacji tekstu, przez WordPiece, BPE i Unigram, aż po gotowy model do treningu.

Poznaj trzy architektury transformerów (encoder, decoder, encoder-decoder) i dowiedz się, dlaczego BERT, GPT-2 i BART rozwiązują różne zadania inaczej.